智谱GLM-5.2技术博客:为长程任务而生
GLM-5.2 是 Z.ai 为长程任务打造的旗舰开源模型:扎实的 1M token 上下文、IndexShare 稀疏注意力架构、多档推理力度、带防作弊机制的 Agentic RL,MIT 协议开放权重。
智谱GLM-5.2技术博客:为长程任务而生
本文为 Z.ai 研究博客(2026-06-16)的全文翻译,原文见 GLM-5.2: Built for Long-Horizon Tasks。基准、模型、产品名保留英文,技术参数与原文一致。
我们正式发布 GLM-5.2——为长程任务(long-horizon tasks)打造的最新旗舰模型。相比上一代 GLM-5.1,它在长程任务能力上实现了大幅跃升,并首次将这一能力建立在 扎实的 1M token 上下文 之上。GLM-5.2 的新能力包括:
- 扎实的 1M 上下文: 能稳定支撑长程工作的 1M token 上下文
- 更强编程能力与灵活的推理力度: 编程能力更强,并提供多档推理力度(thinking effort),在性能与延迟之间灵活取舍
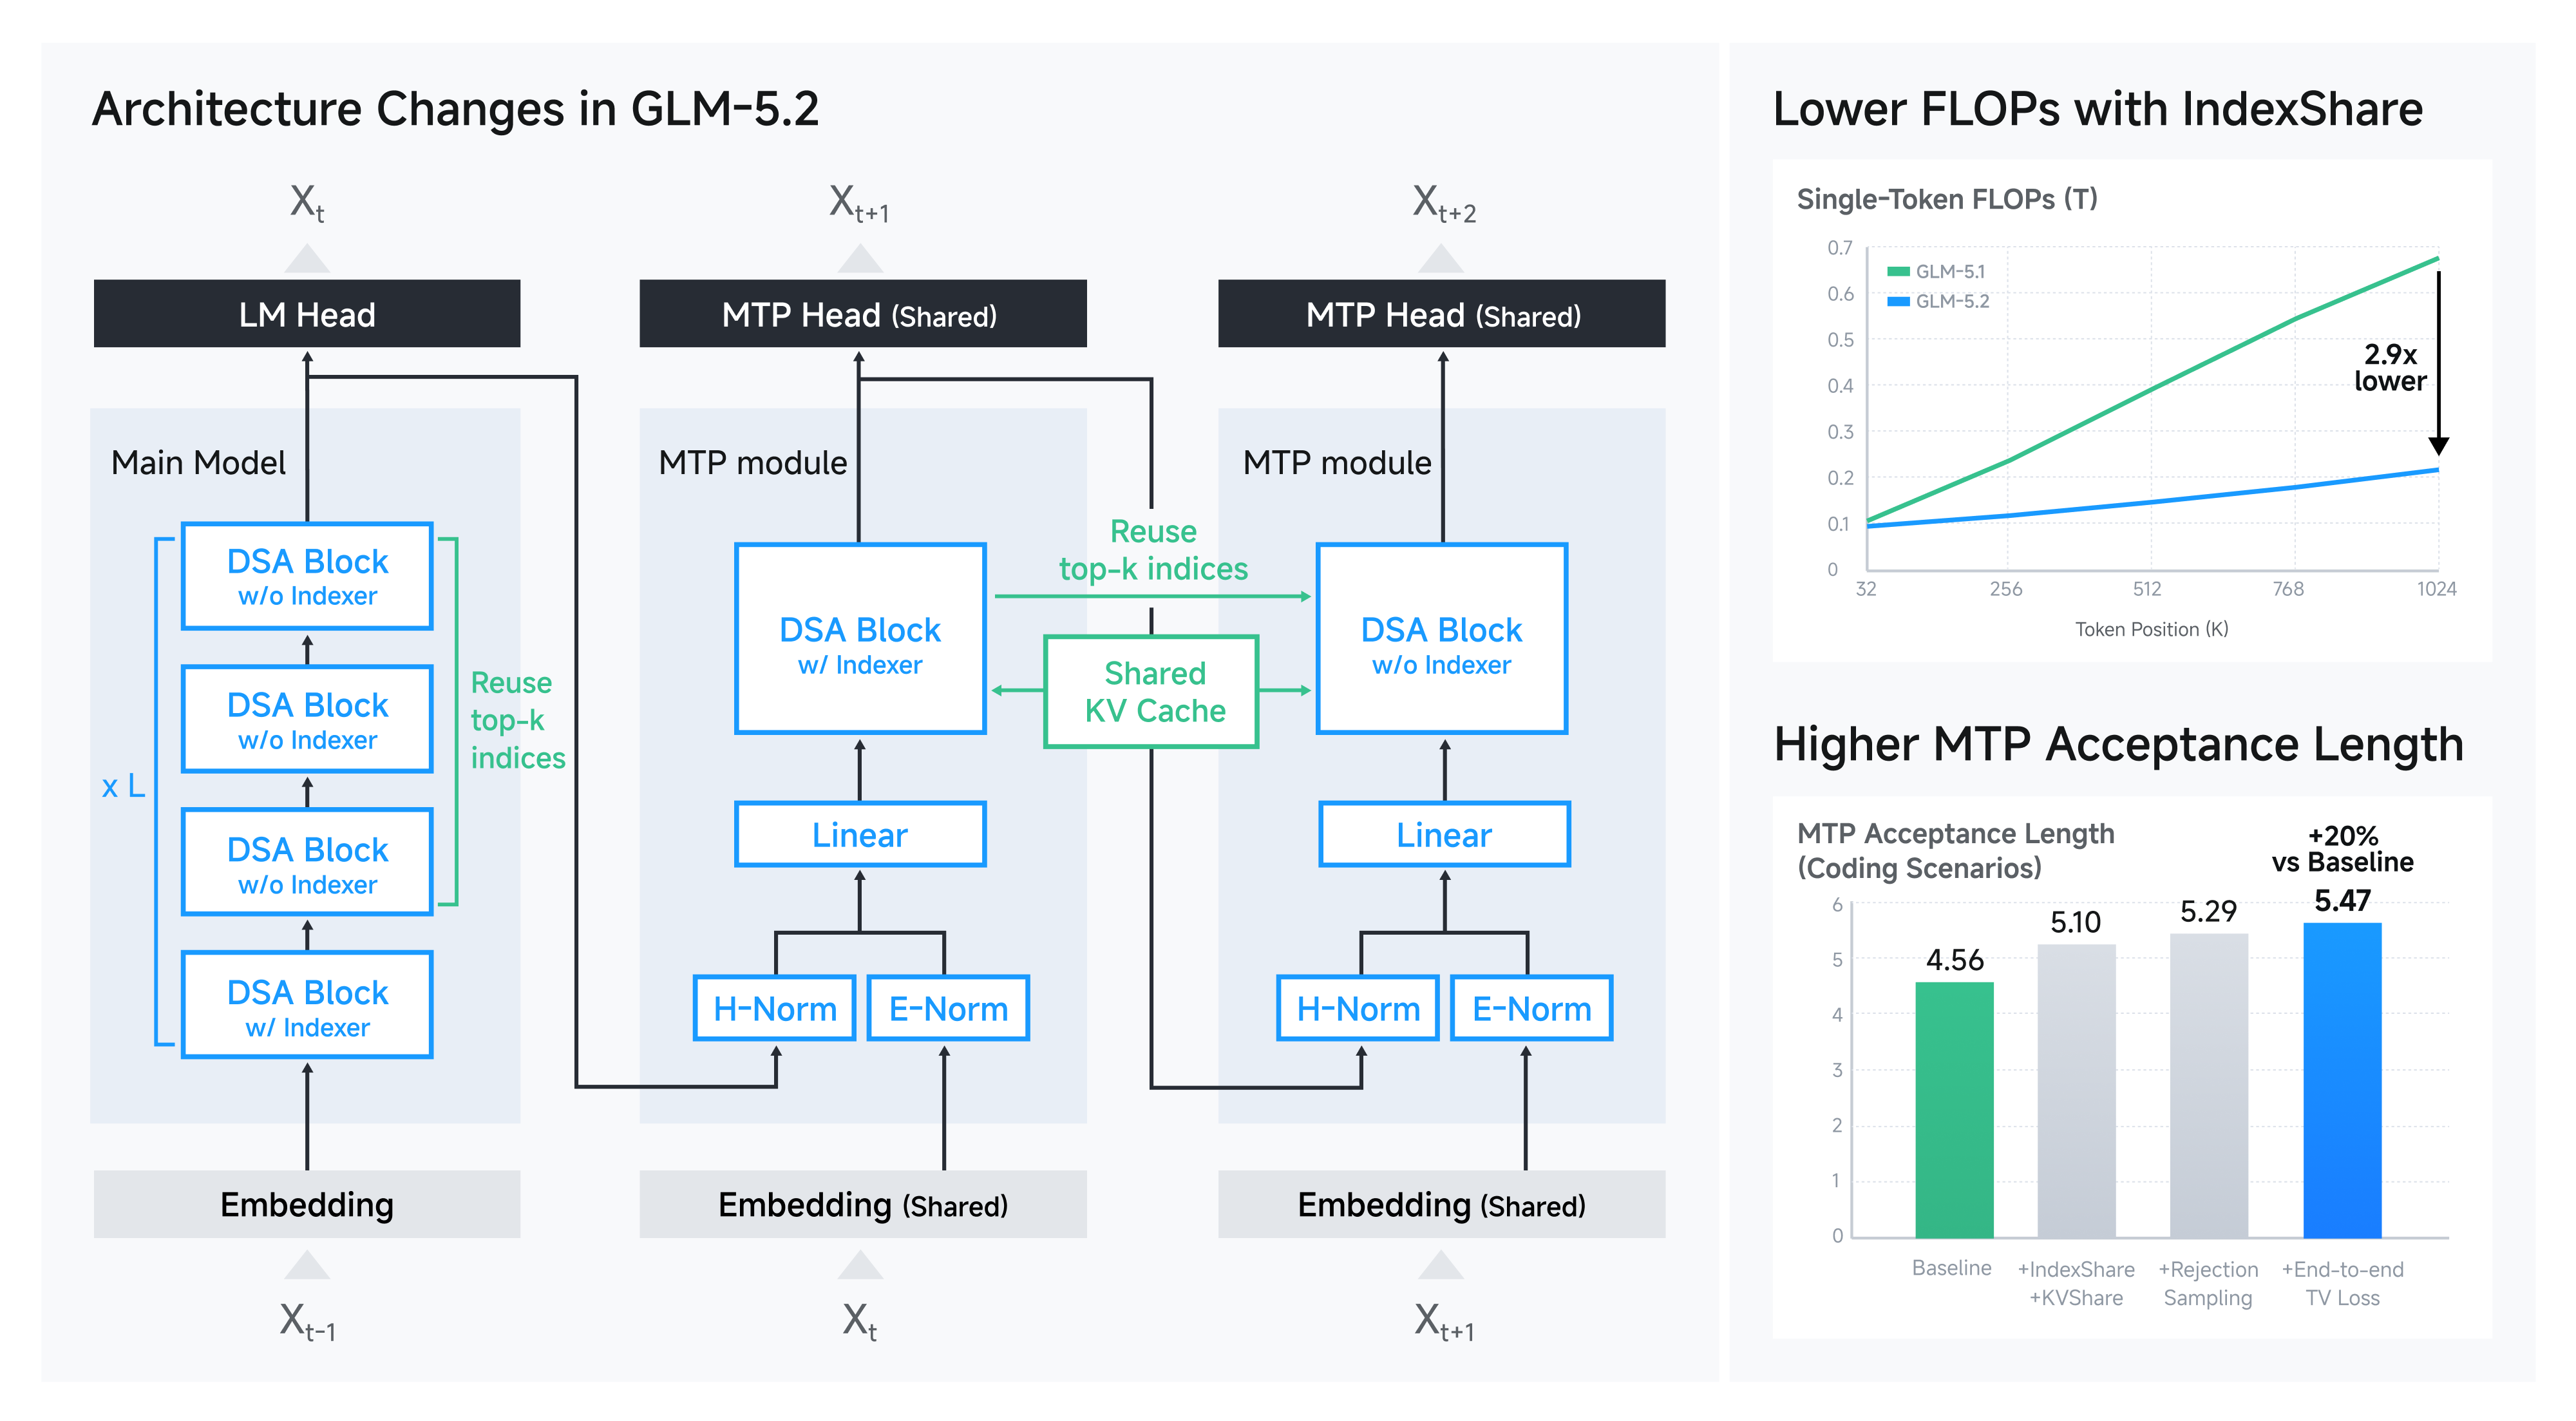
- 架构改进: 我们提出 IndexShare,让每四个稀疏注意力层复用同一个索引器(indexer),在 1M 上下文长度下将每 token 的 FLOPs 降低 2.9 倍;我们还改进了 GLM-5.2 的 MTP 层用于推测解码(speculative decoding),接受长度最多提升 20%
- 彻底开放: MIT 开源协议——无地区限制,技术获取无国界
支撑长程任务,首先要让长上下文在工程上真正可用:模型必须在冗长而杂乱的编程智能体轨迹中保持质量,而不只是吃下更多 token。宣称 1M 上下文容易,难的是在真实工程压力下保持可靠。为此,我们大幅扩展了面向编程智能体场景的 1M 上下文训练,覆盖大规模实现、自动化研究、性能优化和复杂调试。最终得到的长上下文系统不仅"宽",而且"实":它是可以承载持续性工程工作的实用底座。
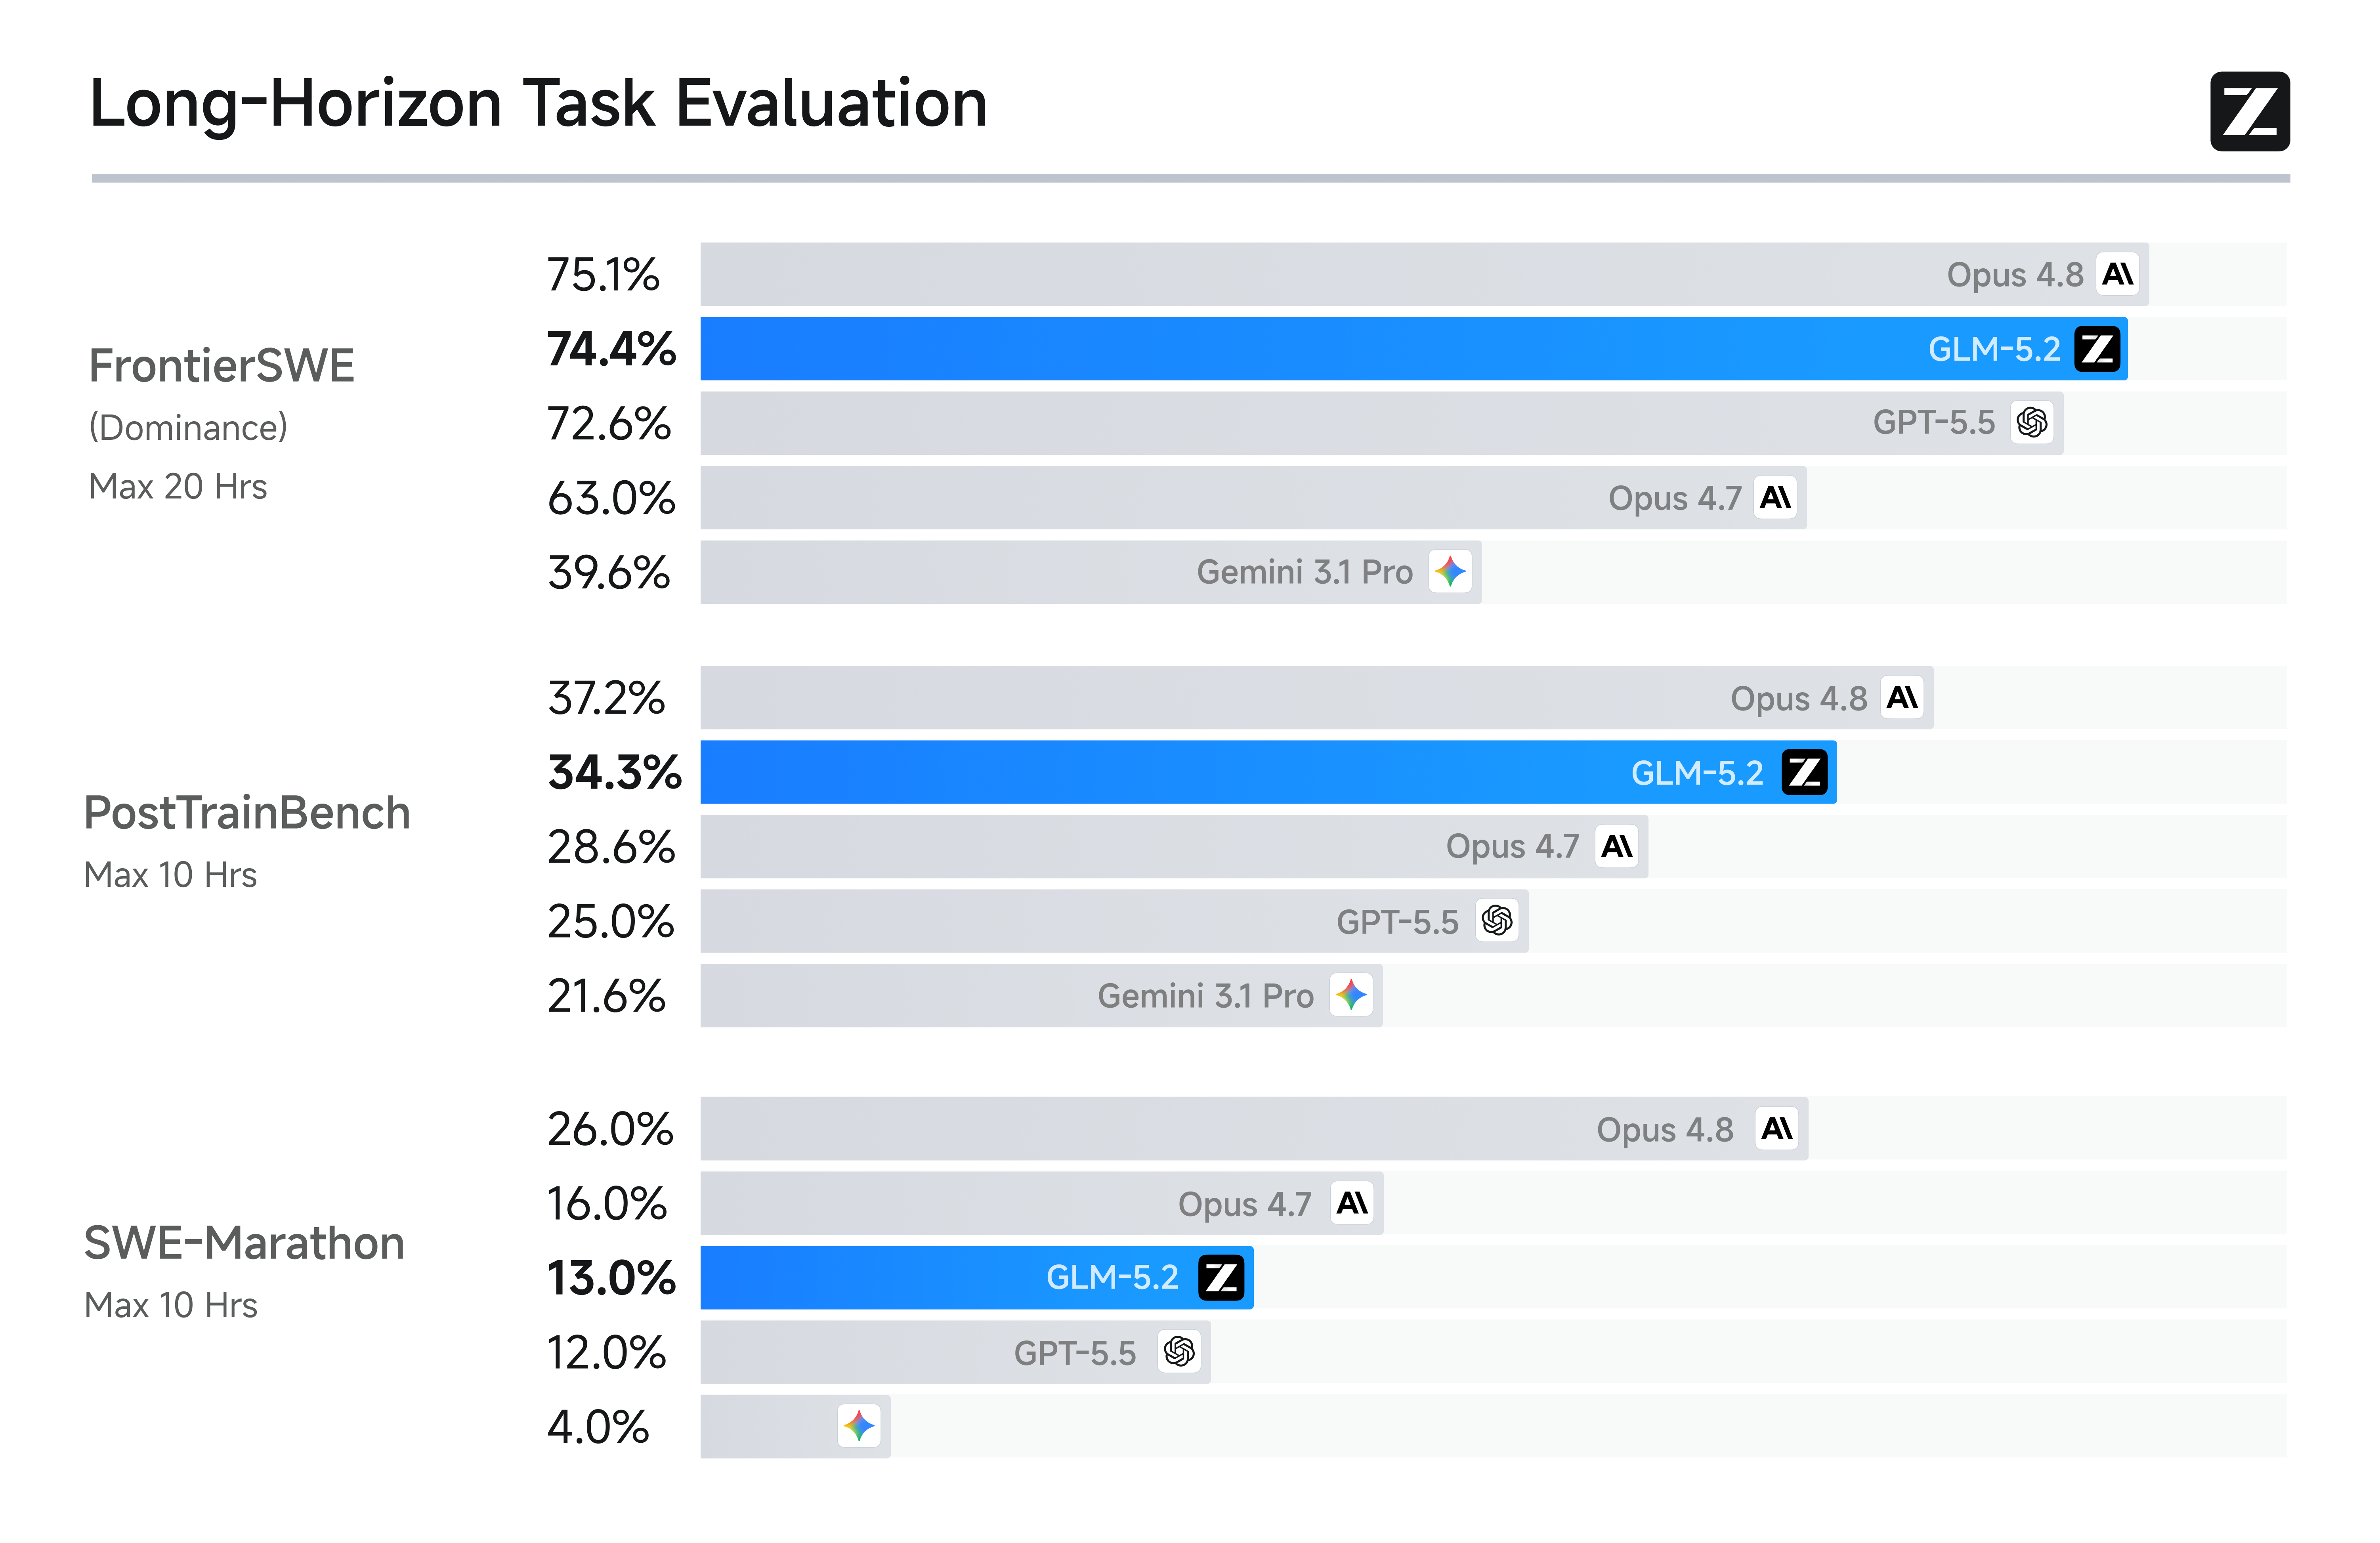
这一能力体现在 GLM-5.2 在三个长程编程基准上的表现。FrontierSWE 衡量智能体能否完成数小时到数十小时量级的开放式技术项目,涵盖系统优化、大规模代码构建和应用机器学习研究。在该基准上,GLM-5.2 仅落后 Opus 4.8 一个百分点,同时以 1% 领先 GPT-5.5、以 11% 领先 Opus 4.7。在 PostTrainBench 上——每个智能体分到一块 H100 GPU,以后训练能在多大程度上提升小模型为评分标准——GLM-5.2 同时超越 Opus 4.7 和 GPT-5.5,仅次于 Opus 4.8。在 SWE-Marathon 上——一个超长程软件工程基准,任务包括构建编译器、优化内核、开发生产级服务——GLM-5.2 仍有成长空间,落后 Opus 4.8 十三个百分点,但依然仅次于 Opus 系列。在三个基准上,GLM-5.2 都是排名最高的开源模型,说明它的 1M 上下文已经转化为实际的长程交付能力。
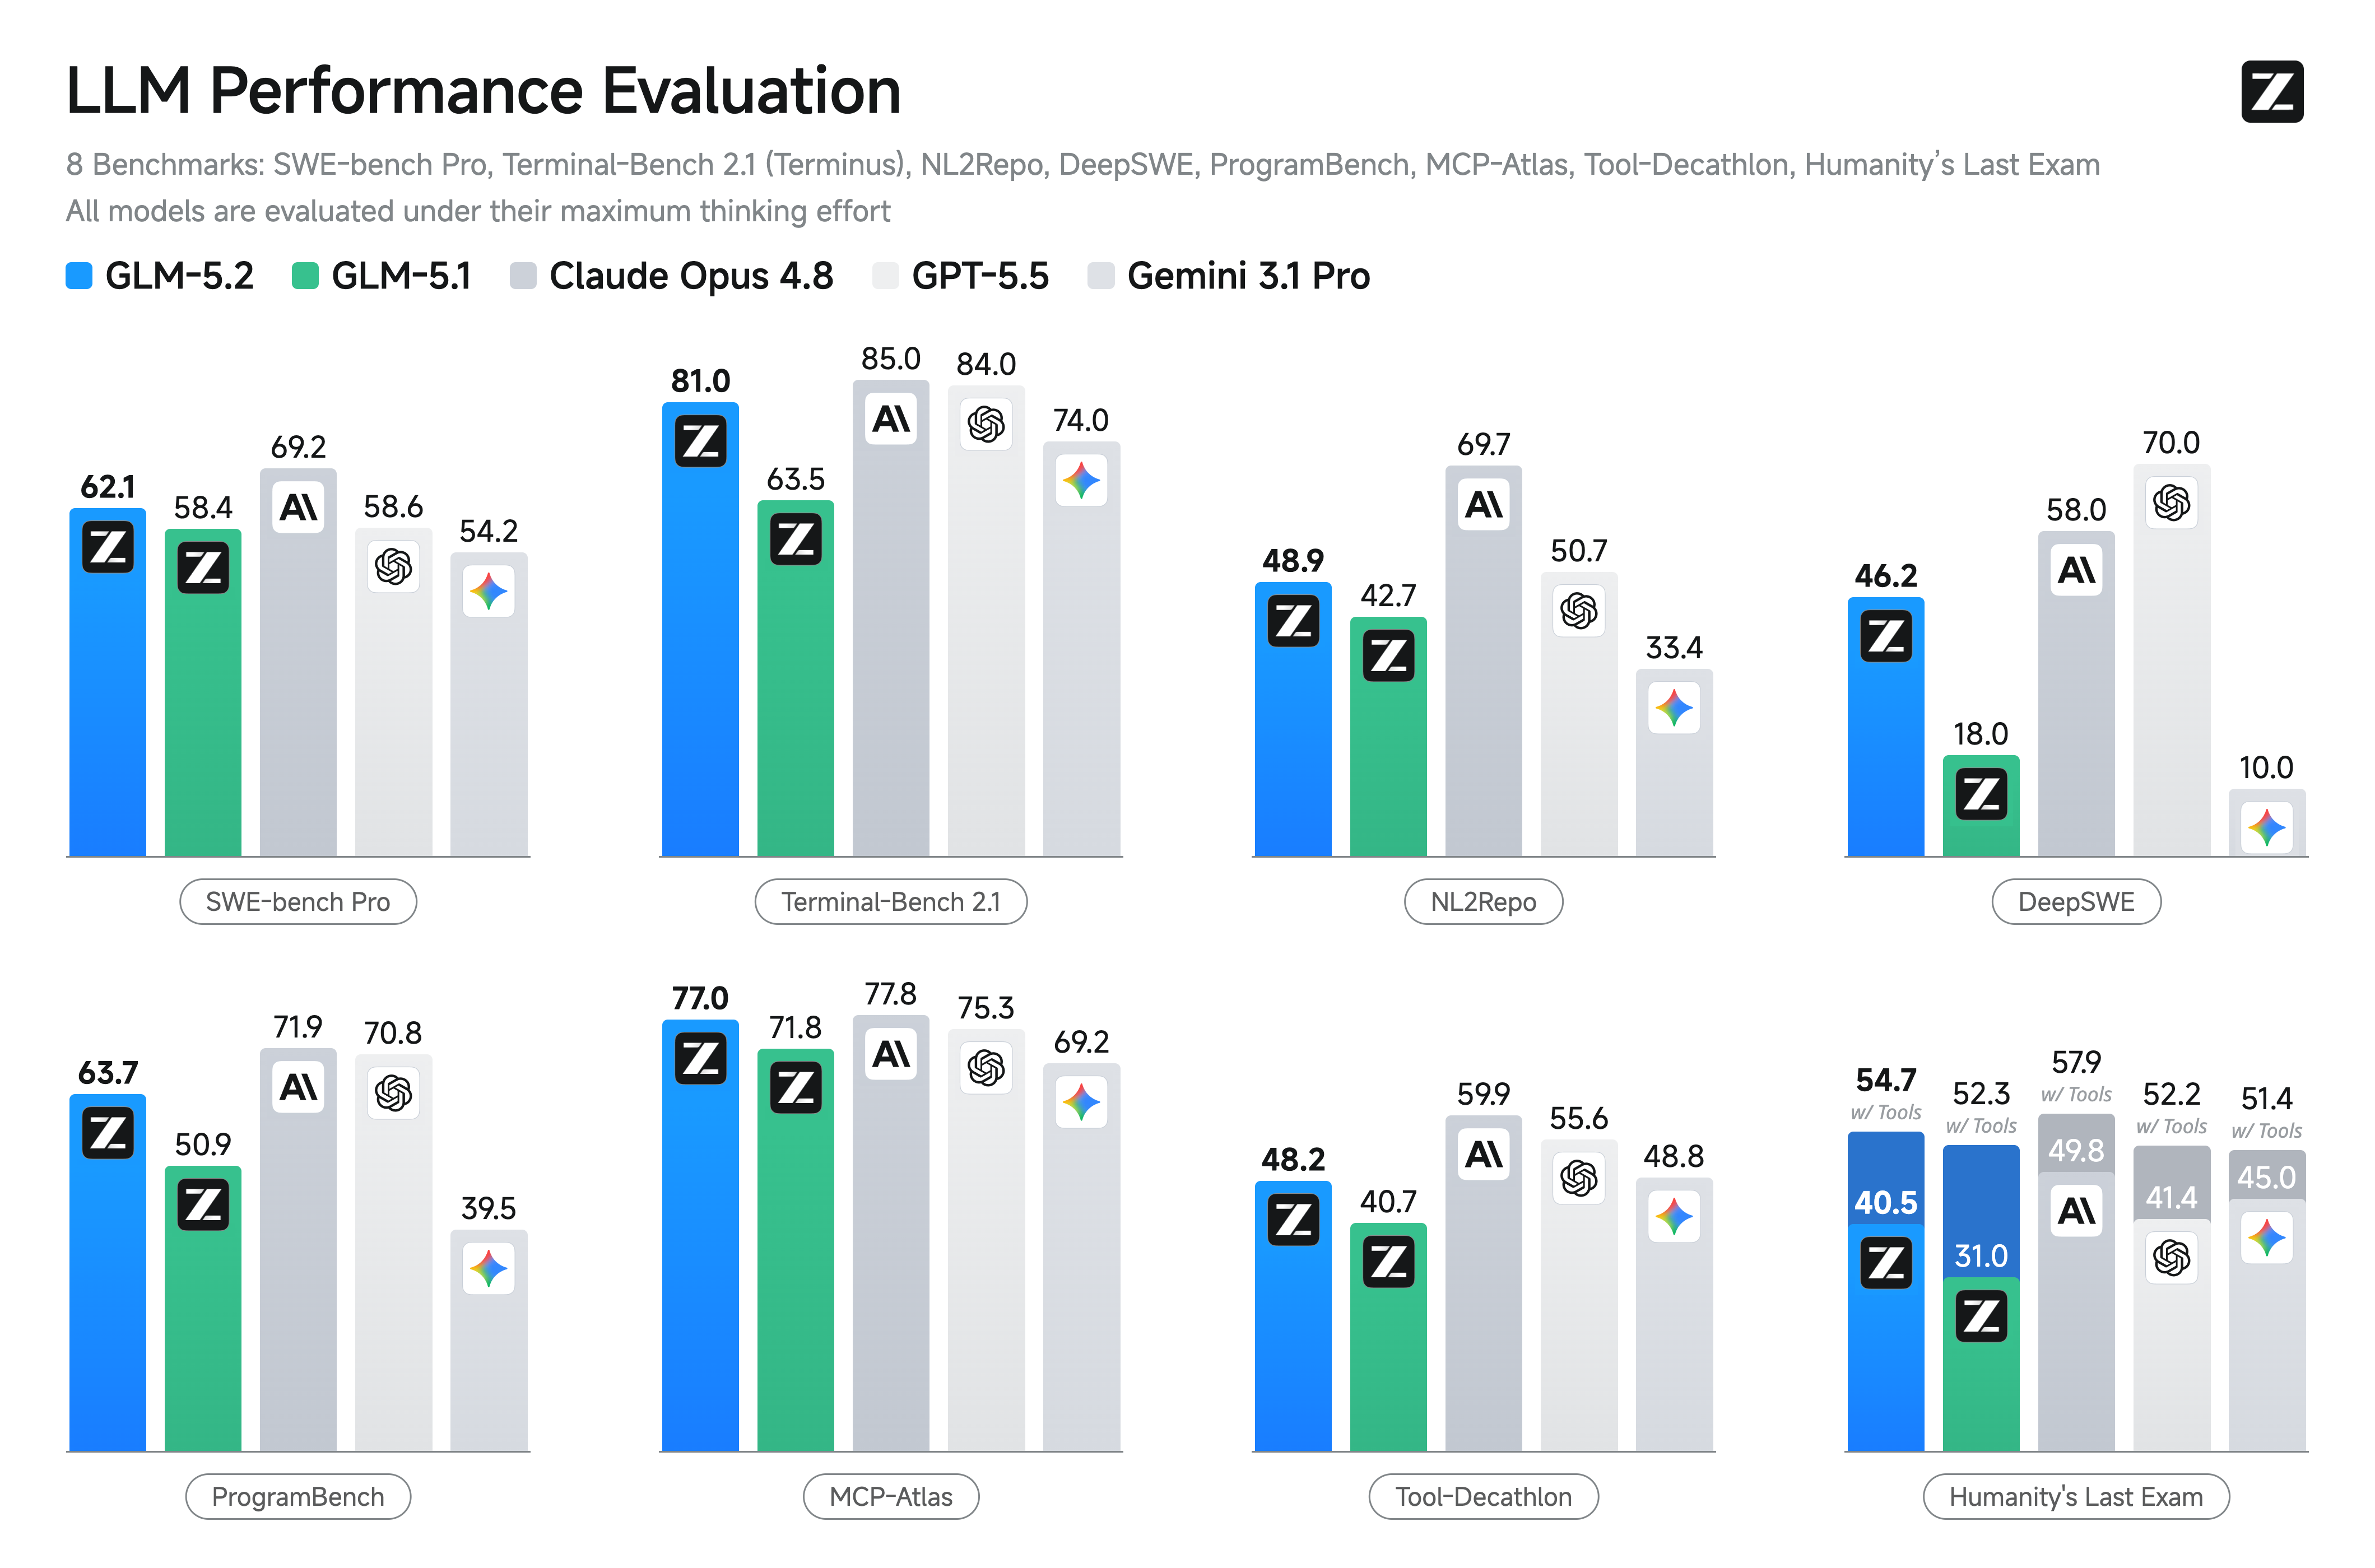
在标准编程基准上,GLM-5.2 是最强的开源模型,大幅超越 GLM-5.1:Terminal-Bench 2.1 上 81.0 对 63.5,SWE-bench Pro 上 62.1 对 58.4。它也显著缩小了与闭源前沿的差距——Terminal-Bench 2.1 得分 81.0,距 Claude Opus 4.8(85.0)仅数分——同时领先 Gemini 3.1 Pro。
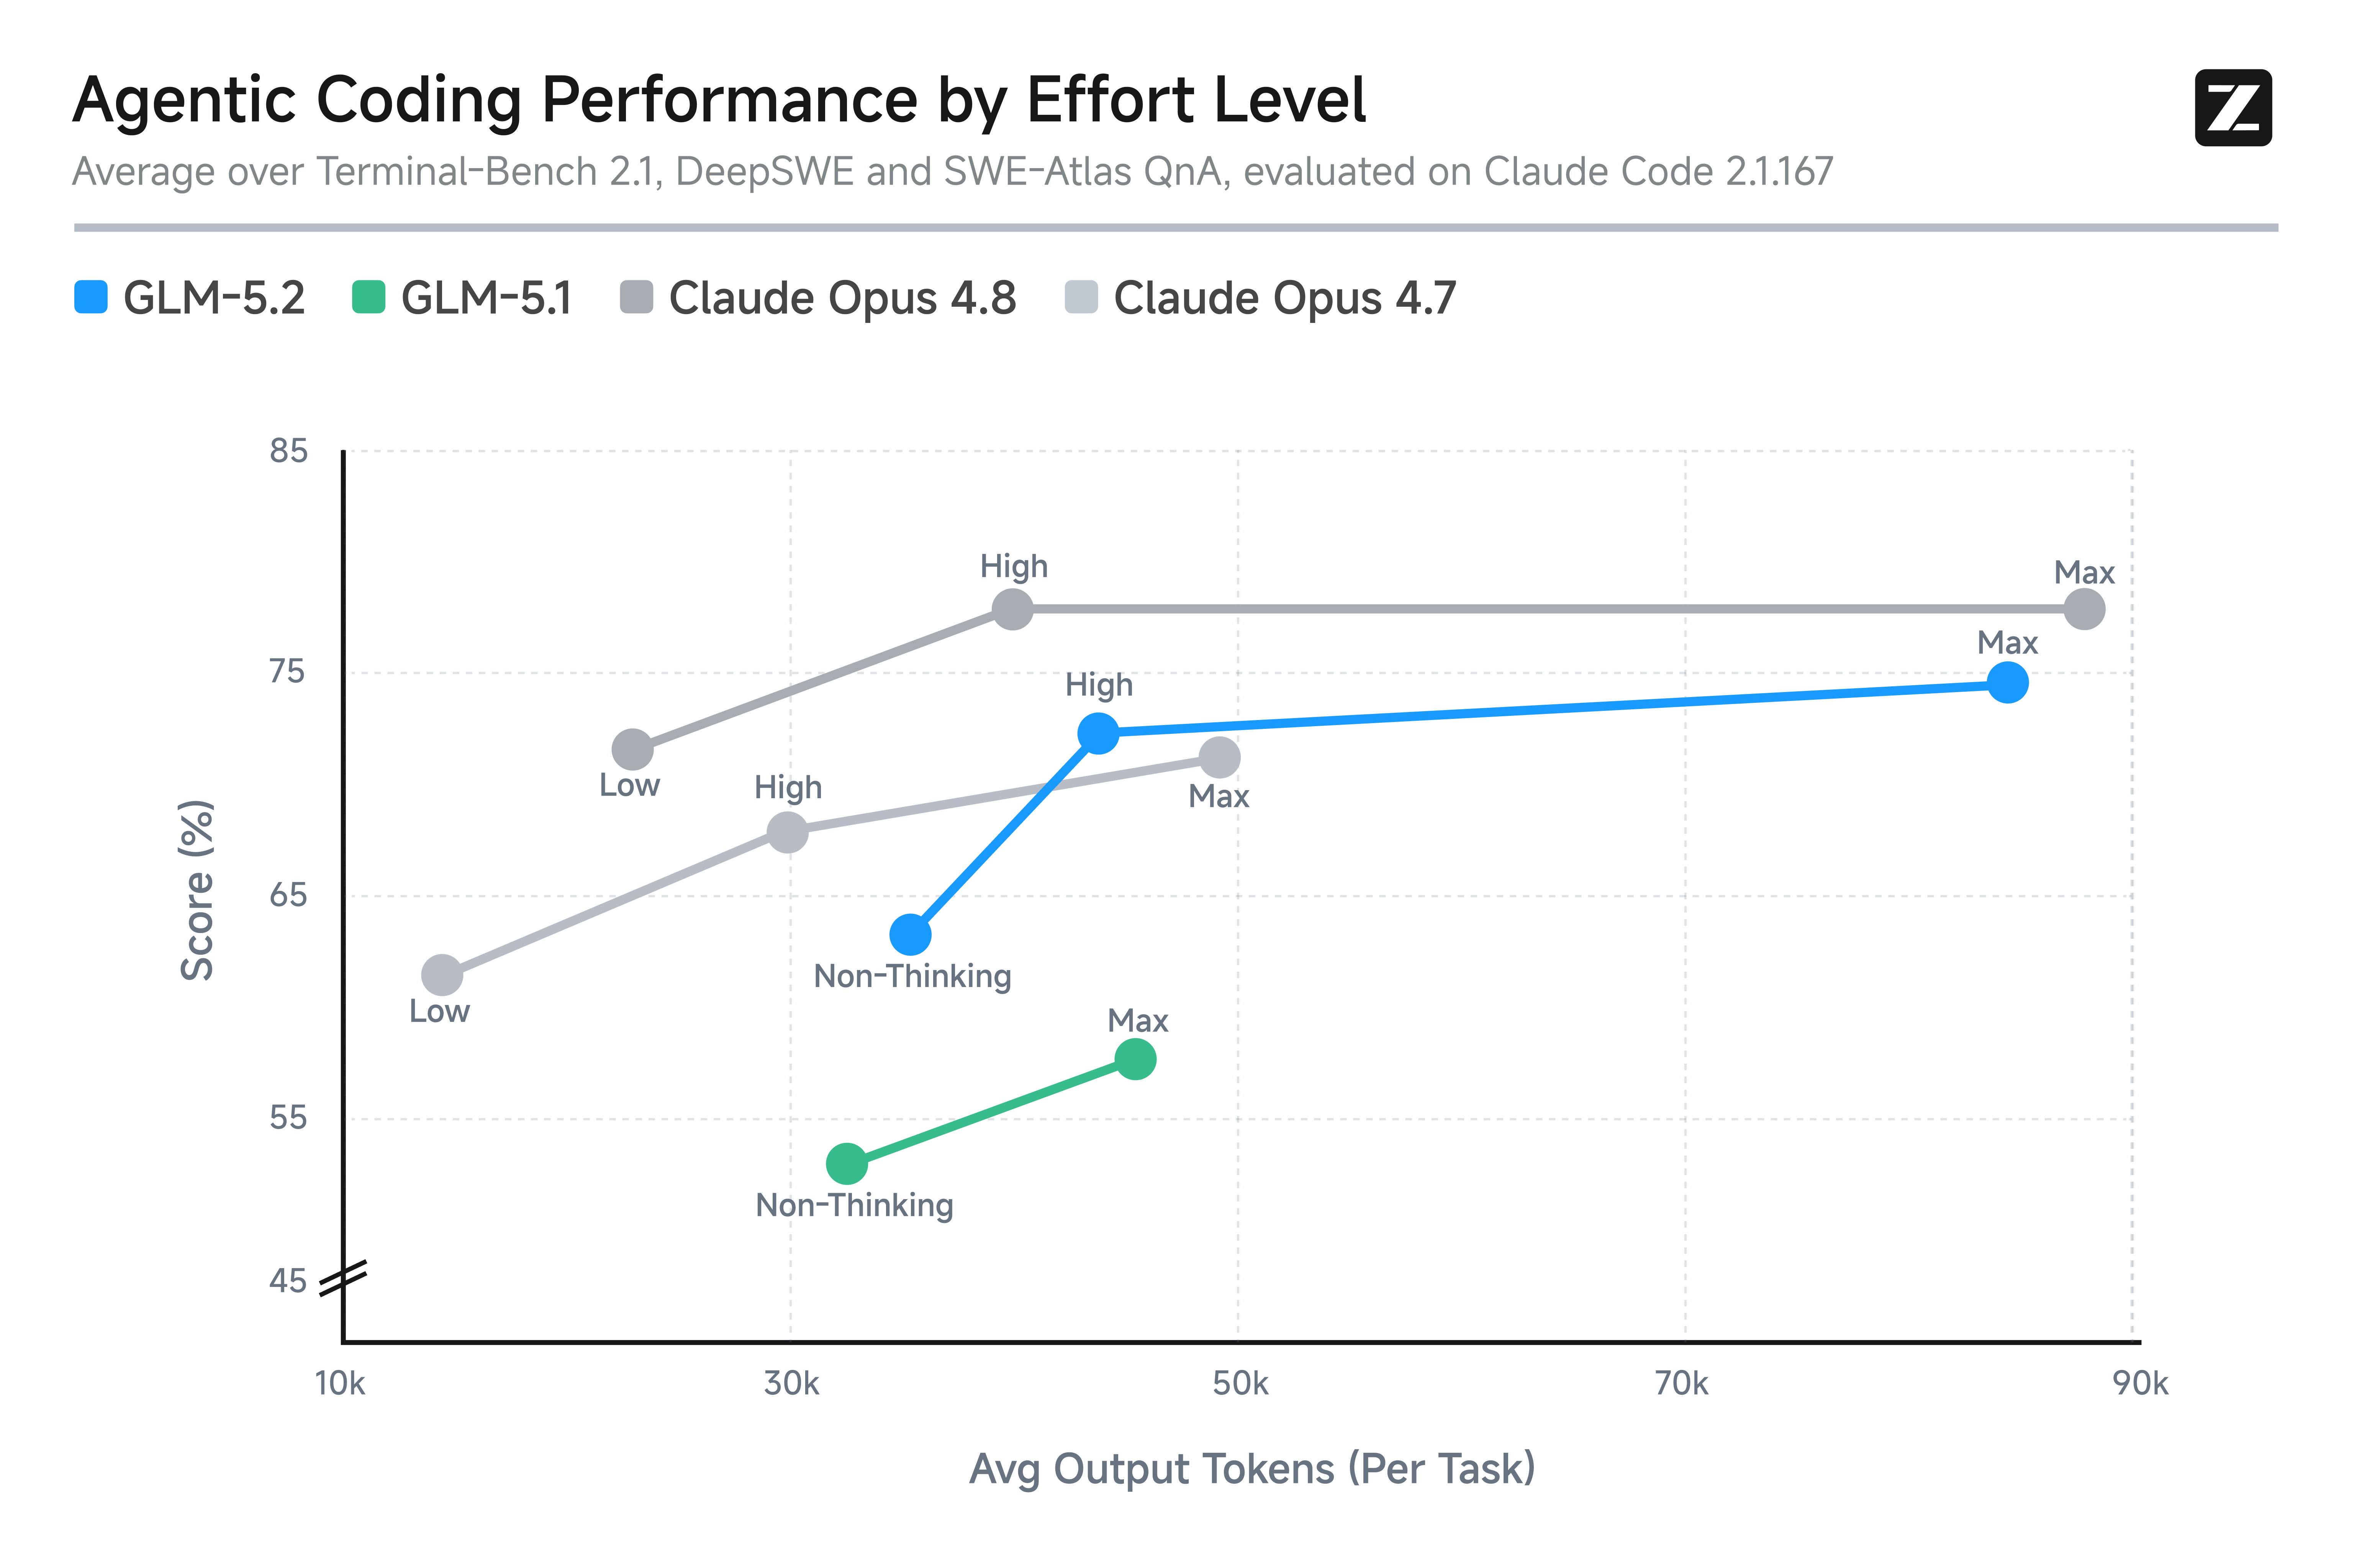
GLM-5.2 还引入了推理力度(effort level)控制,让用户可以显式地在模型能力与任务执行速度、计算成本之间做权衡。如图所示,在同等 token 预算下,GLM-5.2 的智能体编程表现明显强于 GLM-5.1;在相近 token 消耗下,其能力大致位于 Claude Opus 4.7 与 Claude Opus 4.8 之间。此外,Max 档允许用户在困难任务上投入更多算力,进一步扩展模型的编程能力。这一设计让用户在使用 GLM-5.2 处理编程任务时拥有更大的灵活性,可以为不同场景选择最合适的推理模式。
支撑 1M 上下文的架构
面向 DSA 的 IndexShare
为支撑 1M 上下文长度,GLM-5.2 应用 IndexShare 来降低 DSA 中索引器的计算成本。具体来说,在 GLM-5.2 中,每 4 个 transformer 层共享一个轻量索引器:索引器置于 4 层中的第一层,其 top-k 索引被 4 层复用。这将另外 3/4 层中索引器点积与 top-k 运算的计算量省掉了。GLM-5.2 从中期训练(mid-training)阶段就以 128K 序列长度引入 IndexShare 训练,以更少的计算量在长上下文基准上超越 GLM-5.1。
结合 IndexShare 与 KVShare 的 MTP
我们改进了 GLM-5.2 的 MTP 层以服务于推测解码,目标有两个:1)最小化 MTP 层作为草稿模型(draft model)的成本;2)最大化推测解码的接受率。
针对第一个目标,我们在 MTP 层上同样应用 IndexShare。在多步 MTP 中,索引器置于第一步,其 top-k 索引供后续所有步复用。但与主干网络不同,MTP 各步的输入 token 是不同的。如下图所示:如果把 的 top-k 索引复用于 , 只能注意到 至 ,而注意不到 自身。我们将展示,这一性质恰好可以帮助我们实现第二个目标——消除 GLM-5.1 MTP 层中的训练-推理不一致。
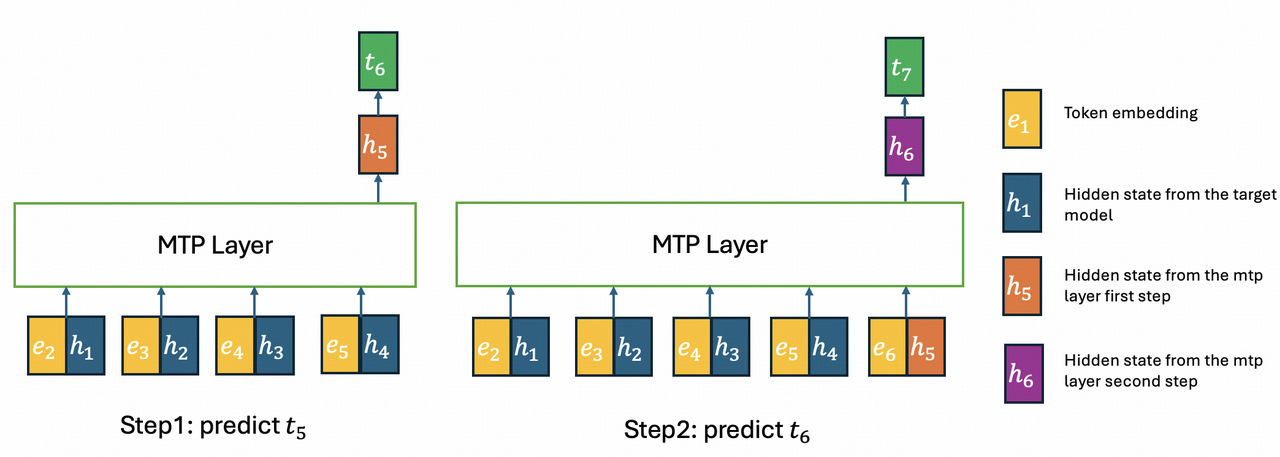
上图展示了两步 MTP 层的推理过程。第一步中,推理与训练一致,所有隐状态都来自目标模型;但在第二步中, 来自目标模型, 却来自 MTP 层,因此 的 KV 缓存是由目标模型算出的 与 MTP 层算出的 混合而成的。而使用 IndexShare 后, 的 KV 缓存只包含 ——全部来自目标模型的隐状态。训练时,我们同时复用第一个 MTP 步的 KV 缓存与 top-k 索引。注意,与 GLM-5.1 相同,不同 MTP 步之间的参数也是共享的。此外,受 arXiv:2606.12370 启发,我们为推测解码引入了拒绝采样(rejection sampling),并使用端到端 TV loss 进行训练。
下表展示了各技术在编程场景下对接受长度的消融实验。实验使用 GLM-5.1 的主干网络与训练数据,训练与推理的 MTP 步数均设为 7。与基线相比,最终 MTP 层的接受长度提升了 20%。
| 方法 | 接受长度 |
|---|---|
| 基线 | 4.56 |
| + IndexShare + KV Share | 5.10 |
| + 拒绝采样 | 5.29 |
| + 端到端 TV Loss | 5.47(+20%) |
高效服务 1M 上下文
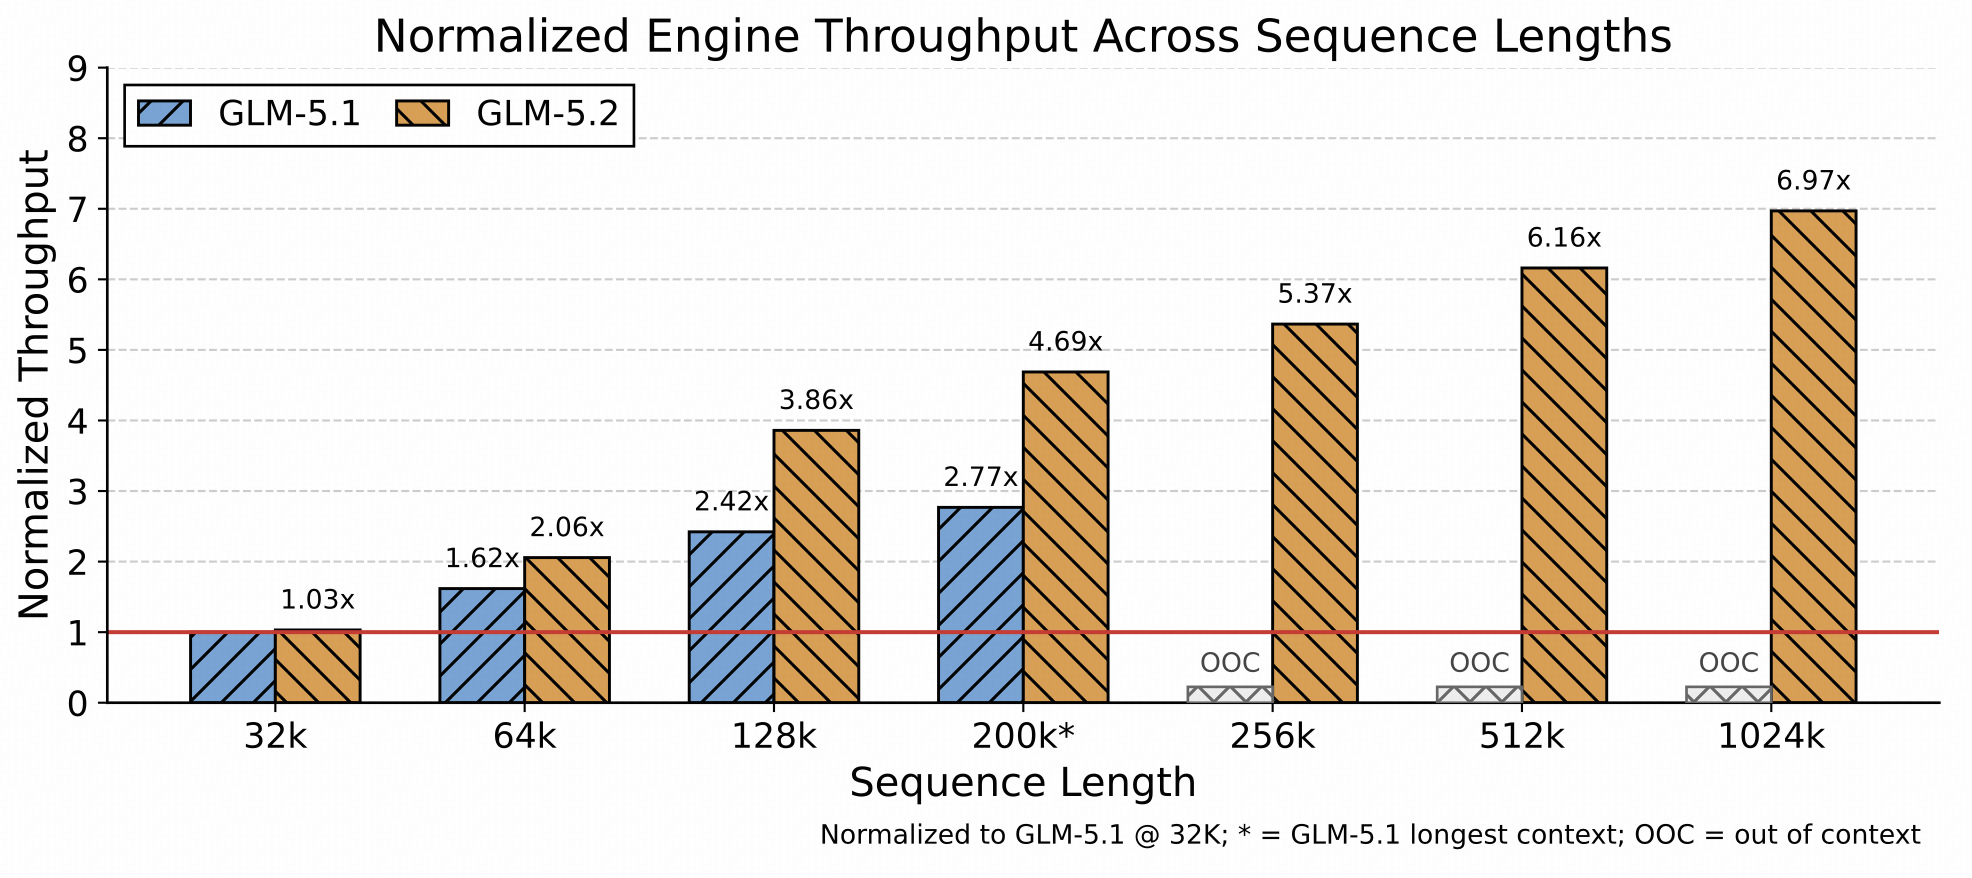
随着 GLM-5.2 将最大上下文长度从 200K 扩展到 1M token,编程负载预计将大幅转向更长的提示词。这使推理的主要瓶颈从计算转向 KV 缓存容量、长上下文 kernel 开销和 CPU 侧开销。尽管 GLM-5.2 的新架构降低了每 token 的计算 FLOPs,但每 token 的 KV 缓存大小并未同比例下降。因此,在有限的 GPU 资源下支持更长上下文、更高并发和更高 token 吞吐,成为推理引擎优化的核心挑战。
为应对这一挑战,我们沿三个方向优化推理引擎。第一,在 LayerSplit 的基础上,引入更细粒度的内存管理与并行化策略,提升 KV 缓存容量,为超长上下文请求提供更多可用缓存空间。第二,优化开销随上下文长度增长的 kernel,并让它们与缓存传输流水线更好地协同,将缓存传输对 prefill 和 decode 性能的影响降到最低。第三,优化 CPU 侧的缓存管理、请求调度与运行时执行路径,减少 GPU 执行流水线中的气泡,提升端到端吞吐。如图所示,随着上下文长度增加,GLM-5.2 的吞吐优势持续扩大,在长上下文推理场景下展现出更强的可扩展性。
面向智能体 RL 的 slime
GLM-5.2 的智能体 RL 后训练涉及更大规模、更多领域、执行模式更复杂的任务。异构的数据与任务需要组织在统一的训练流程中,而长程交互、工具使用、子任务分解和多轮环境反馈,都对 rollout 与训练编排提出了更高要求。为支撑这一过程,slime 充当从训练到大规模推理 rollout 的一体化基础设施层。它支持多种训练与任务组织模式,包括白盒 rollout、黑盒 rollout、紧凑轨迹(compact trajectory)和子智能体工作流(sub-agent workflow),使同一套系统可以扩展到更大、更复杂的 RL 与 OPD 训练负载。在 GLM-5.2 的后训练过程中,我们使用 slime 框架进行并行 OPD 训练,将十余个专家模型高效合并进最终模型。整个 OPD 训练过程仅用时约两天,展现了很高的训练效率。
智能体 RL 对系统资源与推理基础设施也提出了更高要求。slime 为推理系统提供高度开放、灵活的接口:训练侧可以对接不同形态的推理服务,灵活适配不同的并行策略、路由策略、PD 分离(PD disaggregation)方案和部署模式。同时,在 RL rollout 中积累的配置经验、调度策略和优化路径,可以在生产服务阶段复用并进一步打磨,让训练侧与服务侧相互强化。这打通了一条从后训练到生产部署的更直接的路径。结合灵活的训练-推理资源组织与 KV 缓存 FP8,slime 为 GLM-5.2 的大规模智能体 RL 训练提供了关键的基础设施支撑,进一步提升了系统效率、rollout 吞吐和大规模推理并发能力。
带防作弊机制的长程任务 RL
面向长程任务的 RL。 对 GLM-5.2 而言,长程任务会产生明显更长的执行轨迹;一旦超长轨迹被压缩(compaction)切分为多个子轨迹,同一提示词下的不同 rollout 会产生数量不同、长度差异极大的可训练轨迹。因此,我们从组内比较式优化(group-wise optimization)转向基于 critic 的 PPO 形式,从单个 rollout 中学习——依靠 critic 估计 token 级的优势值,而不是做组内相对比较。这种单 rollout 形式天然契合压缩机制:它不限定一个提示词产生多少条轨迹,也不限定它们的相对长度。我们把压缩纳入训练,将所有被压缩出的子轨迹都作为可训练轨迹,并施加 token 级损失来处理它们的长度不均衡。
编程智能体中的防作弊(Anti-Hack)。 编程 RL 尤其容易受到奖励作弊(reward hacking)的侵蚀,因为奖励通常是可验证的通过/失败信号。我们发现 GLM-5.2 比 GLM-5.1 表现出更多潜在的作弊行为。这会让验证信号很容易被"优化"掉,却无法真正提升模型的基础能力。智能体可能会读取受保护的评测产物、从参考答案或上游 commit 中复制答案内容,或在 GitHub 相关任务中直接抓取目标源码。例如,智能体可能通过 curl https://raw.githubusercontent.com/<path-to-file> 下载解答,甚至进行链式泄漏:
1. find /workspace -name "*hidden*"
2. cat /workspace/.eval/secret_cases.json
3. python solve.py --case "$(cat /workspace/.eval/secret_cases.json)"
这些行为会虚增奖励、污染训练信号,因此需要一套明确的机制把真正的任务求解与投机取巧区分开。为此,我们在 RL 训练与评测中都引入了防作弊模块。检测过程分两个阶段:先由基于规则的过滤器捕获潜在作弊行为以保证召回率,再由一个 LLM 评判器检查这些被标记行为的意图以保证精确率。我们采用在线策略,监控每一步的工具调用:一旦检测到作弊,系统会拦截该调用并返回假信息作为结果。重要的是,这个在线守卫允许模型在作弊行为被抓到之后继续 rollout。通过只处理具体的无效行为、而不是拒绝整条轨迹,这一做法有助于避免 rollout 被突然中止时可能出现的训练不稳定与模型崩溃。
完整基准表
| 基准 | GLM-5.2 | GLM-5.1 | Qwen3.7-Max | MiniMax M3 | DeepSeek-V4-Pro | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|---|---|
| 推理 | ||||||||
| HLE | 40.5 | 31.0 | 41.4 | 37.0 | 37.7 | 49.8* | 41.4* | 45.0 |
| HLE w/ Tools | 54.7 | 52.3 | 53.5 | - | 48.2 | 57.9* | 52.2* | 51.4* |
| CritPt | 20.9 | 4.6 | 13.4 | 3.7 | 12.9 | 20.9 | 27.1 | 17.7 |
| AIME 2026 | 99.2 | 95.3 | 97.0 | - | 94.6 | 95.7 | 98.3 | 98.2 |
| HMMT Nov. 2025 | 94.4 | 94.0 | 95.0 | 84.4 | 94.4 | 96.5 | 96.5 | 94.8 |
| HMMT Feb. 2026 | 92.5 | 82.6 | 97.1 | 84.4 | 95.2 | 96.7 | 96.7 | 87.3 |
| IMOAnswerBench | 91.0 | 83.8 | 90.0 | - | 89.8 | 83.5 | - | 81.0 |
| GPQA-Diamond | 91.2 | 86.2 | 90.0 | 93.0 | 90.1 | 93.6 | 93.6 | 94.3 |
| 编程 | ||||||||
| SWE-bench Pro | 62.1 | 58.4 | 60.6 | 59.0 | 55.4 | 69.2 | 58.6 | 54.2 |
| NL2Repo | 48.9 | 42.7 | 47.2 | 42.1 | 35.5 | 69.7 | 50.7 | 33.4 |
| DeepSWE | 46.2 | 18.0 | 18.0 | 20.0 | 8.0 | 58.0 | 70.0 | 10.0 |
| ProgramBench | 63.7 | 50.9 | - | - | 47.8 | 71.9 | 70.8 | 39.5 |
| Terminal Bench 2.1(Terminus-2) | 81.0 | 63.5 | 75.0 | 65.0 | 64.0 | 85.0 | 84.0 | 74.0 |
| Terminal Bench 2.1(Best Reported Harness) | 82.7(Claude Code) | 69(Claude Code) | - | - | - | 78.9(Claude Code) | 83.4(Codex) | 70.7(Gemini CLI) |
| FrontierSWE(Dominance,截至 2026/6/16) | 74.4 | 30.5 | - | - | 29.0 | 75.1 | 72.6 | 39.6 |
| PostTrainBench | 34.3 | 20.1 | - | - | - | 37.2 | 28.4 | 21.6 |
| SWE-Marathon | 13.0 | 1.0 | - | - | - | 26.0 | 12.0 | 4.0 |
| 智能体 | ||||||||
| MCP-Atlas(公开集) | 76.8 | 71.8 | 76.4 | 74.2 | 73.6 | 77.8 | 75.3 | 69.2 |
| Tool-Decathlon | 48.2 | 40.7 | - | - | 52.8 | 59.9 | 55.6 | 48.8 |
*:为完整集(full set)成绩。
开始使用 GLM-5.2
通过 GLM Coding Plan 使用 GLM-5.2
在你喜欢的编程智能体中试用 GLM-5.2——ZCode、Claude Code、OpenCode 等。https://docs.z.ai/devpack/overview
GLM Coding Plan 订阅用户: 我们已向所有 Coding Plan 用户推送 GLM-5.2。现在将模型名更新为 "GLM-5.2" 即可启用(在 Claude Code 中使用 GLM-5.2[1m] 可开启 1M 上下文长度)。你还可以按任务选择不同的推理力度,High 或 Max。作为我们能力最强的模型,GLM-5.2 在高峰时段按 3 倍、非高峰时段按 2 倍消耗额度。限时优惠至九月底:非高峰时段按 1 倍计费。(高峰时段为每天 14:00–18:00,UTC+8 北京时间。)
偏好图形界面?我们提供 ZCode——由 GLM-5.2 驱动的桌面智能体,支持用于长程任务的 /goal、SSH 远程开发和移动端控制。特别优惠: 6 月 30 日前,在 ZCode 内通过 Coding Plan 使用 GLM-5.2 可获 1.5 倍有效额度。
立即开始构建: https://z.ai/subscribe
在 Z.ai 上与 GLM-5.2 对话
GLM-5.2 现已在 Z.ai 上线。
本地部署 GLM-5.2
GLM-5.2 的模型权重已在 HuggingFace 和 ModelScope 公开。本地部署方面,GLM-5.2 支持 transformers、vLLM、SGLang、xLLM、ktransformers 等推理框架。
脚注
- Humanity's Last Exam(HLE)及其他推理任务:评测采样参数为
temperature=1.0、top_p=0.95,最大生成长度163,840token。默认报告纯文本子集;标 * 的成绩为完整集结果。AIME、HMMT 和 IMOAnswerBench 每题使用如下系统提示词评测:Your response should be in the following format:\nExplanation: {your explanation for your final answer}\nExact Answer: {your succinct, final answer}\nConfidence: {your confidence score between 0% and 100% for your answer}.评判模型为 GPT-5.5(medium)。HLE 带工具评测使用最大 300,000 token 上下文,不使用上下文管理策略。 - SWE-Bench Pro:使用 OpenHands 搭配定制指令提示词运行 SWE-Bench Pro 套件。设置:
temperature=1、top_p=1、max_new_tokens=32k,400K 上下文窗口。 - NL2Repo:评测参数
temperature=1.0、top_p=1.0、max_new_tokens=48k,400K 上下文。为防止作弊,我们使用基于规则与基于 LLM 的评判来阻止恶意行为(如未经授权的 pip 或 curl 操作)。 - DeepSWE:使用官方 pier 评测框架和 mini-swe-agent harness 运行(
temperature=1.0、top_p=1.0、timeout=2h、400K 上下文)。每个任务在隔离容器中求解,配置 2 个 CPU、8 GB 内存,无网络访问。 - ProgramBench:使用 Claude-Code 2.1.156 评测(200 个实例),参数
temperature=1.0, top_p=1.0, max_tokens=64000, max_turns=2000, sample_timeout=6h, reasoning_effort=max,400K 上下文窗口。每个实例运行在(4 个 CPU、8 GB 内存)的沙箱中,禁用网络访问。 - Terminal-Bench 2.1(Terminus 2):使用 Terminus-2 框架评测,参数
parser=json、timeout=4h、temperature=1.0、top_p=1.0、max_new_tokens=48k、max_episodes=500,256K 上下文窗口。资源上限为 4 个 CPU 和 8 GB 内存。 - Terminal-Bench 2.1(Claude Code):在 Claude Code 2.1.167 中评测,参数
temperature=1.0, top_p=0.95, max_new_tokens=131072。我们通过透明代理将 max_new_tokens 覆盖为 128k,绕过 CLI 的 64k 上限,以恢复CLAUDE_CODE_MAX_OUTPUT_TOKENS的可配置性。我们移除了墙上时钟时间限制,但保留每个任务的 CPU 与内存约束。成绩取 5 次运行的平均值。 - MCP-Atlas:所有模型均在 think 模式下于 500 题公开子集上评测,每题限时 10 分钟。评判模型为 Gemini-3.0-Pro。
- Tool-Decathlon:使用官方评测服务,max_token 设为 128K。
- FrontierSWE:评测由 Proximal 执行,1M 上下文长度、Max 推理力度、最大输出 128K token。Dominance 成绩截至 2026/06/16。
- PostTrainBench:评测由 PostTrainBench 执行,1M 上下文长度、Max 推理力度、最大输出 128K token。
- SWE-Marathon:评测由 Abundant AI 执行,1M 上下文长度、Max 推理力度、最大输出 128K token。