GLM-5.3技术博客:前沿编程与涌现的网络安全能力
智谱 GLM-5.3 发布:与 GLM-5.2 同一基座模型,全部提升来自后训练规模化——编程开源 SOTA、网络安全能力涌现(实战审计 269 个项目发现 2,436 个漏洞)、slime 框架 RL 吞吐提升 2.3×,权重两周内开源。
本文为 Z.ai 研究博客(2026-08-14)的全文翻译,原文见 GLM-5.3: Frontier Coding with Emergent Cyber Capabilities。基准、模型、产品名保留英文,技术参数与原文一致。
GLM-5.3 我们只做了后训练规模化(scaling post-training)这一件事。 在 GLM-5.2 中,我们搭建了完整的技术栈:用于高效长上下文处理的 IndexShare、用于长程任务强化学习的 SAO、用于大规模异步训练的 slime——它们全都运行在我们持续积累的长程任务环境之上。过去一个月,我们在这套技术栈上持续扩规模:更多的环境、更多样的任务、以及投入训练的更多算力。
今天我们正式发布 GLM-5.3。它使用与 GLM-5.2 完全相同的基座模型——每一分提升都来自后训练。与 GLM-5.2 相比,它在复杂编程和长程任务上强得多:
- 更强的编程能力: GLM-5.3 是编程能力最强的开源权重模型,在我们自建的 Z.ai Code Bench 上比 GLM-5.2 提升 50%。它在 Terminal Bench 3.0、Agents' Last Exam 等公开基准上也取得了开源 SOTA。
- 涌现的网络安全能力: 随着后训练规模扩大,网络安全能力的发展速度超出了我们的预期。GLM-5.3 在漏洞发现基准 CyberGym 上达到 SOTA;而且越往利用链(exploitation chain)上游走,提升越大——在漏洞利用类基准上比 GLM-5.2 翻了一倍以上。
- 开源: 我们将在发布后两周内开放模型权重,届时安全评估与加固工作会全部完成。
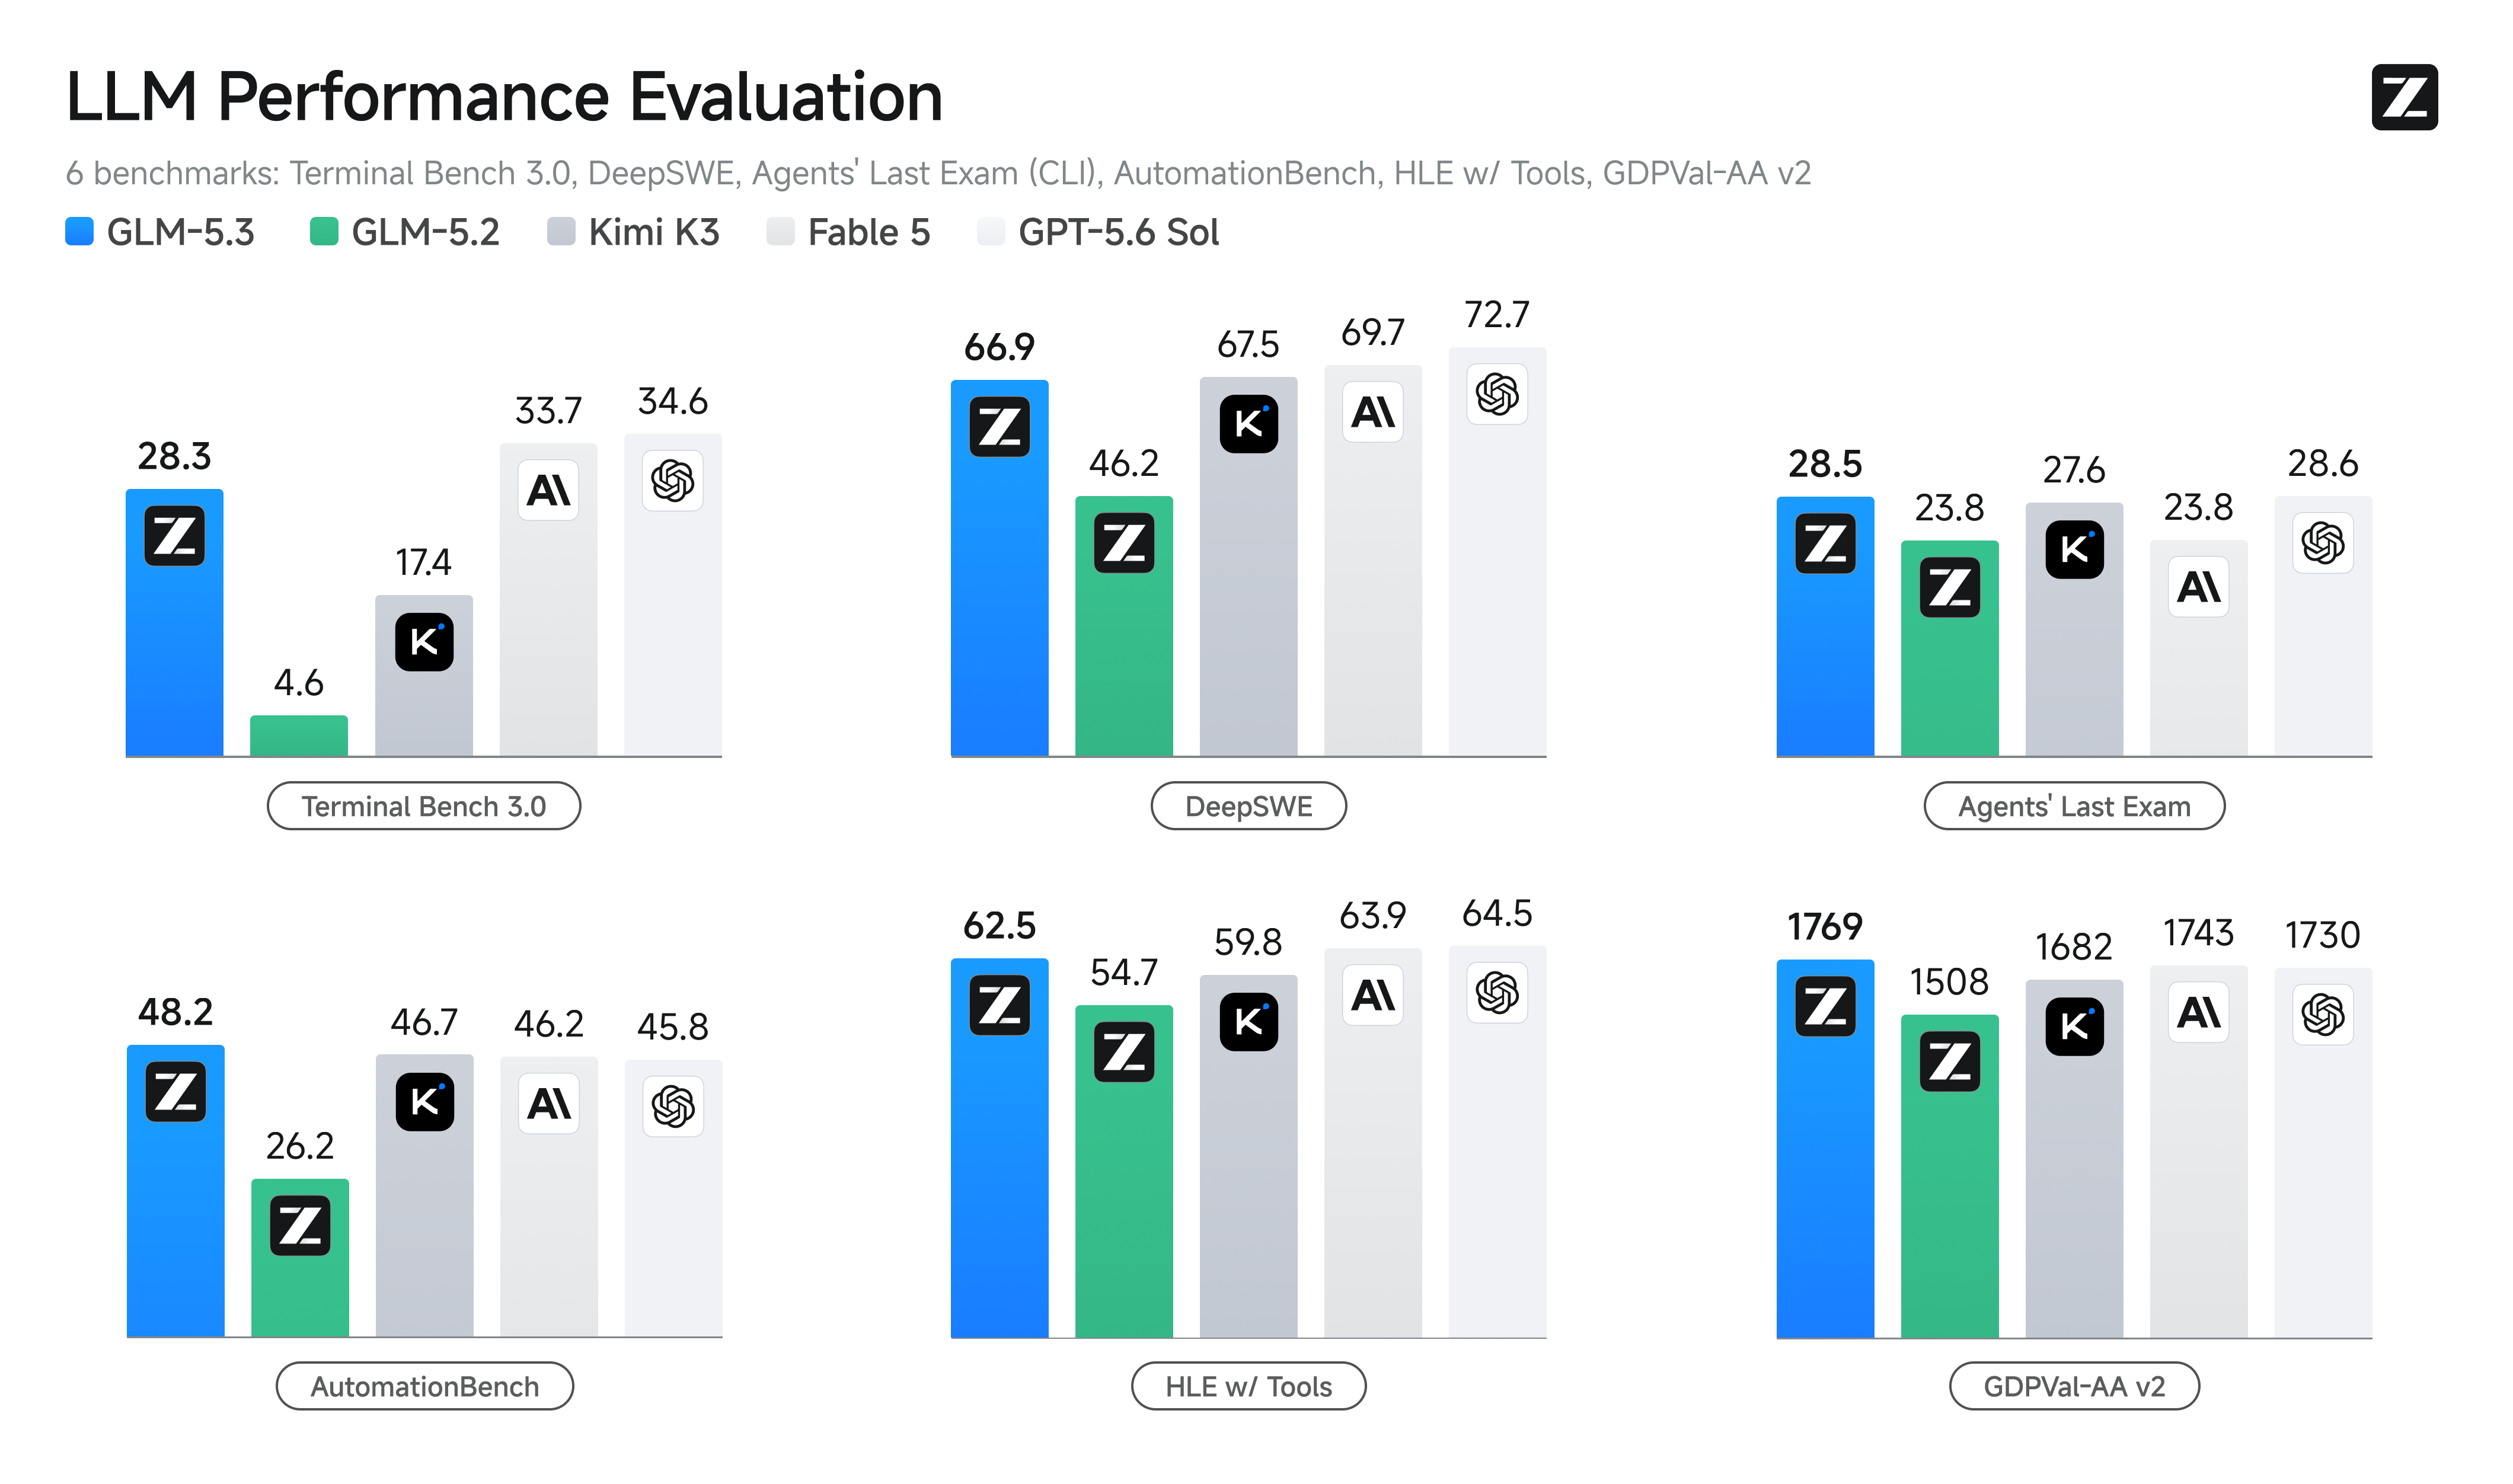
各模型性能对比
| 基准 | GLM-5.3 | GLM-5.2 | Kimi K3 | DeepSeek-V4 Pro-0813 | Qwen3.8-Max | Opus 4.8 | Fable 5 (w/ fallback) | GPT-5.6 Sol |
|---|---|---|---|---|---|---|---|---|
| 编程 | ||||||||
| Terminal Bench 2.1 | 88.2 | 81.0 | 88.3 | 87.9 | 86.6 | 85.0 | 88.0 | 88.8 |
| Terminal Bench 3.0 | 28.3 | 4.6 | 17.4 | - | - | 21.1 | 33.7 | 34.6 |
| DeepSWE v1.1 | 66.9 | 46.2 | 67.5 | 62.7 | 56.6 | 58.0 | 69.7 | 72.7 |
| NL2Repo | 58.0 | 48.9 | 58.0 | 61.1 | 55.9 | 69.7 | - | - |
| ProgramBench Almost Solved | 19.0 | 9.5 | 17.5 | - | 10.5 | 15.5 | 33.0 | 23.0 |
| FrontierSWE | 78.1 | 67.5 | - | - | - | 66.5 | 88.2 | - |
| SWE-Marathon v1.1 | 42.5 | 19.4 | 48.1 | - | - | 48.8 | 33.1 | 42.5 |
| PostTrainBench | 39.8 | 31.7 | 32.0 | - | - | 32.9 | 41.8 | 36.2 |
| 网络安全 | ||||||||
| CyberGym | 84.5 | 77.2 | 80.0 | 83.3 | 78.5 | 78.1 | 83.8 | 83.6 |
| ExploitGym 2h / 6h | 105 / 130 | 29 / 39 | 36 / 70 | - | 14 / 26 | 80 / 120 | 181 / 247 | 216 / 293 |
| ExploitBench | 54.4 | 24.4 | 32.2 | - | 28.8 | 40.0 | 78.0 | 76.5 |
| 智能体 | ||||||||
| Toolathlon Verified | 73.0 | 59.9 | 76.5 | 74.1 | 72.5 | 76.2 | 74.7 | 74.9 |
| AutomationBench v1.0.6 | 48.2 | 26.2 | 46.7 | 43.2 | 39.8 | 41.0 | 46.2 | 45.8 |
| Agents' Last Exam ALE-CLI | 28.5 | 23.8 | 27.6 | 25.7 | 27.0 | 25.7 | 23.8 | 28.6 |
| HLE w/ Tools | 62.5 | 54.7 | 59.8 | 60.0 | 56.2 | 57.9 | 63.9 | 64.5 |
| GDPval-AA v2 | 1769 | 1508 | 1682 | 1590 | 1739 | 1588 | 1743 | 1730 |
更强的编程能力
在 GLM-5.3 中,我们把环境规模化推向了一个新的方向:任务看起来不再是编程练习题,而更像是真实世界中的专家工作单元。现在的环境覆盖了范围广得多的生产工作流,任务设计围绕工程与研究工作的实际开展方式展开,其中一些任务相当于一位资深工程师好几天的工作量。以一项机器学习基础设施任务为例:模型会被放进与工程师完全相同的工作环境里——可以访问计算集群、存储系统、内部文档、代码库和实验结果;它必须诊断出训练全栈中的瓶颈、实现优化、跑实验,并在保证正确性的前提下,交付一个可测量的端到端加速效果。在这种级别的环境上训练,会推动模型端到端地真正「扛起」一整项重要工作,而不是依赖用户来拆解问题、监督每一步。
随着智能体能力的提升,后训练规模化的难点有很大一部分从模型转移到了环境上。一个有用的任务环境必须可执行、可验证,并且贴近真实专业工作——而且我们需要的是大量这样的环境,而不是寥寥几个手工搭建的。为了把这个过程规模化,我们搭建了端到端合成环境的流水线,其中一部分任务连 RL 奖励信号也是合成的。研究型智能体从真实工作中收集任务模式,把它们转化为可运行的、带多步依赖和隐藏状态的长程环境;随后由一个评判智能体(judge agent)实际尝试每个任务,验证它确实可解。验证器(verifier)的合成过程不接触参考解;同时利用解题轨迹(solver trajectories)来发现并封堵奖励捷径(reward shortcuts)。一个能通过 oracle、空操作(no-op)和未解状态三重检验的验证器,就能产出足够可靠、可以直接用于训练的二值奖励。
GLM-5.3 沿用了 GLM-5.2 引入的 RL 策略,包括带压缩(compaction)的 SAO,这让提升在长程任务上同样站得住,而不只是短任务。效果在编程和通用智能体任务上都有体现:GLM-5.3 在 Terminal-Bench 3.0 上从 4.6 提升到 28.3,在 DeepSWE v1.1 上从 46.2 提升到 66.9,在 Agents' Last Exam 上从 23.8 提升到 28.5。这些流水线目前仍需要相当规模的人工参与(human-in-the-loop);让环境生成与验证更加自动化,是我们的下一步方向之一。
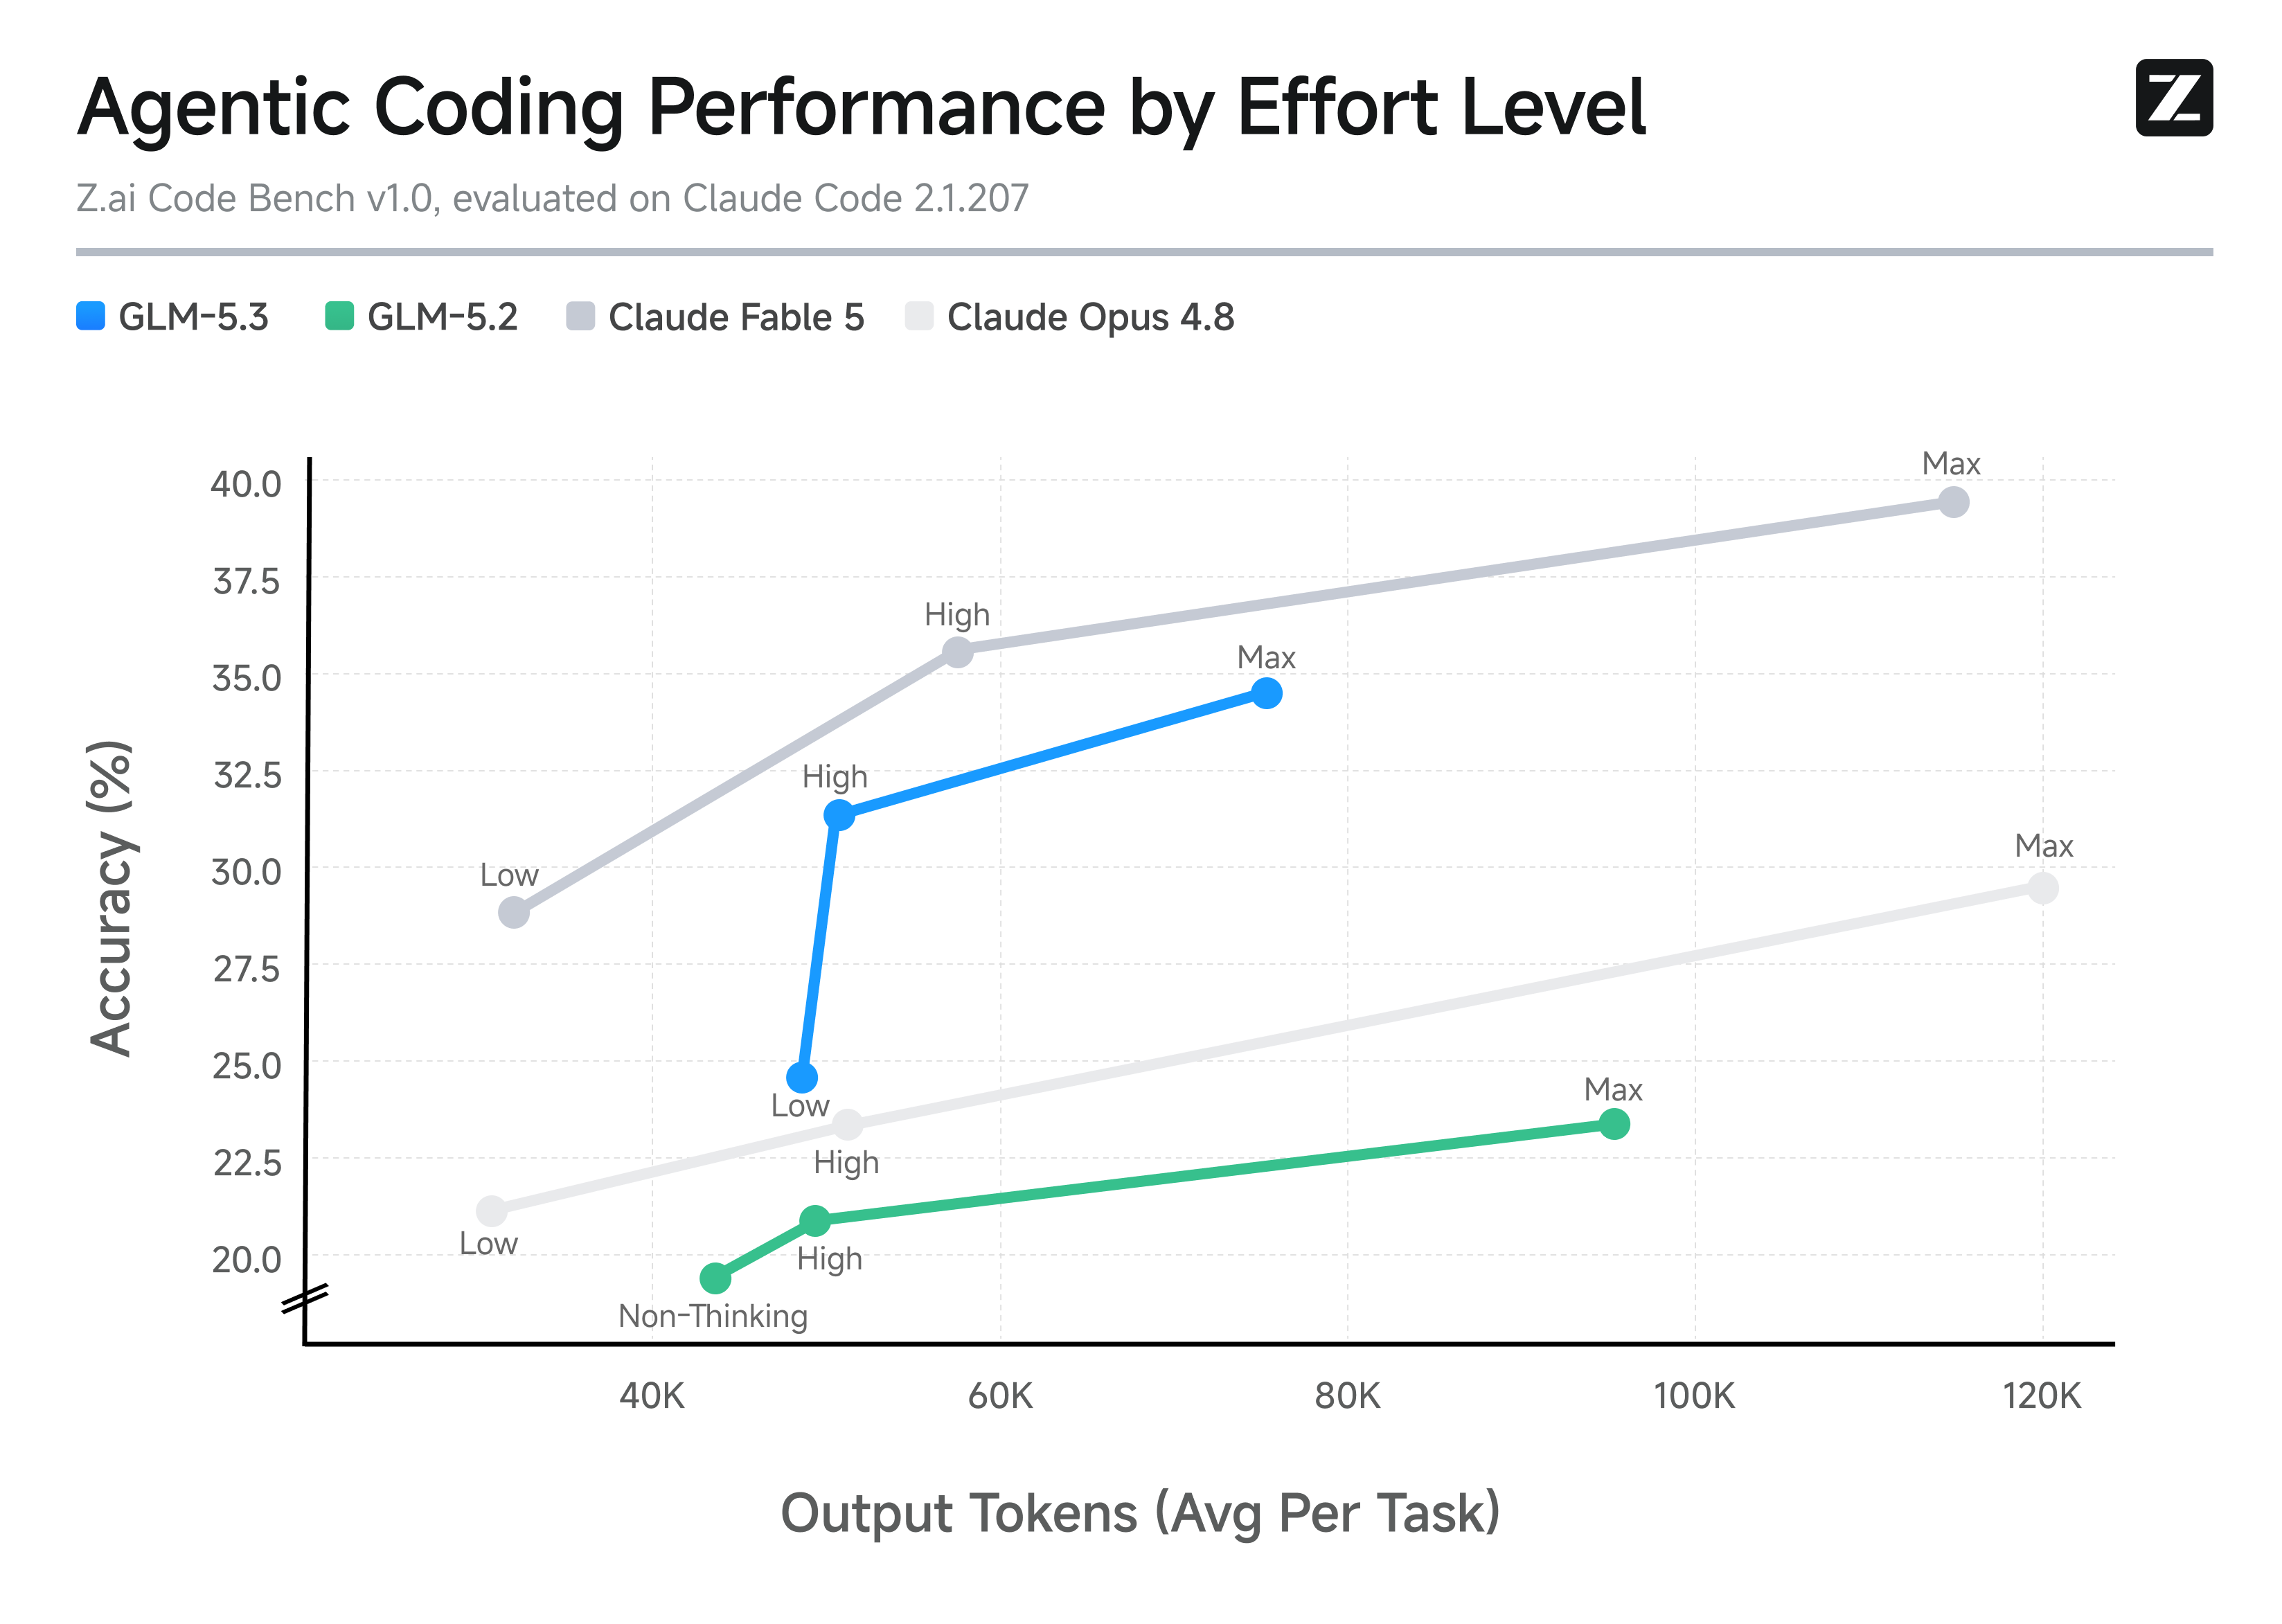
在公开基准之外,我们还推出了 Z.ai Code Bench——一个自建基准,用于在真实用户场景下评估编程智能体。它覆盖多样的任务类别,并把智能体放进复杂的本地开发环境中。在不同推理力度(effort)档位下,我们从两个维度评估智能体:端到端任务完成率,以及细粒度的检查清单准确率。作为私有基准,Z.ai Code Bench 还降低了公开测试集被污染的风险,让我们能更真实地度量现实世界中的用户体验。
如图所示,GLM-5.3 在性能和 token 效率上都有提升。在每一个推理力度档位上,它的智能体编程成绩都明显强于 GLM-5.2,同时消耗的输出 token 更少。在 Max 档位下,GLM-5.3 达到 34.5%,平均每任务约消耗 75K 输出 token;而 GLM-5.2 是 23.4%、96K。面对闭源模型,同样的趋势也成立:在 High 档位下,GLM-5.3 以约 50K 输出 token 达到 31.4%,超过 Claude Opus 4.8 的 29.5%(120K)。GLM-5.3 仍落后于 Claude Fable 5——后者在 Max 档位达到 39.5%。
涌现的网络安全能力
作为后训练的一部分,我们把漏洞发现相关的数据与环境加入了训练组合。我们原本的预期是,这会让模型更擅长发现和推理漏洞。让我们意外的是,随着训练规模扩大,这项能力持续进化的速度非常快。GLM-5.3 不只是更擅长识别孤立缺陷:它开始跨漏洞利用的多个阶段进行推理,为完整的利用链形成连贯的作战计划。
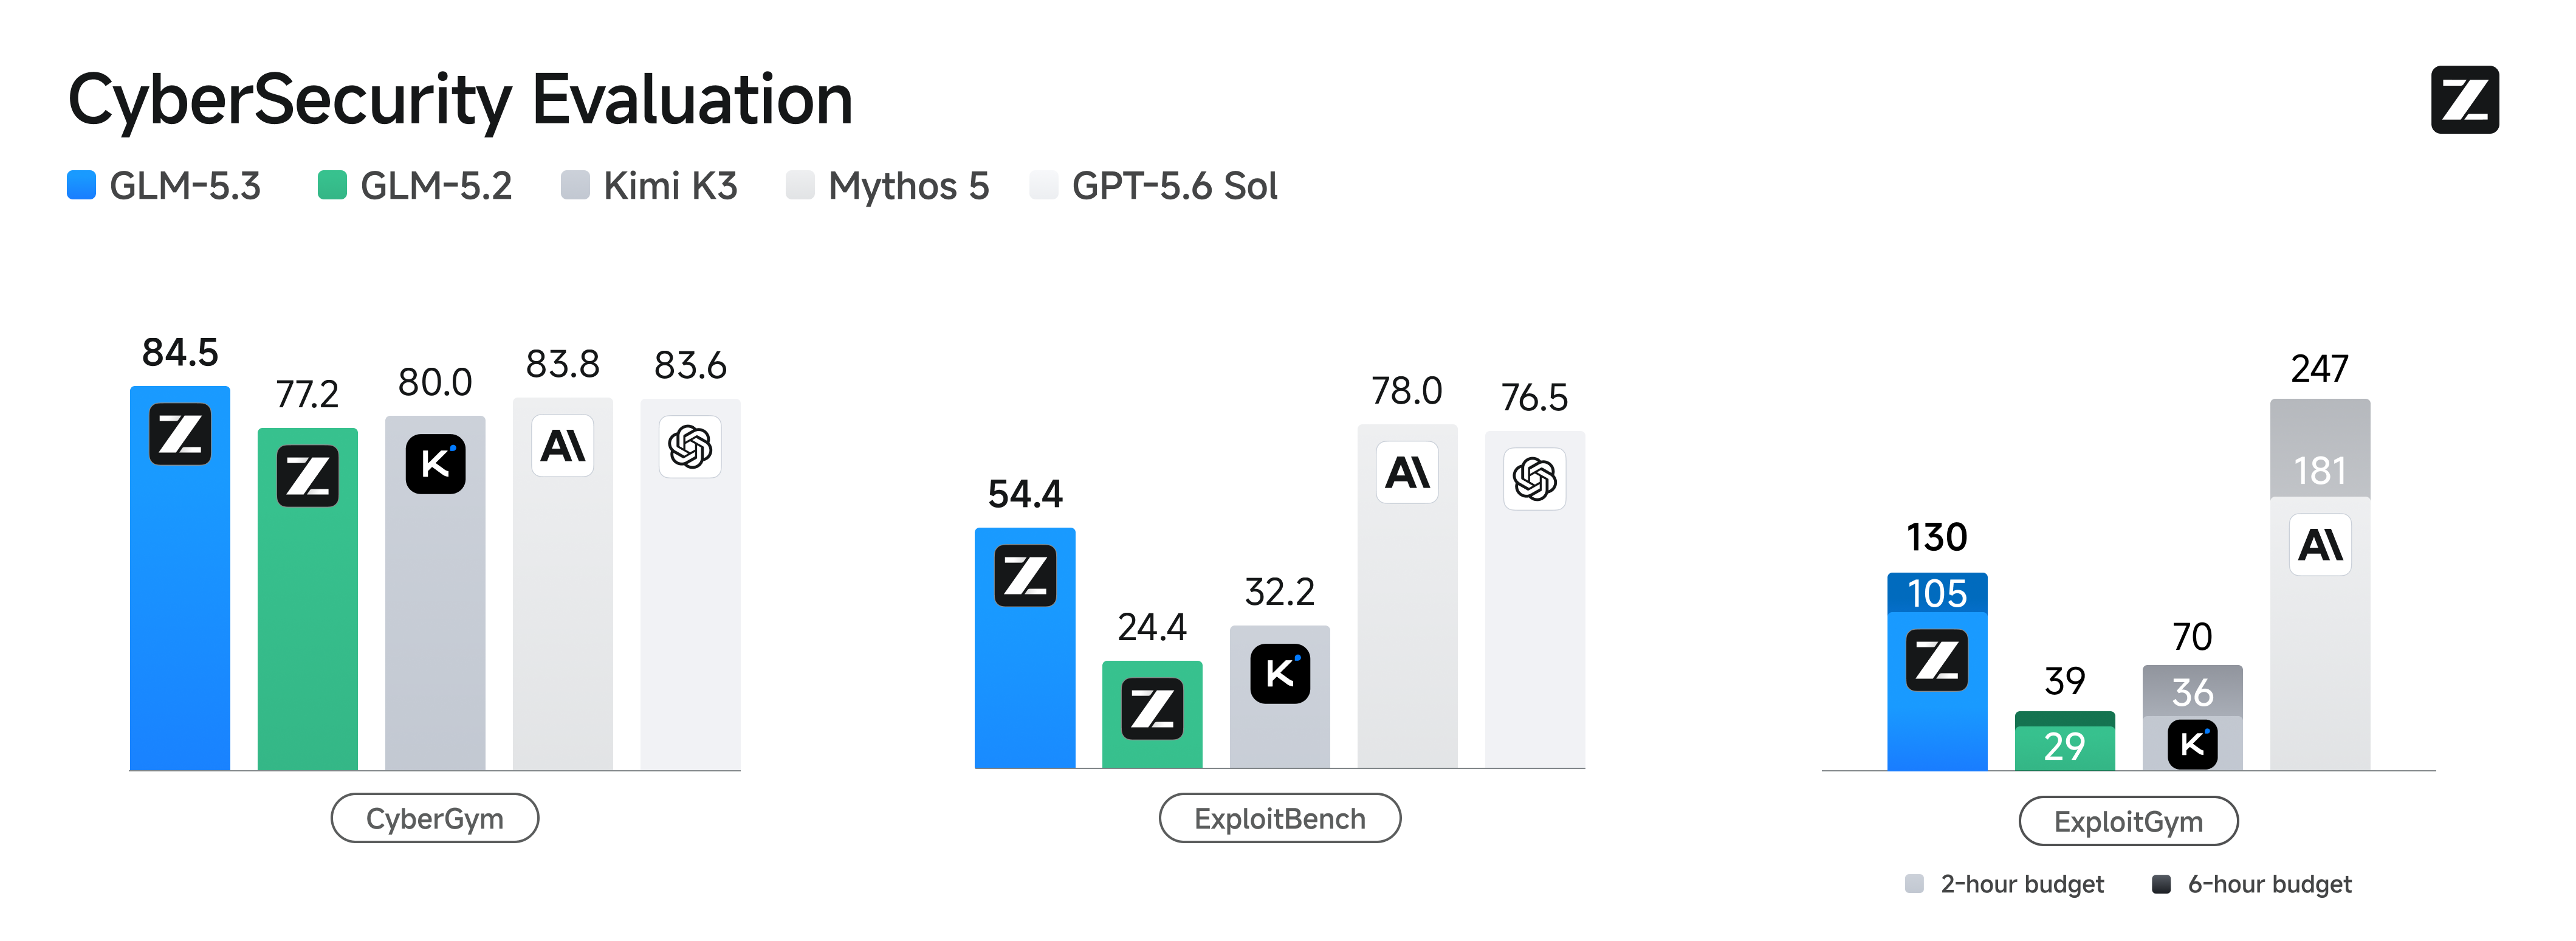
我们用三个覆盖漏洞分析与利用不同阶段的基准来评估 GLM-5.3。在 CyberGym 上——从白盒源代码出发,检验模型能否通过触发故障来识别并验证漏洞——GLM-5.3 得分 84.5%,高于 GLM-5.2 的 77.2%,是该基准的最好成绩,领先 Mythos 5(83.8%)和 GPT-5.6 Sol(83.6%)。在 ExploitBench 上——需要对真实漏洞及其利用方式做更深入的推理——GLM-5.3 达到 54.4%,比 GLM-5.2 的 24.4% 翻了一倍以上,而 Mythos 5 和 GPT-5.6 Sol 分别为 78.0% 和 76.5%。在 ExploitGym 上——衡量模型在时间归一化预算内能完成多少个利用任务——GLM-5.3 在两小时内完成 105 个任务、六小时内完成 130 个,而 GLM-5.2 只有 29 和 39;预算按各模型的吞吐做了归一化,详见脚注。Mythos 5 仍以 181 和 247 个任务大幅领先。三个基准呈现一致的规律:基准在利用链上的位置越靠上游,GLM-5.3 相对 GLM-5.2 的提升就越大——而与此同时,与闭源前沿的差距也越大。能力增长最快的地方,恰恰是我们落后最多的地方。
接下来,我们检验了这些能力能否迁移到可控基准之外。自 GLM-5.2 以来,我们一直与国内的多个安全团队合作,让模型审计真实世界的代码库。经过专家复核、筛查与去重后,模型在 269 个项目中识别出 2,436 个漏洞,其中包括 1,097 个中高危问题。这些发现遍布系统内核、操作系统、浏览器引擎、开源基础设施、Web 应用和网络协议。其中许多漏洞多年来一直未被发现,最古老的一个已存在约 40 年。
这项工作此后发展成了一项持续的披露行动。我们搭建了 Z.ai Security Disclosure Ledger(安全披露台账),在这些发现走披露流程的过程中维护一份公开记录。台账会随着新漏洞被复核与披露持续更新,区分已经公开的问题和仍在披露流程中的问题。对于已披露的问题,台账记录的信息包括受影响的项目、严重级别、CVE 编号(如有),以及该漏洞在代码库中潜伏了多长时间。
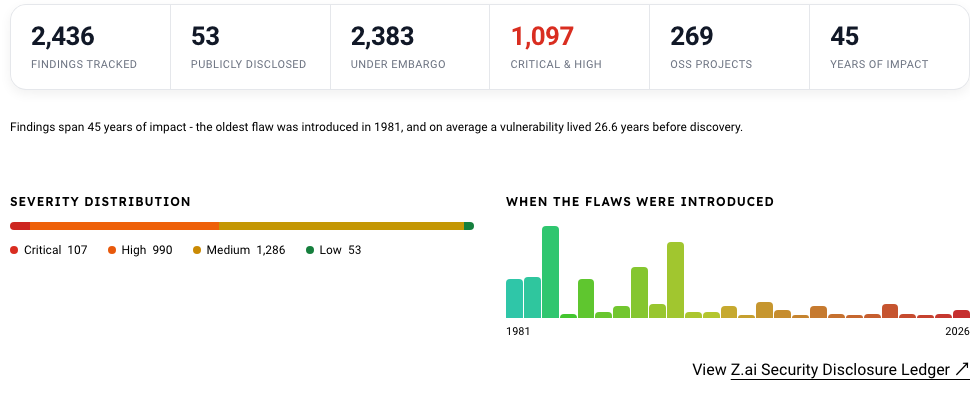
| 2,436 | 53 | 2,383 | 1,097 | 269 | 45 |
| 跟踪的发现 | 已公开披露 | 仍在披露 embargo 中 | 严重与高危 | 开源项目 | 影响年限跨度 |
这些发现的影响跨度达 45 年——最古老的漏洞引入于 1981 年,平均每个漏洞在被发现前已潜伏 26.6 年。
严重级别分布:严重(Critical)107 / 高危(High)990 / 中危(Medium)1,286 / 低危(Low)53
漏洞引入年份:1981 — 2026
查看 Z.ai Security Disclosure Ledger ↗
slime:为长程 RL 规模化而生
这一切都运行在 slime 之上——我们开源的、面向 RL 规模化的后训练框架,训练侧用 Megatron,rollout 侧用 SGLang。它的设计让训练、rollout 和数据缓冲(data buffer)保持在同一条数据流上,因此数学、代码、沙箱、验证器以及长程智能体环境,都可以作为「数据生成」插件接入,而不需要改动训练循环。这正是我们能从 GLM-5.2 到 GLM-5.3 不断增加新环境、却不必每次都重建训练栈的原因。
在 GLM-5.3 期间,我们沿两条线继续建设 slime。在算法侧,我们增加了面向 RL 研究的能力:top-p mask、top-k 与全词表 OPD,以及改善训练–rollout 一致性的配置——包括 R3 风格的设置和训练与 rollout 路径之间的完全数值对齐。这些让我们对采样、训练和教师信号(teacher signals)有了更精细的控制,也让受控对比实验跑起来更快。在我们的训练–rollout 一致性评估中,对数概率(logprob)的平均差异被控制在了 1e-7 量级,相比此前的设置降低了 99.99% 以上。
我们还针对大规模 RL 的资源效率与系统吞吐做了大量工作。本地存储现在充当额外的缓存层,把原本只能放在主机内存里的模型状态和数据分层存放。这一点对多教师 OPD 最为关键:借助训练侧的动态教师切换与预取,可以在不为每位教师单独搭建常驻推理服务的情况下使用多个教师,额外开销有限,资源消耗大幅降低。对于智能体和异步工作负载,我们改进了 router 与 slime 之间的联合调度与负载均衡,让长度和完成时间差异巨大的 rollout 请求能更充分地利用推理资源。我们还加入了负载感知的启发式策略,从每个 rollout 环境的特征出发,推导出面向吞吐的配置——prefill/decode 资源配比、并发设置等吞吐关键参数。其结果是:在长程编程 RL 任务上,这些系统级优化把端到端 RL 训练吞吐提升了 2.3 倍以上,让我们能以高得多的效率,在更长的轨迹和更复杂的环境上扩展训练。
综合来看,这些改进给了我们更大的实验灵活性、更低的资源成本和更高的吞吐——这正是让 RL 规模化得以持续的现实基础。
如何开始使用 GLM-5.3
GLM-5.3 的 API 变更
GLM-5.3 支持三档思考力度:low、high 和 max。GLM-5.3 不再支持关闭思考(thinking)。
思考参数
| 参数 | 取值 | 默认值 | 说明 |
|---|---|---|---|
thinking.type | enabled | enabled | 开启思考。不再支持 disabled。 |
reasoning_effort | low, high, max | max | low:轻量;high:增强;max:深度。 |
编程任务推荐使用 max。
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
必须迁移: 如果你的应用当前使用 thinking.type: "disabled",请先将它改为 enabled 并把 reasoning_effort 设为 low,然后再把模型 ID 更新为 glm-5.3。否则,请求会失败。
通过 GLM Coding Plan 与 ZCode 使用 GLM-5.3
在你喜欢的编程智能体中体验 GLM-5.3——ZCode、Claude Code、OpenCode 等等。https://docs.z.ai/devpack/overview
GLM Coding Plan 订阅用户: 我们已经向全部 GLM Coding Plan 用户推送了 GLM-5.3。新的 GLM Coding Plan 采用积分制配额体系:输入、缓存输入和输出 token 分别计积分。在非高峰时段发起的模型调用只消耗标准积分的 50%。高峰时段为周一至周五 14
–18(UTC+8);其余所有时间(含周末)均享受 50% 的非高峰费率。立即开始构建:https://z.ai/subscribe用 ZCode 获得更多 GLM-5.3 体验:
- 98%+ 缓存命中率——重复上下文按更低的缓存费率计费,相当于多约 30% 的有效 token;
- 1.5 倍限时配额提升——与缓存节省叠加,8 月 31 日前最高可达标准配额的 180%;
- 长程任务掌控——Goal 模式会持续规划、编码、测试、验证,直至目标达成;
- 远程控制——通过微信或飞书,在手机上监控和干预长时间运行的任务。
试用 ZCode:https://zcode.z.ai
本地部署 GLM-5.3
GLM-5.3 的模型权重将在两周内公开提供。
脚注
- HLE w/ tools: 评估采样参数为 temperature=1.0、top_p=0.95,最大生成长度 163,840 token。评估在最大 300,000 token 的上下文长度下进行,并使用上下文管理策略。裁判模型使用 GPT-5.6-luna(medium)。
- NL2Repo: 评估参数为 temperature=1.0、top_p=1.0、max_new_tokens=64k,上下文 1M。为防止作弊,我们使用基于规则和基于 LLM 的评判来阻止恶意行为(例如未经授权的 pip 或 curl 操作)。
- DeepSWE: 使用 mini-swe-agent harness 运行,temperature=0.95、top_p=1.0、超时 6 小时、上下文 400K。
- Terminal-Bench 2.1: 在 Claude Code 2.1.207 中评估,temperature=1.0、top_p=1、max_new_tokens=65536,超时 6 小时。
- Terminal-Bench 3.0: 使用 Claude Code 2.1.207 harness(reasoning effort=max、400K 上下文、最大输出 128K),每个任务跑 3 次 rollout、报告 avg@3。每次 rollout 运行在由任务官方镜像构建的隔离容器中,上限 600 个智能体轮次、超时 10 小时。Tool Search 关闭,智能体产出的工件由任务官方独立的验证器评分。
- Agent's Last Exam(CLI): 按官方评估协议、使用 Claude Code harness 评估(reasoning effort=max、1M 上下文、最大输出 64K)。105 个任务各自运行在隔离的 Docker 容器中,使用其任务卡(Task Card)声明的资源。默认超时 4 小时,任务级限制优先(最长 8 小时)。Tool Search 关闭,结果由官方 ALE 评估器评分。
- Toolathlon Verified: 所有结果均通过官方评估服务获得,报告 3 次独立运行的 pass@1 平均值。
- AutomationBench: 在 AutomationBench v1.0.6 上评估,并纳入了 PR #13 引入的
null类型处理问题修复。 - GDPval-AA v2: 模型由 Artificial Analysis 评估。
- CyberGym: 在 Claude Code 2.1.207 中评估 GLM-5.3(max reasoning effort、不使用 web 工具,temperature=1.0、top_p=1.0、max_new_tokens=128000)。所有评估不设单任务超时限制,结果为 1,507 个任务上的单次 Pass@1。为模拟真实使用场景,我们把智能体放在任务容器内部运行。同时移除了所有 Git 相关信息,并施加域名白名单(仅允许 pypi.org、deb.debian.org 等基础工具安装所必需的域名),防止智能体作弊。
- ExploitGym: 在 Claude Code 2.1.207 中评估 GLM-5.3、Kimi-K3 和 Qwen3.8 Max(max reasoning effort、不使用 web 工具,temperature=1.0、top_p=1.0、max_new_tokens=128000)。报告结果为 869 个任务在 2 小时和 6 小时两档超时预算下的单次 Pass@1;预算按 API 推理时间以各模型的每秒 token 速率换算(各模型 TPS 取自 Artificial Analysis;即 GLM-5.3 的结果按 115 TPS 折算,Kimi K3 按 40 TPS,Qwen3.8 Max 按 47 TPS),再外加非 API 开销。我们同样施加域名白名单(仅允许 pypi.org、deb.debian.org 等基础工具安装所必需的域名),防止智能体作弊。
- ExploitBench: 在 Claude Code 2.1.207 中评估 GLM-5.3(max reasoning effort、不使用 web 工具,temperature=1.0、top_p=1.0、max_new_tokens=128000)。遵循官方评估设置,智能体与环境的最大交互轮次限制为 300,对全部 41 个任务在 3 个修订版(revisions)上计算平均覆盖分。单个任务的覆盖结果为各修订版所达成能力的并集,平均分为各任务结果的均值。我们同样施加域名白名单(仅允许 pypi.org、deb.debian.org 等基础工具安装所必需的域名),防止智能体作弊。
- FrontierSWE: 评估由 Proximal 执行,1M 上下文、max 推理力度、最大输出 128K。报告为截至 2026/08/14 的 dominance score。
- PostTrainBench: 使用 Claude Code 2.1.207 评估 GLM-5.3,max 推理力度,temperature=1.0、top_p=1.0、max_new_tokens=128000,1M 上下文窗口。报告 3 次运行的加权平均。未能产生分数的运行,回退到官方零样本基座模型基线分。为防止使用第三方 API 的检查,我们移除了原有的基于模式匹配的检查——因为通过 OpenAI SDK 访问本地 vLLM 端点时会产生误报——改为使用 LLM 智能体检查解答中是否存在外部 API 调用。
- SWE-Marathon: 使用 Claude Code 2.1.207 评估 GLM-5.3,max 推理力度,temperature=1.0、top_p=0.95、max_new_tokens=128000,1M 上下文窗口。对于 strip-clone,原有的反作弊检查使用了过宽的 import 检测,可能误杀合法实现,我们移除了受影响的检查并改用基于 LLM 的检查以避免误报。对于 parameter-golf 和 trimul-cuda,NVIDIA wheel 的变更导致 Docker 镜像构建失败,我们添加了
--extra-index-url https://pypi.org/simple以恢复构建。
原文 © 2026 Z.ai Inc.,版权归智谱 Z.ai 所有;本译文仅供学习参考。