如何在预算内建立研究实验室 (Gabe Pereyra)
Harvey 总裁 Gabe Pereyra 的 Sequoia 演讲全文:应用层公司如何借力前沿生态,用合成数据、与 Neo Labs 合作后训练和生产级模型矩阵,在预算内建起前沿级研究实验室。
How Harvey Built a Research Lab on a Budget(如何在预算内建立一个研究实验室)
本文译自 Sequoia Capital YouTube 频道,发布于 2026 年 8 月 11 日;演讲者加布·佩雷拉(Gabe Pereyra),Harvey 联合创始人兼总裁。
应用层公司想与前沿实验室竞争,本就是一场不公平的游戏——对方有更多的资金、人才、算力和数据。加布的答案不是硬拼,而是借力整个前沿生态:Harvey 不能在客户数据上训练一个字,却照样把开源模型后训练到前沿水平。演讲结尾,他搬出《点球成金》的那句台词:如果我们赢了,我们就改变了游戏规则。
▍嘉宾:加布·佩雷拉(Gabe Pereyra)
加布·佩雷拉是 Harvey 的联合创始人兼总裁,研究科学家出身:
- 科研生涯:早年曾在 DeepMind 担任研究科学家,之后加入 Meta;演讲中他还提到自己早年在 Google Brain 和 DeepMind 做研究的经历。
- 创立 Harvey:在 Meta 期间,他向大学室友展示了 GPT-3 的能力,这次演示成为两人创立 Harvey 的契机。
- 团队彩蛋:他的弟弟是 Harvey 最早的员工之一、公司里的律师,如今负责培训律师团队生成合成数据集;他的一位老室友曾主导 OpenAI 的后训练工作。
▍关于 Harvey
Harvey 是一家面向律所与企业法务的法律 AI 公司,与全球最大的律所和企业合作。
- 业务规模:在 60 个国家运营,拥有多个产品界面,客户对模型各有偏好;核心场景覆盖并购尽职调查、合同谈判、判例法研究等复杂法律工作。
- 技术路线:因客户数据受特权保护、无法用于训练,Harvey 走出一条“合成数据 + 开源模型后训练”的路线,2026 年已发布三个自建法律数据集,并开源了其中的基准(如 Legal Agent Bench)。
- 组织建设:正在招聘后训练方向的人才,并组建 applied AI 团队。
主持人: 接下来,我们很荣幸地邀请到 Gabe。Gabe 是 Harvey 的联合创始人兼总裁。你很久以前曾在 DeepMind 担任研究科学家,之后去了 Meta——我想那是在你向你的大学室友们展示 GPT-3 能做什么之前。这一对搭档后来就成为了 Harvey。我们非常高兴你能来到这里。今天在座的各位都是应用层公司,都在思考如何开始自己做研究、对自己的模型做 post-training(后训练)、创建自己的实验室。我认为 Harvey 在这方面确实树立了榜样,我们非常高兴你能来讲一讲你们是如何建立 Harvey Labs 的。
Gabe: 太棒了。
[掌声]
开场:在预算内建立一个研究实验室
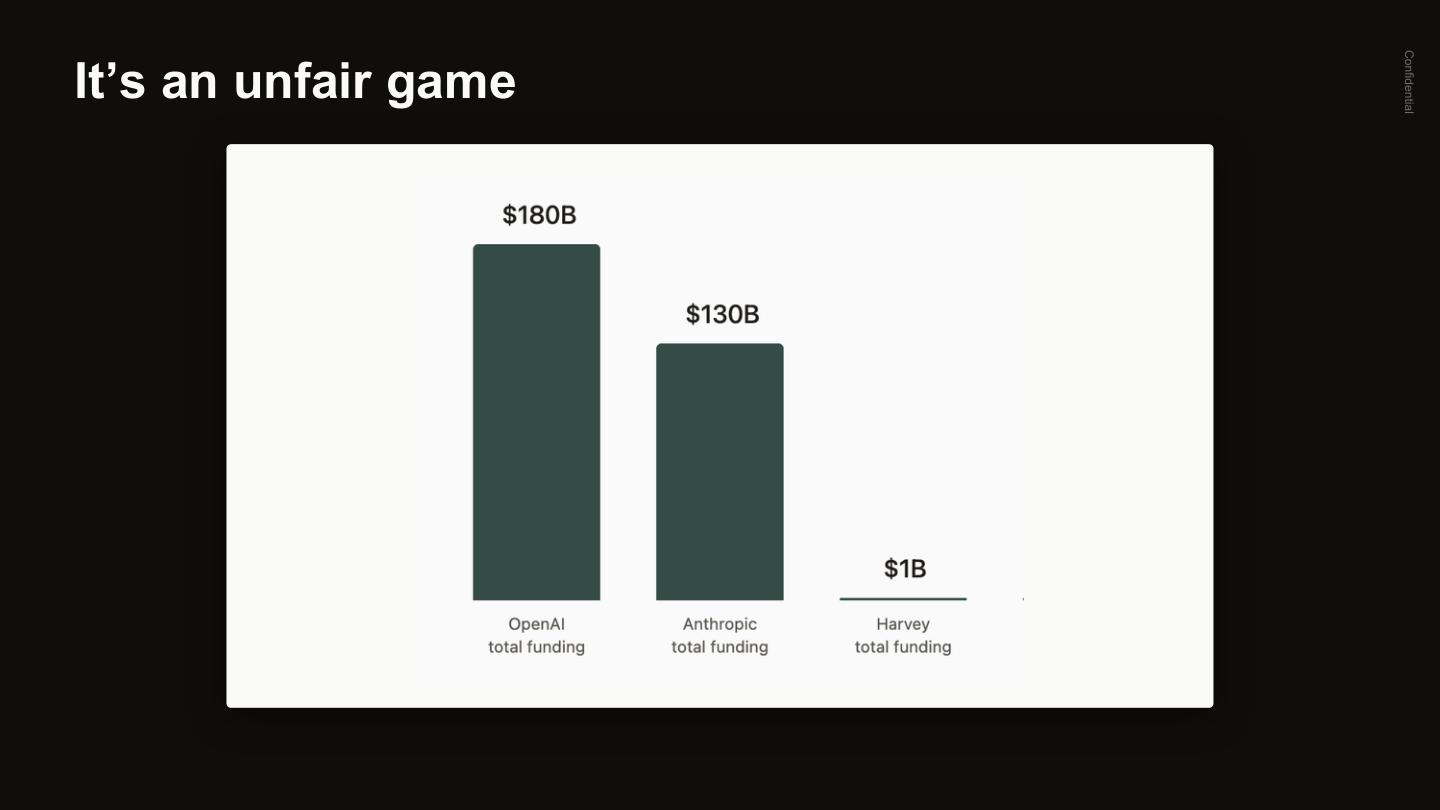
这场演讲的另一个标题是"在预算内建立一个研究实验室"(Building a research lab on a budget)。如果你是一家应用层公司,与前沿实验室(frontier labs)竞争是一场不公平的游戏。有富有的团队,[轻笑]有贫穷的团队,然后就是我们这些身处应用层的团队。前沿实验室有更多的资金、更多的人才、更多的算力基础设施和数据。
那么你怎么竞争?答案是:借助前沿生态(frontier ecosystem)。
四年前我们创办 Harvey 时,这些公司中的大多数要么还不存在,要么才刚刚起步。所以当时我们要么什么都自己建,要么——在大多数情况下——专注于不同的事情,比如搭建我们的 GTM(go-to-market)团队和打造一款优秀的产品。但今天,借助前沿生态,我认为你可以与前沿实验室竞争,构建前沿水平的智能(frontier intelligence)。
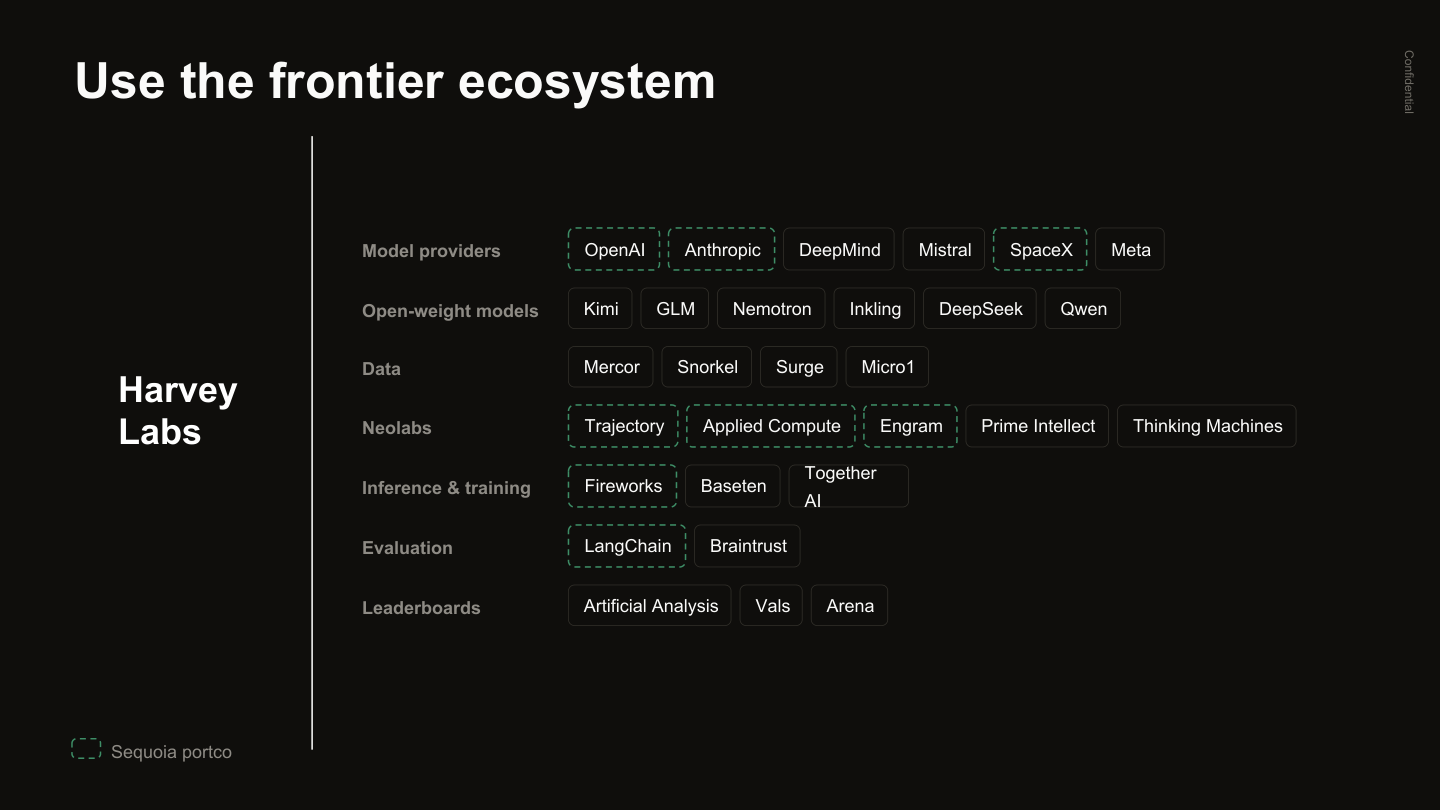
这场演讲将是我们为此总结的高层 playbook(行动手册)。我会讲我们如何构建 benchmark(基准)和训练数据、我们如何与 Neo Labs 合作进行 post-training,以及我们如何在生产环境中 serve 这些模型。
第一步:构建基准与数据集
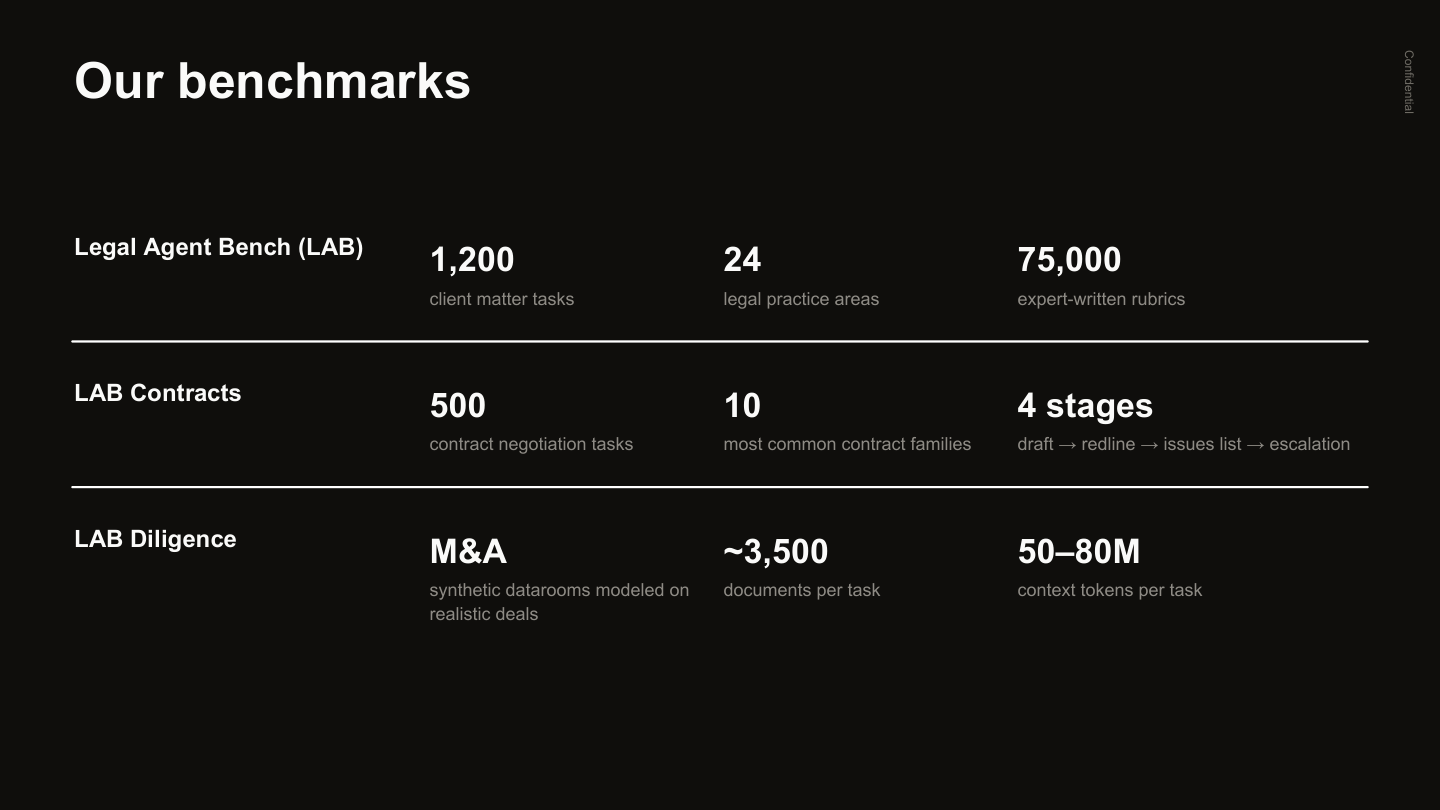
首先,你需要构建一个基准。如果你没有好的基准,你就无法训练模型;如果你无法训练模型,你也就不需要在生产环境中 serve 它们。今年我们发布了三个我们构建的数据集。
我们从构建 Legal Agent Bench 开始,这是一个大型律所里 associate(初级律师)会执行的任务的分类体系(taxonomy)。这些任务覆盖多个执业领域,而且是复杂任务,比如起草复杂的基金设立文件、做判例法研究(case law research)等等。
随后我们构建了一个 contracting(合同)数据集。它让我们能够教 agent 像企业内部法务部门(in-house department)那样进行谈判。
而我最兴奋的是我们最近发布的一个大型 diligence(尽职调查)数据集。我认为这是已发布的最大的 RL 环境(强化学习环境)之一。其中最大的 data room(数据室)有 8000 万 token,它让我们能够在长上下文、非常复杂的任务上做研究。
我认为这些数据集最有趣的地方,在于我们是如何构建它们的。
合成数据:让领域专家指导生成
Harvey 在训练模型时一直面临的一个挑战是:我们不能用客户的数据来训练。我们与最大的律所和企业合作,他们的法律数据极其敏感——是受特权保护的(privileged),所以不能把它放进通用模型里,我们甚至不能把它放进我们自己的模型里。那么在这种情况下,你如何训练模型?
今年开始真正奏效的方法是:让领域专家来指导合成数据(synthetic data)的生成。Reka 的 Brendan 有一个很好的类比:就像工程师现在不再亲手写代码,而是 vibe code、去引导这些 coding 模型一样,我们也开始做同样的事情。
我的弟弟其实就是 Harvey 的一名律师,他已经非常擅长使用这些 coding 模型。他培训了我们其他的律师这样做,而他们能够生成极其逼真的数据集,我们既可以用它来训练,也可以用它来评估我们的产品。
一旦你做到了这一点——合成数据本身还不够好,但它是一个起步的方式。于是,我们与 Mercor 和 Snorkel 这样的公司合作,它们让你能把这一过程规模化,构建更大的数据集,尤其是用于训练的数据集。
把数据集变成高效的 RL 环境
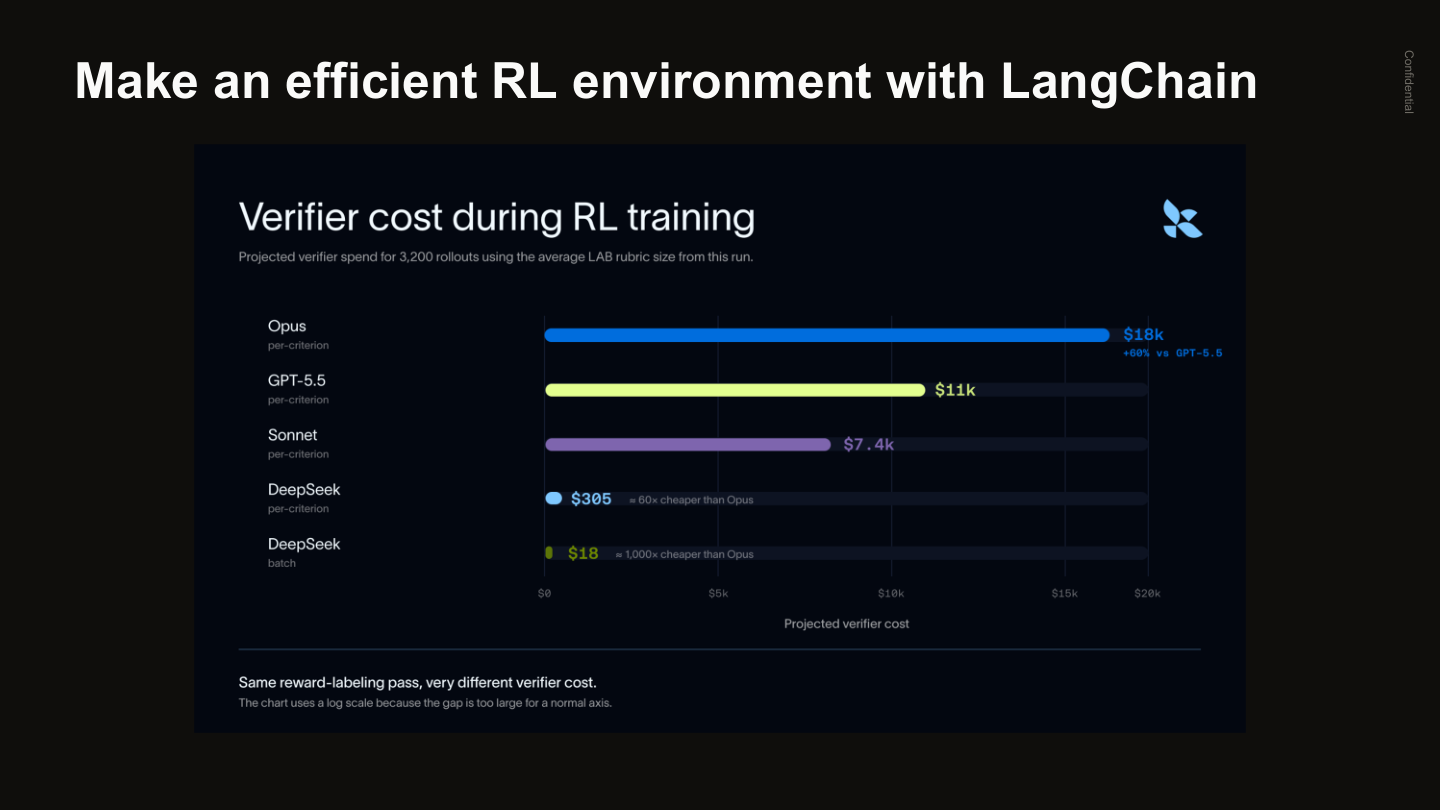
做完这些之后,你需要把这些数据集变成高效的 RL 环境。随着数据集越来越大,成本会变得非常高,评估(evaluation)也会非常昂贵。
举个例子,在我们的 diligence 数据集中,我们有超过 1000 个单元测试(unit tests),用 LLM-as-a-judge(让 LLM 当裁判)来给模型输出打分。如果你用最大的模型、又想做 RL rollout 之类的操作,成本会非常高。所以这里有大量工作要做——其中一些是我们与 LangChain 合作做的——让这些环境变得非常高效。
开源数据集
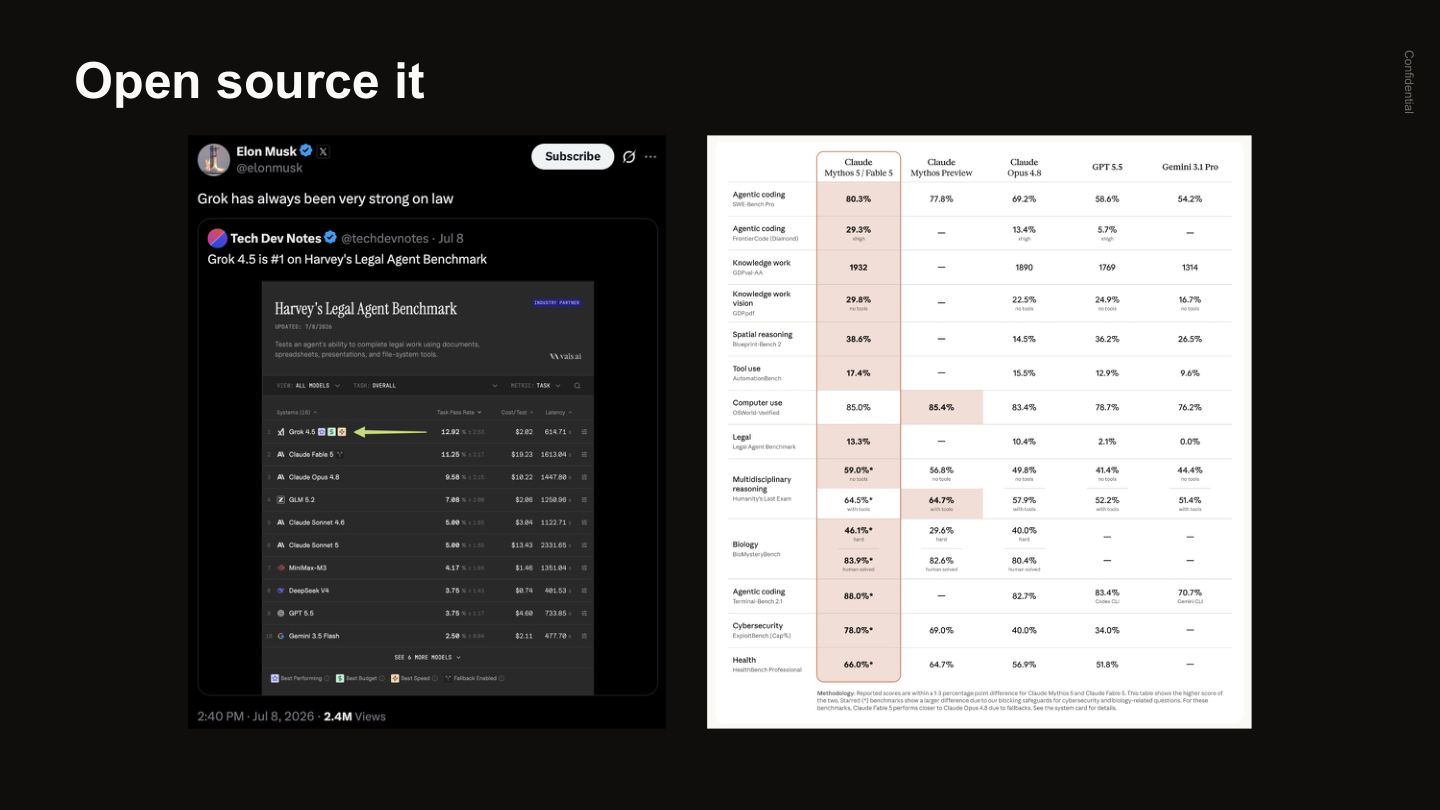
我们做的最后一件事——在当时我觉得有点争议——是开源了其中一些数据集。这样做的动机是:除非有很多人在你的数据集上训练,否则你很难知道你的数据集好不好。
我以前在 Google Brain 和 DeepMind 做研究时,最好的数据集都是开放的,比如 ImageNet、CIFAR、MNIST,每个人都在用它们,于是你能发现所有的问题——我们会收到大量 pull request、收到各种建议。
而且我认为,越来越多地,实验室在发布新模型时会用我们的数据集来做 benchmark。然后最重要的是,Elon 还转推了它。
后训练:开源模型与 Neo Labs
一旦构建了基准,你就有了可以针对它训练模型的东西。
现在令人兴奋的是,开源模型正在变得有竞争力。过去做 post-training 不值得,因为模型通过 pre-training(预训练)进步得太快,你做的任何 post-training 很快就会被下一个预训练模型吸收掉。
但现在,有了 Kimi K3(字幕转写为 "Kimmy 3")、GLM 5.2、NeMo-Megatron、Inkling 等模型,你完全可以拿这些非常强的开源基座模型,把它们 post-train 到前沿智能的水平——也许不是通用意义上的前沿智能,但如果你像我们一样有一个特定的任务领域,它们是有竞争力的。
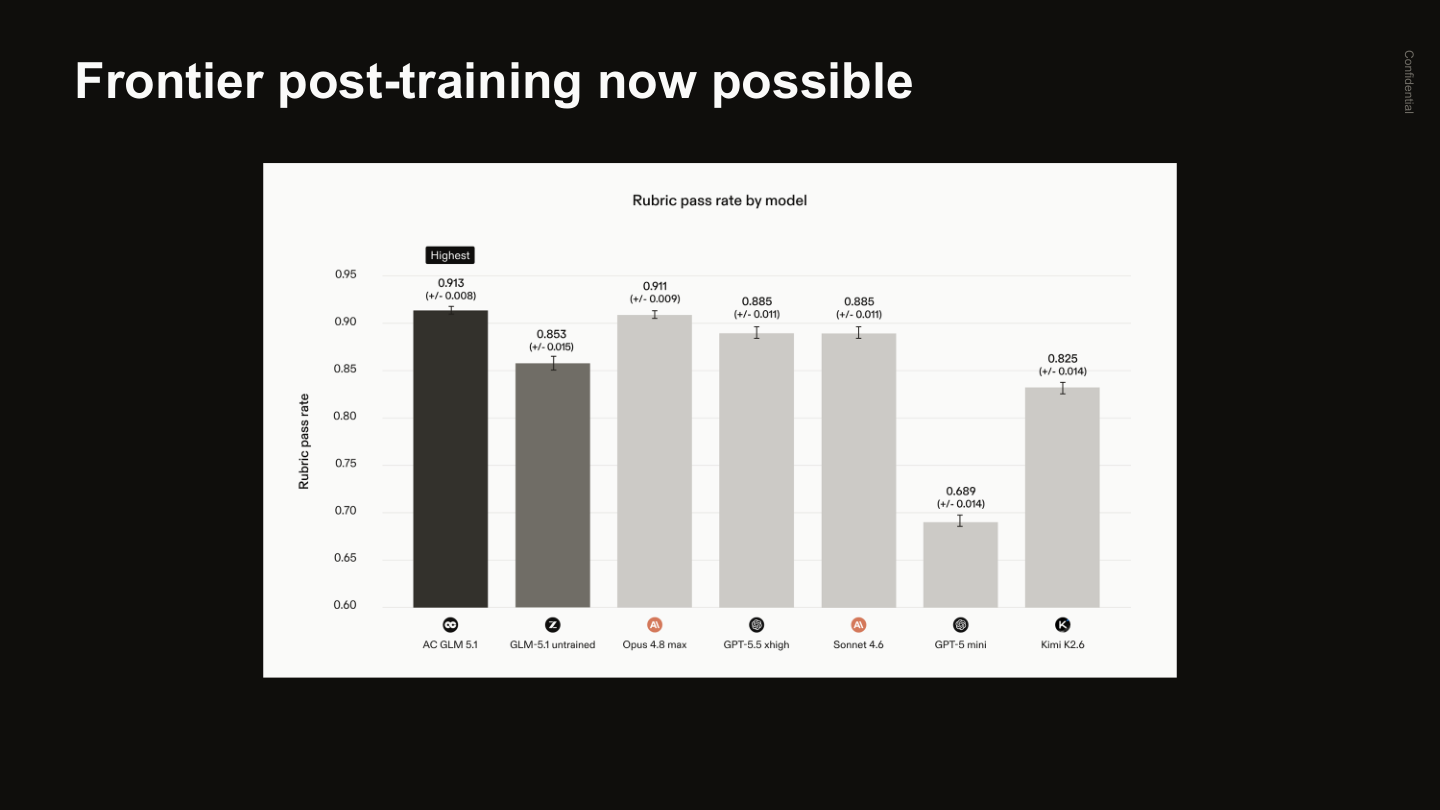
我们建议的起步方式是与 Neo Labs 合作。他们已经有大量的专业知识和现成的基础设施,可以帮你确保你的训练数据集是好的。他们有现成的 recipe(训练配方)。通常来说,如果你和他们合作却拿不到更好的结果,那很可能是你的数据集哪里做得不对——这是一个非常好的冷启动方式。
我们与这些不同的服务商做了一些有趣的工作:与 Fireworks,我们在训练 GLM 5.1 使用 Fable(或者可能是 Opus 4.8)作为 advisor model(顾问模型)上得到了一些非常有趣的结果;与 Baseten(字幕转写为 "Base 10"),我们在 KB compaction(知识库压缩)上做了一些有趣的工作。
与 Ngram(字幕转写)——我想他们今天就在现场——我们在企业搜索和律所知识(firm knowledge)上做着有趣的工作;与 Trajectory(字幕转写),我们合作训练了 NeMo-Megatron 模型;还有 Applied Compute,我们在我们的 Vault 产品上做着一些有趣的工作。
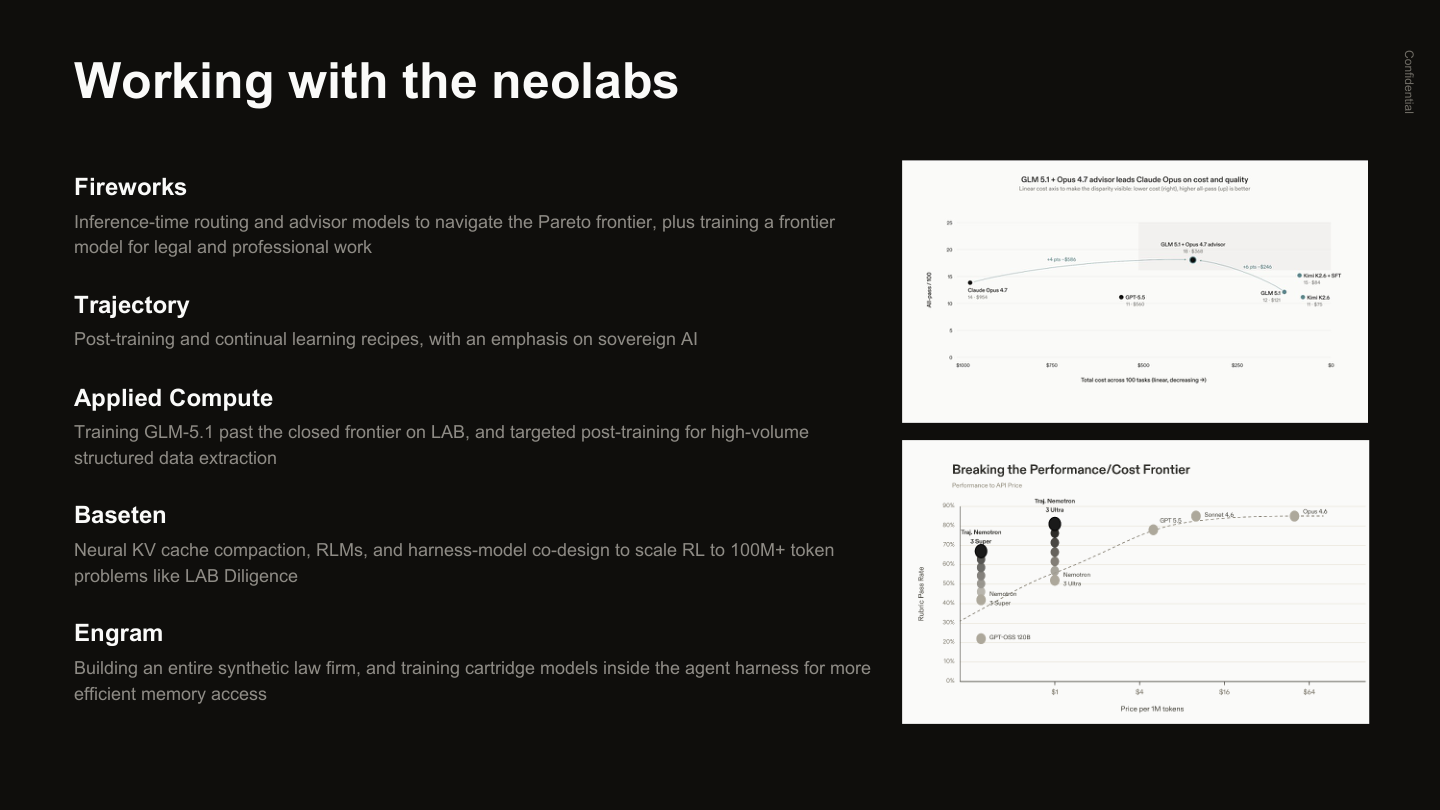
我们常被问到的一个问题是:为什么要与多家 Neo Labs 合作?为什么不只选一家?对我们来说,随着研究实验室规模的扩大,我们的研究项目数量已经超过了我们内部——或只与单一家 Neo Lab 合作——所能承载的带宽。而且每家 Neo Lab 下的是不同的赌注,他们对研究有不同的思考方式,我们也有不同的想要训练的开源模型。合作得越多,我们学到的就越多。
而且做 post-training 正变得前所未有地容易。一方面,与 Neo Labs 合作,我们在合作中学到了很多;另一方面,我们也在内部越来越多地自己做 post-training,使用 Tinker 这样的 API,以及 Fireworks 和 Baseten 搭建的基础设施。
post-train 这些模型并把它们 serve 出来,从来没有像今天这么容易过。而且可供招聘的 post-training 人才也越来越多——我们也在招聘这类人才。
受 Cursor 的启发,这些努力的目标是打造我们自己版本的 "Composer 1":如何把我们做的所有工作——合成数据、用 Mercor 做规模化、与 Neo Labs 的合作——打包成一个模型,让我们可以把它和闭源模型放在一起 serve。
生产环境 serving:模型矩阵
一旦你 post-train 出了一个模型,你就需要能在生产环境中 serve 它。而这并非易事。
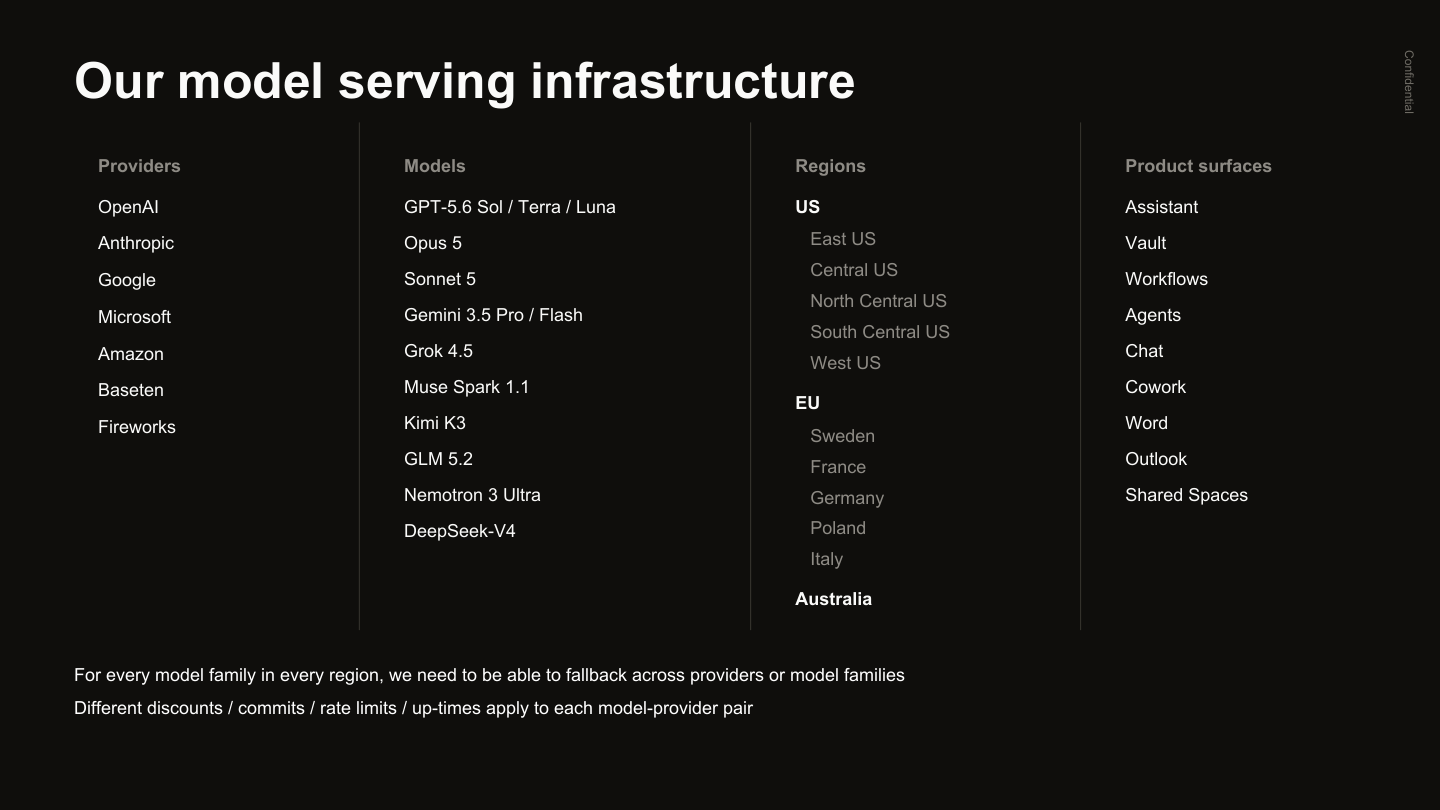
我想先谈谈我们的模型 serving 基础设施,因为我觉得有时候人们仍然把应用层公司想象成:你只是调用一个单一的模型端点,产品大概就是个聊天产品。而我们过去四年解决的一个大问题是:我们在 60 个国家运营,有多个产品界面(product surface areas),客户对模型有不同的偏好。即便只考虑闭源模型,你如何把它们大规模地 serve 出来?
(屏幕上)这个矩阵让你感受一下:在思考大规模 serve 这些模型时,我们需要处理多少事情。举一个简单的例子:对于每一个模型家族,我们需要 serve 其中的多个模型;为了达到我们的 SLA,我们需要有跨服务商的 fallback(回退)。而现在,有了 Fireworks.ai 这样的公司,我们可以把开源模型也加入这个组合。
要在生产环境中 serve 模型、并在生产环境中管理它们,你需要在考虑 post-training 之前就先把这套基础设施建好。所以,我们的思路是:当一个新模型发布时——无论它是开源的、闭源的,还是我们自己 post-train 的——我们如何决定是否把它投入生产;以及一旦投入生产,我们如何决定是否让它继续留在生产中。
上线前评估
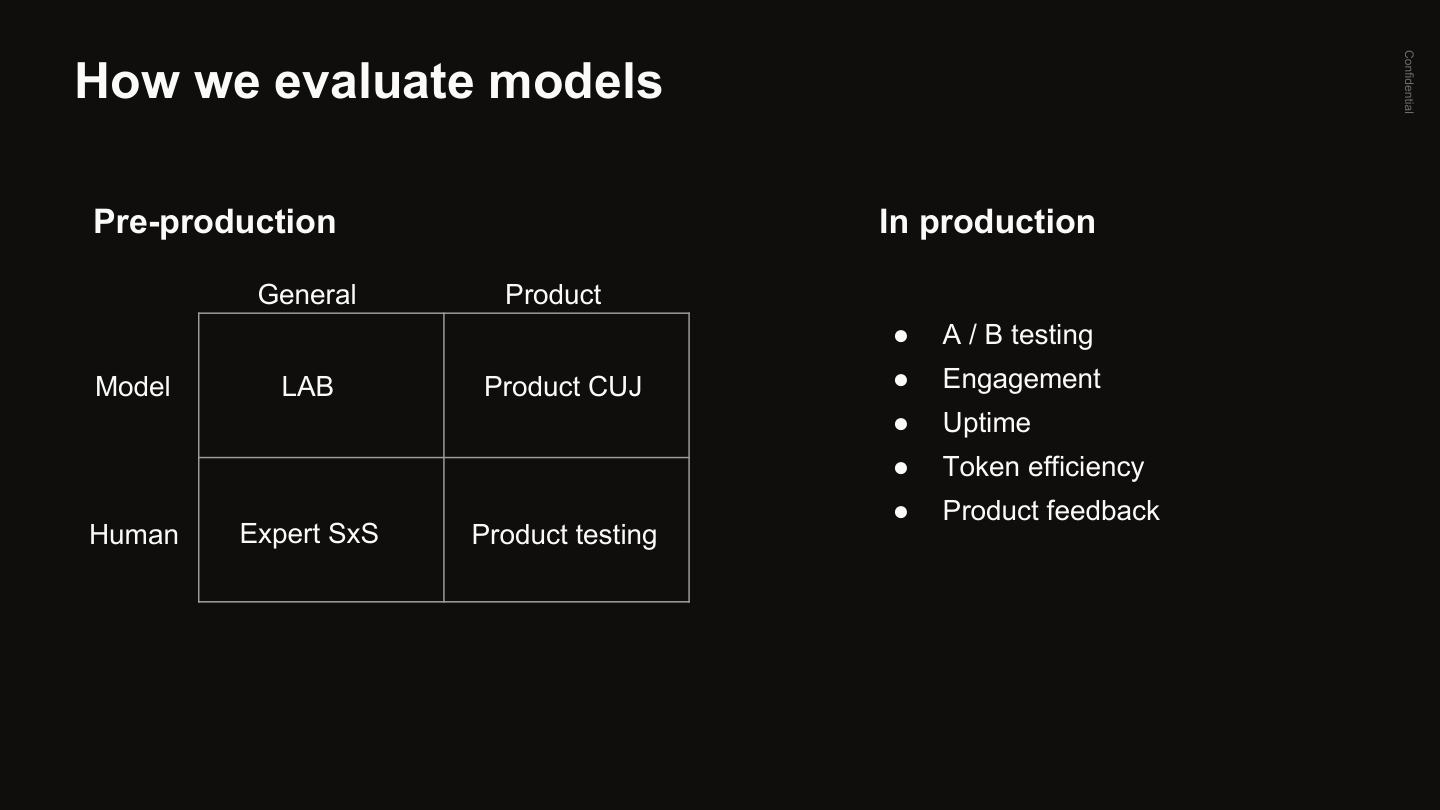
在 pre-production(上线前)阶段,我们有一组通用的评估(generic evals)。在自动化方面,我们有我前面提到的实验室基准(lab benchmark):每当一个新模型出现,它能让我们很快地判断——它是不是一个前沿模型?有多强?在法律哪些领域表现好?
在通用层面,我们还有人工测试:我们把这个模型和其他模型做 side-by-side(并排对比)。然后,针对每一个产品界面,我们有 critical user journeys(关键用户旅程)和自动化的产品测试——因为一个模型可能在通用层面很强,但并不适合某个特定的产品界面。此外我们还有人工产品测试。
所有这些信号,再加上围绕成本、延迟、区域可用性(region availability)的经验法则(heuristics),共同决定了我们是否把一个模型投入生产。这里重要的一点是:无论模型是否经过 post-training,这套流程都是一样的。所以你可以复用这套基础设施,而且你应该在考虑 post-training 之前就把它建好。
上线后监控
一旦模型进入生产环境,同样如此——不管模型是否经过 post-training。如果我们要推出一个大的变更,我们会做 A/B 测试;我们会看 engagement(用户参与度),追踪这个模型的表现是否符合预期;我们还会看 uptime(可用率)、token 效率;然后还有产品反馈——我称之为"愤怒的客户邮件"。所有这些信号都在告诉你:它是否如预期般工作。
所以,在考虑 serve 模型之前,你需要把这套基础设施建好。
开源替换与模型路由
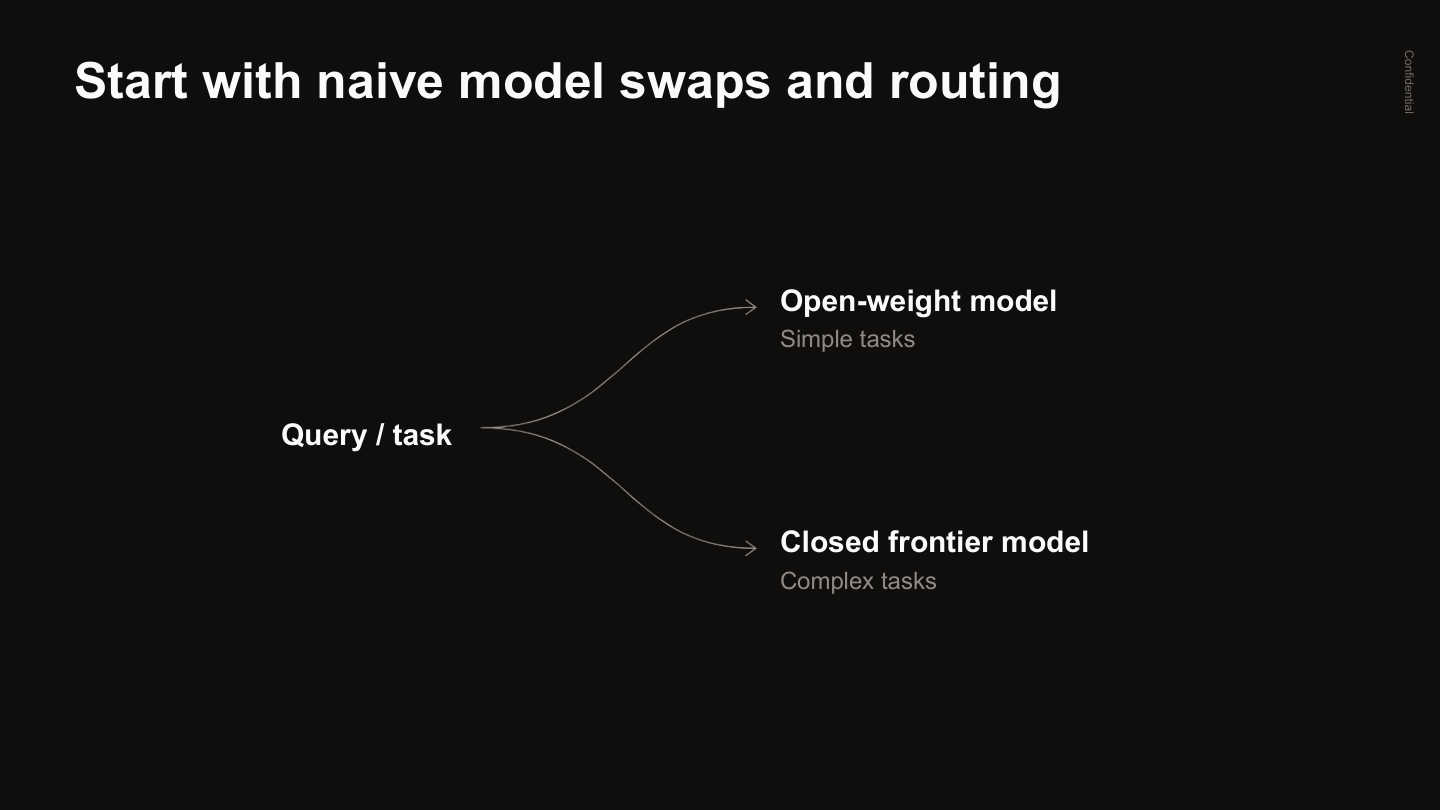
然后,在 serve 模型之前还有一件事要做,我称之为"简单的开源替换"(simple open-source switches)。
第一个是:审视你所有 serve 模型的地方,看看我的产品里有没有哪些地方可以直接朴素地(naively)换成开源模型?举个例子,我们产品中有些部分负责生成引用(citations),这些地方并不需要最大的模型,于是就有机会换成 GLM 5.2,获得成本或性能上的收益。这是第一件事,而且这样做能锻炼"让开源模型与闭源模型一起 serve"的肌肉。
第二个是现在非常流行的 model routing(模型路由)。有些地方你不能直接朴素地换成开源模型,但你可以做的是:对某些特定查询,把流量路由到开源模型。
一旦完成了这些,你就万事俱备,可以开始构建 post-training 飞轮(flywheel)了。
后训练飞轮与结语:Moneyball
一旦你开始在生产环境中 serve 这些模型并收集反馈——这里要加一个提醒:你必须非常小心"收集反馈"意味着什么。在我们的案例中,这绝不意味着在客户数据上训练;但我们确实会从用户测试等渠道获得反馈信号,这些信号可以指导我们如何构建未来的数据集、改进这些模型。
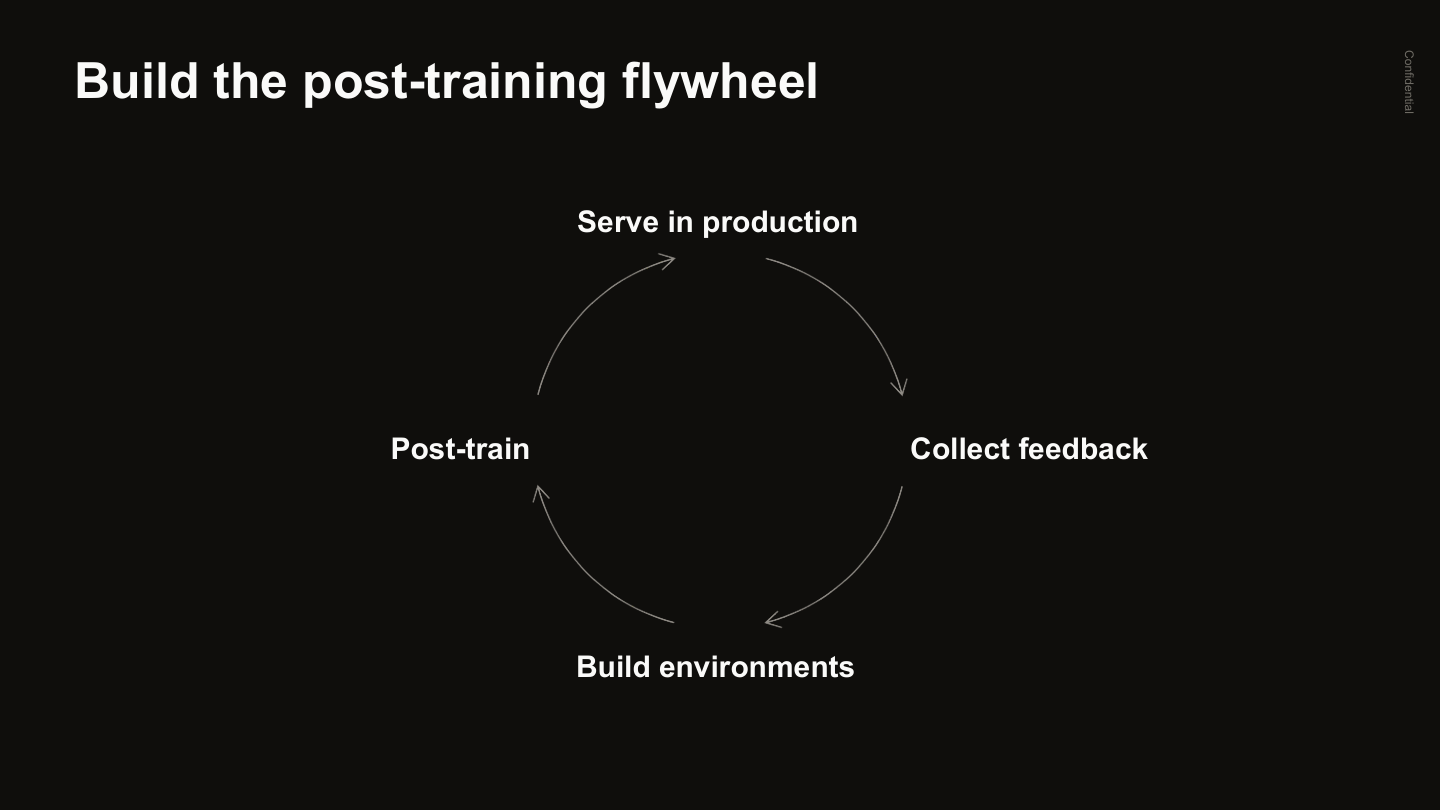
这就是我们建立研究实验室的 playbook。我们认为,未来每一家公司都需要成为一家 AI 公司,并找到某个版本的这套 playbook。尽管如此,我认为大多数人仍然不看好这套 playbook,不看好应用层公司和前沿生态。
但是——
Gabe: 但如果我们赢了——用这样的预算、用这样的团队——我们将改变游戏规则。
这是电影《点球成金》(Moneyball)中的一个场景——希望你们都看过这部电影——他们在谈论"我们刚刚连赢了 20 场"。
比利·比恩(Billy Beane)说:"这无所谓。如果我们赢不了冠军,没有人会欣赏我们在这里所做的一切。"而那句台词是:"但如果我们赢了——用这样的预算、用这样的团队——我们就改变了游戏规则。"
我认为,现在有了前沿生态,在座的各位都有机会做同样的事。
去改变游戏规则吧。谢谢。
[掌声]
Q&A
主持人: 要做 Q&A 吗?……你可以吗?
Gabe: 当然可以。
合成数据具体是怎么做的?
观众: 不好意思,现在该谁提问?嗯,你谈到了与法律客户合作的挑战——他们的数据集非常敏感——还谈到了你的弟弟(律师)和其他内部专家如何用他们版本的"实时编程"来产出最好的成果。那到底是什么样的?能不能给我们多讲一点细节?
Gabe: 好问题。法律工作最大的挑战在于:当你在一家大型律所时,你做的工作是这样的——比如,你代表一家公司做并购(M&A)。你会拿到一个数据室,里面是你要收购的公司的所有合同,外加所有关于谈判的邮件和会议记录。这些数据没有一个是公开的,所以你没有类似开源 GitHub 仓库那样的类比。
训练时你遇到的最大挑战是:你或许能公开找到一些最终的工作成果——比如一份公开的购买协议(purchase agreement)——但你没有任何输入数据。历史上,拉一帮律师说"嘿,造一个假数据室吧"是件非常别扭的事,因为这些数据室可能有一万份合同,而且它们之间必须严丝合缝地咬合在一起。
所以 Julio 想出了一个非常聪明的办法来生成这些数据集。他从 rubric(评分标准)出发:他先埋下所有的问题——"这个场景里数据室存在所有这些问题,而我要检查的就是这些"——然后用它来反向生成数据室。
这样你可以埋下各种问题,比如这些合同之间对不上、这份合同缺失,然后生成所有的数据;接着我们会用 Mercor 和 Snorkel(字幕转写为 "Mercor Shenorcal")让所有合同看起来很逼真。
现在你有了这个输入数据集,你可以让模型生成一份尽职调查备忘录(diligence memo),并且你有一种检查方式:"嘿,你是否抓到了所有我们知道存在于此的问题——因为那些问题是我们亲手埋下的?"
显然,取决于你做的工作类型,你需要在创造方式上很巧妙,但对我来说这感觉是真正的大解锁:因为现在我们终于可以开始这种训练了。
之前你有一个先有鸡还是先有蛋的问题——我们去找律所说"嘿,我们可以用这些客户数据为你训练这个模型",他们会说"好啊,证明给我看",我们说"那给我们看看数据",他们说"不行"。
而现在你可以在这里证明了。现在我们收到很多律所的兴趣,他们说:"哦,这很有意思。我们能用自己的数据来做吗?"
好问题,谢谢。
Gabe: 对了,我们也在为这个方向招人。我们也在组建一支 applied AI 团队(字幕转写为 "implied AI")。
人才招聘:与前沿实验室抢人,还是招领域专家?
观众: 从招聘的角度看,你很难与 Anthropic 和那些实验室的研究员竞争。你会去玩这场(抢人)游戏吗,还是你去招有领域逻辑、律师背景和经验的人?哪些做法奏效了,哪些没有?
Gabe: 我认为这是我在公司刚起步时犯下的最大错误之一。因为我在那些实验室工作过,认识很多那里的人,我会说"来跟我们一起干吧",而他们拿到的都是一亿美元以上的薪酬包,我们当时的规模还撑不起这样的价码。
所以我会说,我们现在才刚刚达到这样的公司体量:我不会说我们在与前沿人才正面竞争,但确实越来越多的人——在读博士的人、不想去大实验室工作的人——出现了,所以我认为情况正在改变。
第二点是:早期之所以需要那种人才,很大程度上是因为不只是做 post-training——你还需要搭建训练基础设施、serving 基础设施,所有这些东西加在一起,我认为能做这些的人才非常稀缺。比如我的老室友就曾是 OpenAI 负责 post-training 的核心成员之一,他是我合作过的最优秀的研究员之一。
但现在你可以用 Fireworks、Tinker 这类 API,你不需要自己搭建训练和 serving 基础设施,所以我认为这扩大了人才池,现在招募到这类人才感觉非常可行。
如何让专家设计的 rubric 足以"挑战"前沿模型?
观众: 嗯,还有一个关于基准构建的问题。当你在创建这些 rubric 时,你仍然必须把它们设计得足以区分(separate)前沿模型——而且你必须依靠专家们自己来做。你是如何驾驭这个挑战的?专家们必须在创建 rubric 时知道、或者说试图预判模型会表现得怎么样。
Gabe: 你说的"区分"是指——
观众: 对——你必须创建能够充分区分前沿(模型)的 rubric……它们必须能挑战到前沿水平,对吧?
Gabe: 是的。
观众: 我想问的是,你如何驾驭这一点,尤其是当你的内部法律专家可能并不确切知道如何创建一个"为模型设计"的 rubric 时。
Gabe: 这是个好问题。我们更多地把它看作:如何让它们成为我们客户实际工作的真实写照(realistic representations)?我认为我们选择法律领域的部分原因在于:只要你构建一个这些顶级律所正在处理的真实客户案件(client matter),前沿模型仍然做不了。
我认为过去四年我们建立起来的东西是——举个例子,我弟弟是我们最早的员工之一,他已经和这些模型共事了四年,所以他对模型如何工作、如何生成这些数据集的直觉好得惊人,而且他培训了一大批律师来做这件事。
但我会说,重点仍然更多是:我们如何构建一个非常真实的数据室,以及为尽职调查设计 rubric。然后当我们运行这些模型时,我们会发现:好吧,存在差距,还有改进空间。不过我认为这取决于领域。
端到端流水线出问题,通常出在数据层、研究层还是基础设施层?
观众: 嘿,我是 Box 的 Shadeen(字幕转写)。
(旁人:不好意思,让我先来这个——……好的。)
观众: 顺便说一句,演讲很棒。我是 Ross,来自 Trolysis(字幕转写)。如果你把你们的端到端流程(end-to-end motion)拆开看:有数据生成、环境这一环,然后是算法这一环——怎么训练等等——也就是研究这一环,然后还有基础设施这一环。如果哪里出了问题,从你亲身见闻的经验看——无论是从运营上、资金上还是人力工时上——问题通常出在数据层、研究层还是基础设施层?然后你们怎么往下推进?
观众: 换句话说,谁在编排和调试这整条端到端的流水线?
Gabe: 这是个好问题——这本身就可以是另一场演讲。我不认为有单一的答案。我要说的是,让这件事对我们来说更容易的原因是:我们找到了 product-market fit(产品市场契合),我们有一个正在生产环境中被使用的产品,而且我们一开始很大程度上是用闭源模型做到这一点的。
这让我们建立起很多"整条链路端到端是通的"的信心。我们有产品,人们在用它,而且已经用了很多年;模型以这样的方式工作,我们可以在生产环境中监控它们是否正常。这就是我在 serving 部分讲的要点:你需要把很多东西先就位。
然后,我们已经锻炼出了这样的肌肉:新模型发布时,如何把它们放进产品——无论闭源还是开源。你可以把这看作一个完整的循环。此外,显然我们还做了大量 harness engineering(脚手架工程)和 context management(上下文管理)之类的工作。所以现在,你可以把 post-training 看作这个更大系统的一个小输入。我们的团队 post-train 出一个模型,然后把它喂进这个更大的系统——你就把它当作又一个新模型来对待。这样你就有了所有这些信号,告诉你哪里出了问题。
而且我会说,在这些步骤之间,有一些简单的"门槛"(gate)可以用。如果你从基准出发,post-train 一个模型,而它在基准上表现不好,那它不太可能走得更远。如果它在基准上表现好,然后你把它放进产品,但有人用了之后说"感觉不对"——因为,举个例子,在我们构建的基准上,仍然有一些模型肯定抓不到的东西。
最好的例子是:一个模型可能在我们的基准上做得很好,但它在某种程度上过拟合(overfit)了,然后你把它放进一个更通用的助手类产品里,一旦你走出分布(out of distribution),它就有点散架了。所以,你需要把所有这些阶段和门槛都建好,然后问题出在哪里就会变得显而易见。好问题。
基准开源还是闭源?
观众: 我也有个问题——嘿,很高兴认识你,我来自 Rocks(字幕转写)。关于基准这边,Legal Agent(Bench)——我记得你们之前有 Big Law Bench,现在有了 Legal Agent Bench——你们对开源基准的理念是什么?因为如果开源,当然会有更多人试用这个基准、带来关注,但实验室也可以顺着它刷榜(climb);而如果闭源,又会有"这算一个真正的基准吗"的疑问。你们的理念是什么?
Gabe: 我认为这确实是我们思考的一个很好的张力(tension)。我要说,即便在开源这个基准之前,我们就已经和实验室密切合作了——我们与他们分享数据,帮助他们改进模型,而这又改进了我们的产品。
所以我们的思考方式是:在你的行业里——尤其是法律行业——帮助我们的客户理解不同模型在不同事情上有多强,有巨大的价值。我创办 Harvey 时有种直觉:哦,我们只要构建最好的模型,客户就会满意,因为它是最好的。而现在已经非常清楚:每个客户都有不同的偏好,不同的模型擅长不同的事情。
第二点我没预料到的是前沿生态会变得这么大。现在有非常多的公司来找我们说:"嘿,我们有这个新技术、做了这个东西,能试试吗?"以前我们没有这个带宽,只能说"我们在忙别的事"。但现在有了这个开源数据集,我们可以说:"嘿,去试试吧,如果有效,那太好了,这就是值得投入的方向。"
然后,从战略上我们的思考是:对我们有价值的数据,将是帮助律所训练他们自己的系统、以及他们如何在私有数据上工作的数据。而我们希望帮助每个人用合成数据和我们开源的一些数据来改进这些系统——但显然,出于你提到的那些原因,需要保持平衡。
还有哪些悬而未决的开放问题?
观众: 你提到了找实验室(合作)。还有哪些悬而未决的开放问题(open questions)是你想寻求帮助的?
Gabe: 好问题。我要说一个大挑战——最大的挑战之一:我们能生成这些非常逼真的合成数据集,也能用人工来增强它们,但这些数据的分布仍然与我们的生产分布(production distribution)不匹配。所以我会说,我们生成的这些数据集在某种程度上是"面向未来"的。
我的意思是:我们能生成一个非常真实的数据室,但目前我们的产品并不是纯粹用来做尽职调查的。所以如果一个模型在那上面表现好,但有人拿它去起草一封邮件,也许效果就没那么好。所以这个差距仍然存在,因为我们无法查看客户数据——那如何弥合这个差距?对我来说,这是数据集方面最大的问题,而且这个问题很棘手。
还有一系列问题,比如,还是以 diligence 数据为例:最大的数据室有 8000 万 token 的上下文。模型并不擅长管理这样的上下文——你如何训练模型在这些非常复杂的环境中运作?所以我认为这是另一个仍存在巨大性能差距的问题。
第三个是:我们在"如何自己 post-train 模型"上取得了不错的进展,但我认为,找出某种形式的 continual learning(持续学习)才是这里的终局(end game)。终局不是让我们构建最好的法律模型,而是让我们帮助每一家律所或企业客户,把模型定制到他们所从事的工作类型上。
所以,要思考的是如何把它运营化(operationalize):一家大型律所,每次他们处理一个客户案件,他们的 AI 系统就变得更聪明一点,但同时你又在保护客户数据。我认为这是一个巨大的——技术上、运营上以及 AI 本身的——挑战,而且超级有意思。
(主持人示意时间差不多)——我们还可以再来一个吗?我还可以再答。嗯,好,也许最后一个。
从产品角度,如何与通用的 Copilot 类产品竞争?
观众: 你讲了很多关于"基础就绪度"(foundation readiness)、如何与前沿实验室竞争的内容(字幕此处疑将 "frontier labs" 识别为 "Front Row Live"),包括你们的开源模型、包括你们的基础设施。从产品角度看——比如 Copilot 作为云端产品(字幕转写为 "Coda",按上下文疑为识别误差),它们是通用产品——从产品角度,你们如何与之竞争:云端工作流、方法论、效率?你们是怎么想的?
Gabe: 我认为我们正在思考的一个大转变是:我们最初的产品——以及像 Copilot 这类产品——都是非常聚焦个人的产品,它们关乎个人生产力。而我们越来越多地在构建的产品,关乎的是组织生产力(organizational productivity)。
如果你想想一家大型律所,他们要解决的问题不是"如何让我单个的律师更高效"。他们要解决的问题是:我有一万个客户,我在为他们所有人做客户项目,我需要确保所有这些项目都进展得非常顺利,而且我还得以一种盈利的方式来做。
所以,我们为律所搭建的大量基础设施是关于:你如何运营这台机器?
当你开始思考单个客户项目时,大多数挑战不在于"我如何起草这一个章节",而在于:我要为这个项目工作 6 个月,我有一个遍布全所的二三十人的团队,我需要协调所有人,我需要确保协调好所有外部相关方。所以很多事开始看起来像项目管理(project management)——在编排这些人类和这些 agent。这是团队层面的。
再想想组织层面:现在你有一千个这样的项目,你需要开始思考资源分配——我该开多少账单、我该去投标(pitch)什么?而对于企业客户就更复杂了:一家财富 500 强公司,他们与上千家律所合作,内部有上千人——所有这些系统该如何启动、流转这些工作?
所以简答就是:去做 hyper-vertical(极度垂直化)——我认为这也是企业软件历史上的做法——以一种横向(horizontal)产品不会去做的方式,深深地扎进你的领域。好问题。
主持人: 谢谢 Gabe,这是一场标志性的演讲。感谢你的到来。
[掌声]