Kimi K3 技术报告:开放的前沿智能
Kimi K3 技术报告全文翻译:2.8T 参数混合专家(MoE)模型、104B 激活参数、100 万 token 上下文窗口,基于 KDA 与 AttnRes 两大架构创新,完整模型权重开源。
Kimi K3 技术报告:开放的前沿智能
Kimi K3 技术报告
Kimi 团队(Kimi Team)
摘要
我们推出 Kimi K3:一个总参数量 2.8T 的混合专家(MoE)模型,激活参数 104B,具备原生视觉能力,上下文窗口达 100 万 token。Kimi K3 构建于 Kimi Delta Attention(KDA,Kimi Delta 注意力)[64] 与 Attention Residuals(AttnRes,注意力残差)[58] 之上,二者分别改善了沿序列长度与模型深度方向的信息流动。这些进展,连同每个 token 从 896 个路由专家中有效激活 16 个的 Stable LatentMoE,以及经过改进的训练与数据配方,使 Kimi K3 的整体规模扩展效率相较 Kimi K2 [59] 提升了约 2.5×。后训练的重点是横跨通用、智能体与编程领域、覆盖多个推理力度等级的强化学习(RL),从而实现组合式泛化与稳健的长周期执行。在 2.8T 规模下,Kimi K3 由多个领域的基础设施进展所支撑:面向 KDA 的算法-系统协同设计、兼具高效内存管理的完美均衡专家并行训练、具备持久 rollout 与沙箱状态的百万 token 智能体强化学习,以及部署层面的创新。
大量评测表明,Kimi K3 在长周期编程、智能体、知识、推理与视觉任务上均达到前沿水平。尽管其整体性能仍落后于最强的专有模型——即 Claude Fable 5 与 GPT-5.6 Sol——但在我们评测套件中的所有其他开源与专有模型中,Kimi K3 均稳定领先。我们开源了 Kimi K3 的完整模型权重,以促进未来研究,并加速前沿智能的更广泛部署与采用。1
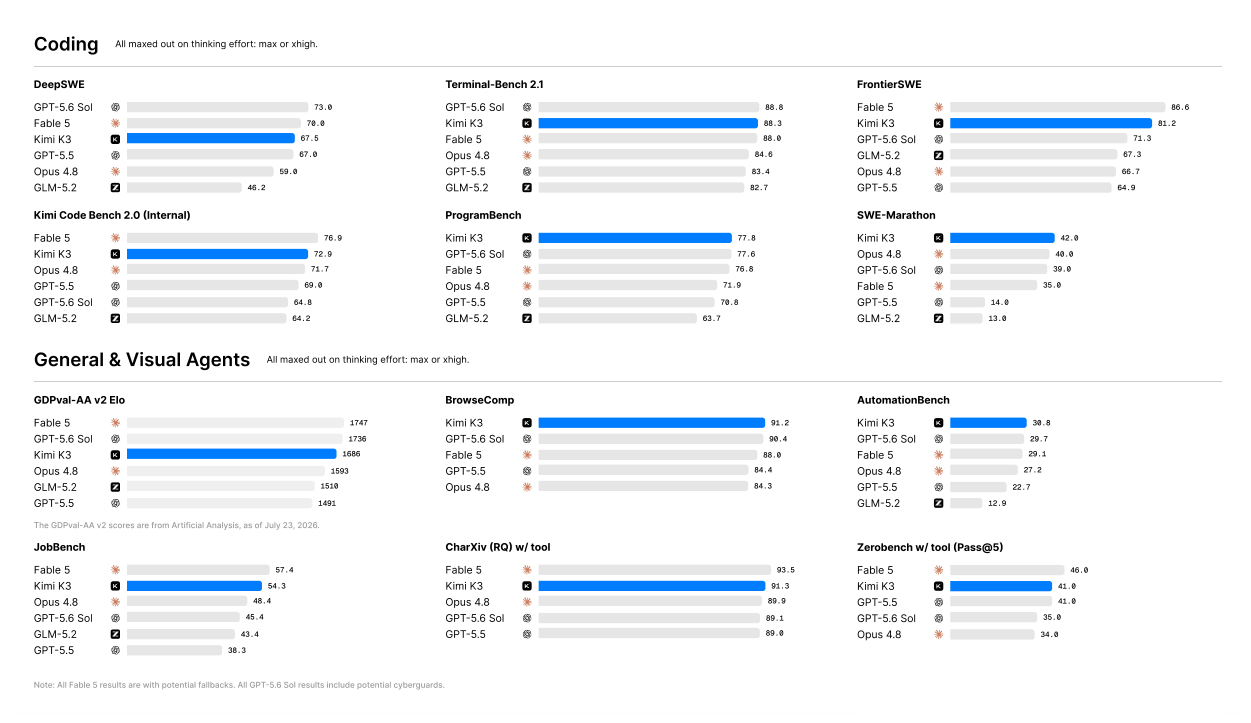
▍图 1:Kimi K3 主要结果。
1 引言
在大语言模型(LLM)发展的大部分历程中,「扩展(scaling)」意味着在部署前投入更多计算,即用更多数据训练更大的模型 [55, 46]。推理模型的兴起确立了第二条扩展轴——测试时计算:OpenAI 的 o 系列扩展了强化学习与测试时推理 [85, 84];Anthropic 的 extended-thinking 模型分配自适应的思考预算,并将推理与工具调用交错进行 [6, 7];DeepSeek-R1 [41] 与 Kimi K1.5 [119] 表明,大规模强化学习可以从强大的预训练模型中激发出复杂的推理行为;Kimi K2.5 Agent Swarm [60] 则进一步将测试时扩展从串行推理推进到并行智能体协同。这些进展使测试时扩展成为前沿研究的焦点。然而,开源模型生态在第二条轴上突飞猛进的同时,在第一条轴上却进展缓慢:许多近期模型仍停留在 1T 量级参数规模之内或略高 [146, 29, 136, 121]。当日益复杂的推理与智能体强化学习方法被施加于规模相近的预训练基座之上时,开源的进步面临趋同的风险,而与最强专有系统之间的差距则在拉大。在 Kimi K3 上,我们同时将两条扩展轴一并推向前沿:一方面将预训练基座扩展至前所未有的 3T 量级参数,另一方面在 100 万上下文长度下扩展强化学习、推理力度与长周期交互。
我们推出 Kimi K3:一个原生多模态的混合专家(MoE)模型,总参数量 2.8T,激活参数 104B,上下文窗口最高达 100 万 token。其架构沿序列长度、网络深度与模型宽度三个维度扩展信息流动。Kimi Delta Attention(KDA)[64] 提供高效的长序列混合,周期性穿插的门控多头潜注意力(Gated MLA)层则保持全局交互。Attention Residuals(AttnRes)[58] 使每一层都能选择性地关注此前所有层的表示。Stable LatentMoE 将路由专家空间扩展到 896 个专家,每个 token 激活 16 个;归一化、SiTU-GLU(Sigmoid Tanh Unit GLU)与 Quantile Balancing(QB,分位数平衡)则在极端稀疏度下稳定了优化过程。这些架构进展,结合改进的数据与训练配方,使整体规模扩展效率相较 Kimi K2 [59] 提升约 2.5×。
与这一预训练基座相配套的,是专为 100 万上下文测试时扩展而设计的后训练。Kimi K3 在长周期编程、通用智能体、通用推理与知识任务上进行强化学习,每项任务均覆盖多个推理力度等级。训练环境包括:可验证的搜索与专业知识工作、软件工程与内核优化、视觉在环(vision-in-the-loop)工具调用的多模态推理、持久化助手工作流、Web 开发,以及自主执行任务。这些环境训练出一个「推理—行动—观察—验证—调整」的通用循环,往往跨越数百乃至数千次工具调用、累积数百万上下文 token。各领域、各推理力度上的专门化策略,通过多教师在线策略蒸馏 [76, 135, 29] 整合为统一模型。
要实现这一范式,基础设施必须随架构复杂度、模型规模与轨迹长度一同扩展。针对 KDA 的系统协同设计,我们开发了融合内核、KDA 上下文并行(Context Parallelism)与状态感知前缀缓存,使 KDA 在设备内、跨设备与跨请求三个层面都高效运行。针对 2.8T 参数 MoE 预训练,MoonEP 以静态计算形状与零拷贝通信实现完美均衡的专家执行,而显存高效训练与多模态编码器优化则在受限显存内维持了利用率。针对百万 token 智能体强化学习,我们的同置式(co-located)系统将部分 rollout、外部 KV 缓存保留、自适应限流与可恢复的 microVM 沙箱相结合,以保全长生命周期的模型与环境状态。最后,专用内核以及缓存感知、预算感知的集群调度,将这些创新转化为可预测的生产级服务。
由此得到的模型树立了新的开放前沿。在覆盖长周期编程、智能体、知识、推理与视觉任务的基准测试上,Kimi K3 整体落后于最强的专有系统——Claude Fable 5 与 GPT-5.6 Sol——但在我们评测套件中的其他开源与专有模型面前稳定领先,如图 1 所示。我们的贡献总结如下:
- 开放前沿的预训练。 我们训练了一个 2.8T 参数的原生多模态 MoE 模型,激活参数 104B,上下文窗口 100 万 token。KDA、AttnRes、Stable LatentMoE 与改进的数据和训练配方共同将整体规模扩展效率相较 Kimi K2 提升约 2.5×。
- 面向多推理力度等级测试时扩展的强化学习。 我们在通用、智能体与编程领域以及多个推理力度等级上开展强化学习,并将所得能力整合为统一模型。
- 面向多万亿参数、百万 token 智能的基础设施。 我们提出了 KDA 系统协同设计;用于 2.8T 参数 MoE 预训练的 MoonEP 与内存高效基础设施;面向百万 token 智能体轨迹、具备可恢复沙箱的同置式 RL 系统;以及更多基础设施创新。
- 一个开放的前沿模型。 我们开源 Kimi K3 的完整模型权重,让前沿智能可用于研究、部署与进一步创新。
2 模型架构
Kimi K3 的架构设计旨在沿三个互补的维度扩展信息流动:序列长度、网络深度与模型宽度。在序列维度上,混合注意力(Hybrid Attention)将每个块中的三个 Kimi Delta Attention(KDA,Kimi Delta 注意力)[64] 层与一个 Gated MLA 层组合,在保留选择性高容量注意力的同时,为长上下文的 token 混合提供高效机制(§2.1)。在深度维度上,Attention Residuals(AttnRes,注意力残差)[58] 使每个模块能够选择性地从嵌入、当前块以及前序各块中检索表示,将信息访问扩展到传统的顺序残差累积之外(§2.2)。在宽度维度上,每个注意力层之后接一个 Stable LatentMoE 层进行稀疏通道混合,每个 token 实际激活 896 个路由专家中的 16 个(§2.3)。在原生视觉方面,MoonViT-V2 负责编码图像与视频,一个轻量级投影器将得到的视觉特征映射到共享嵌入空间,再进入骨干网络处理(§2.4)。这些组件与 Per-Head Muon(§2.5)一起,构成了一套跨 token、跨层、跨通道扩展信息流动的统一架构。结合改进的训练与数据配方,它们使整体规模扩展效率相较 Kimi K2 提升约 2.5×。图 2 给出了该架构的总览。
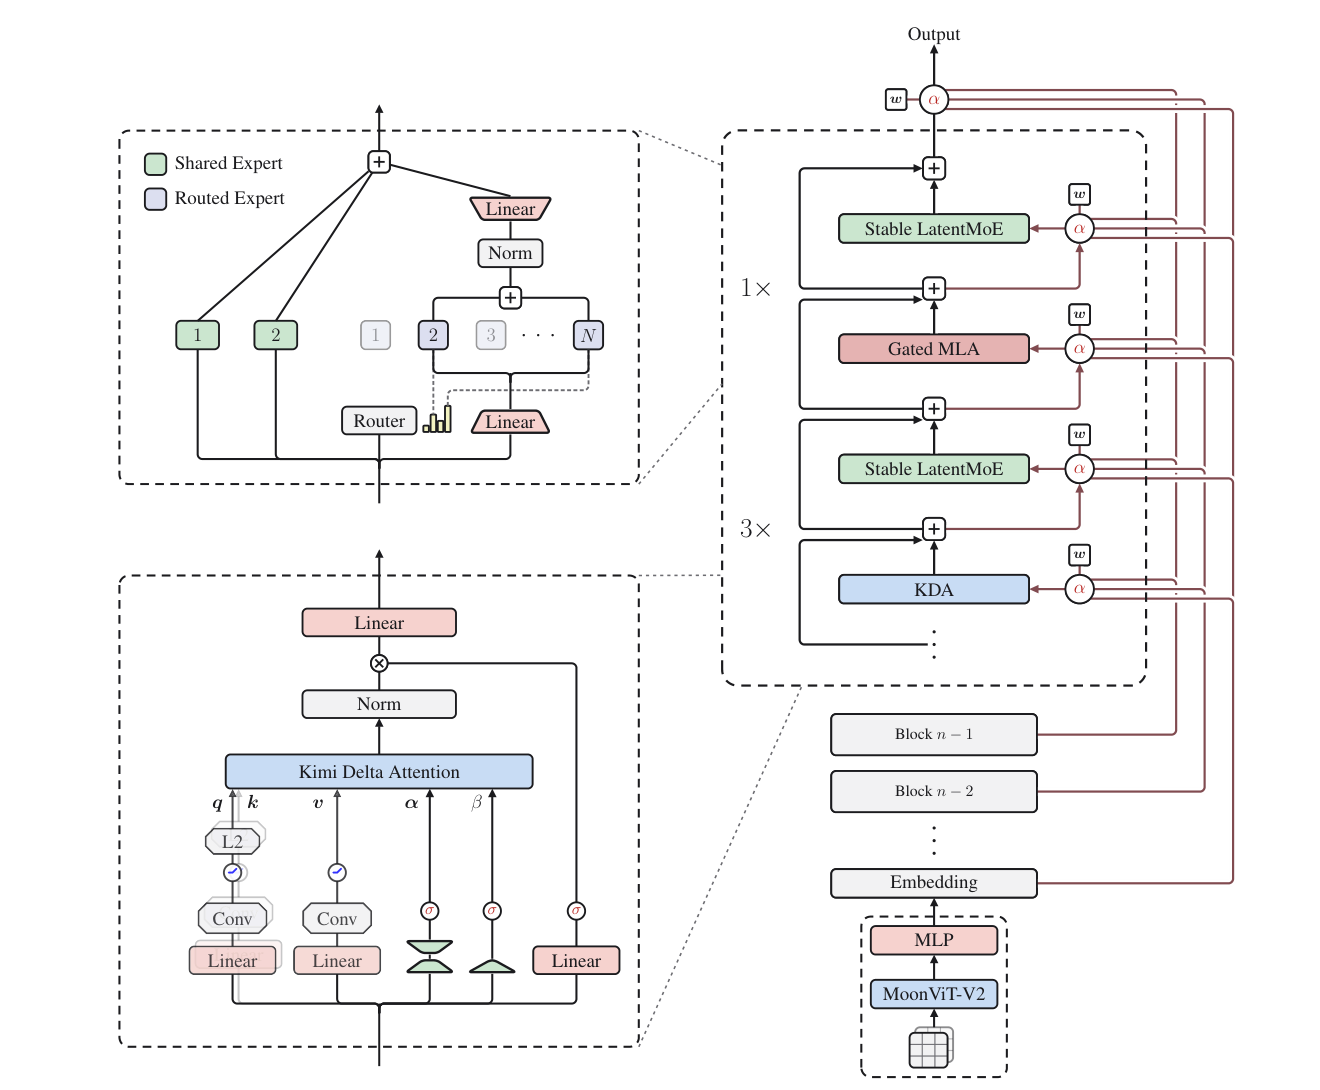
▍图 2:Kimi K3 架构总览。
Kimi K3 架构围绕 token 混合、通道混合与层混合组织,输入端带有原生视觉通路。每个块包含三个 Kimi Delta Attention(KDA)层,其后接一个 Gated MLA 层,每个注意力层都搭配一个 Stable LatentMoE 前馈网络。Attention Residuals(AttnRes)利用可学习的伪查询(w)对嵌入与前序各块的输出计算注意力权重(α),实现跨深度的选择性信息流动。左上:包含共享专家与路由专家的 Stable LatentMoE 模块。左下:KDA 模块。右下:原生视觉通路。
2.1 混合注意力
Kimi K3 采用线性注意力与全局注意力的逐层混合,将 KDA [64] 与 Gated MLA 结合。每个块包含 3 个 KDA 层,其后接 1 个 Gated MLA 层,混合比例为 3:1。该模式在整个骨干网络中重复出现。两种注意力机制分别在下文介绍。骨干网络的末端还额外放置了一个 Gated MLA 层,确保最后一层始终执行全局注意力。
2.1.1 Kimi Delta Attention
KDA 在 delta 规则递归 [106, 139] 的基础上扩展了逐通道遗忘门 [64]。考虑一个隐藏状态序列 ,其中 为 token 位置索引, 为模型隐藏维度。为清晰起见,我们首先描述单个注意力头,其查询与键向量为 ,值向量为 ,递归状态为 。KDA 在 delta 规则更新之前施加逐通道衰减:
其中, 是逐通道的单步保留因子, 控制 delta 规则的写入强度。沿用 Kimi Linear [64],KDA 将各头的相关量参数化为:
查询、键、值投影均先经过 ShortConv 再施加 Swish [139],查询与键还进一步用 L2Norm [142] 归一化。低秩投影与逐头偏置 为每个键通道产生细粒度的衰减 logit 。从 到 的下界受限映射将在下文分块形式化表述之后介绍。
分块并行形式 沿用 Kimi Linear [64],KDA 在分块(chunk)之间是递归的,在每个 chunk 内部是并行的。设 chunk 大小为 ,对 , 将第 个 chunk 中的 token 向量堆叠起来。矩阵 表示进入 chunk 的递归状态。对位置 ,定义逐通道累积衰减
与 Kimi Linear 相同, 将 逐行堆叠。UT 变换产生 与 ,由此定义伪值项 。给定进入的状态 ,chunk 中的所有输出并行计算为
对矩阵 , 将所有严格上三角元素置零,保留下三角元素(含对角线)。该掩码强制 chunk 内部的因果交互,而保留对角线是因为每个输出读取的是当前 token 更新之后的状态。 中的第一项承载来自先前各 chunk 的信息,第二项则刻画当前 chunk 内部的交互。关于 UT 变换与分块形式的完整推导,请读者参阅 Kimi Linear [64]。
下界受限的衰减 式 (4) 用倒数累积衰减 对每个 chunk 中的键进行重缩放。由于 是 区间内保留因子的连乘积,该倒数可能无界增长,并在有限精度下溢出 [141, 64]。Kimi Linear 通过在对数空间计算相对衰减、并将每个 chunk 再划分为 16-token 的二级 tile 来控制这一数值范围 [141, 64]。这样,非对角 tile 可以直接用 Tensor Core 上的稠密矩阵乘法计算;但对角 tile 仍需要显式的位置对(position-pair)计算,这依然是 chunk 内部的主要瓶颈。
Kimi K3 通过改变从衰减 logit 到每步对数衰减 的映射来解决这一瓶颈。沿用 GDN 与 Mamba-2,Kimi Linear 使用负 Softplus 映射 [139, 24, 64]。Kimi K3 则改用缩放 sigmoid,为对数衰减设定下界:
其中 是可学习的逐头对数尺度, 为固定值。我们将 初始化为 0,各偏置 按 [64, 24, 139] 初始化。在 时,每个保留因子都满足 ,一个 16-token tile 上的累积对数衰减落在 内,相应的倒数重缩放因子因此小于 ,仍处于 BF16 的动态范围之内。这一有限范围使对角与非对角 tile 都能使用稠密 Tensor Core 矩阵乘法,消除了位置对式的对角路径。该参数化方式与先前工作中的下界受限递归门密切相关 [98, 27, 92]。图 3 展示了衰减参数化的这一变化及其计算层面的影响。
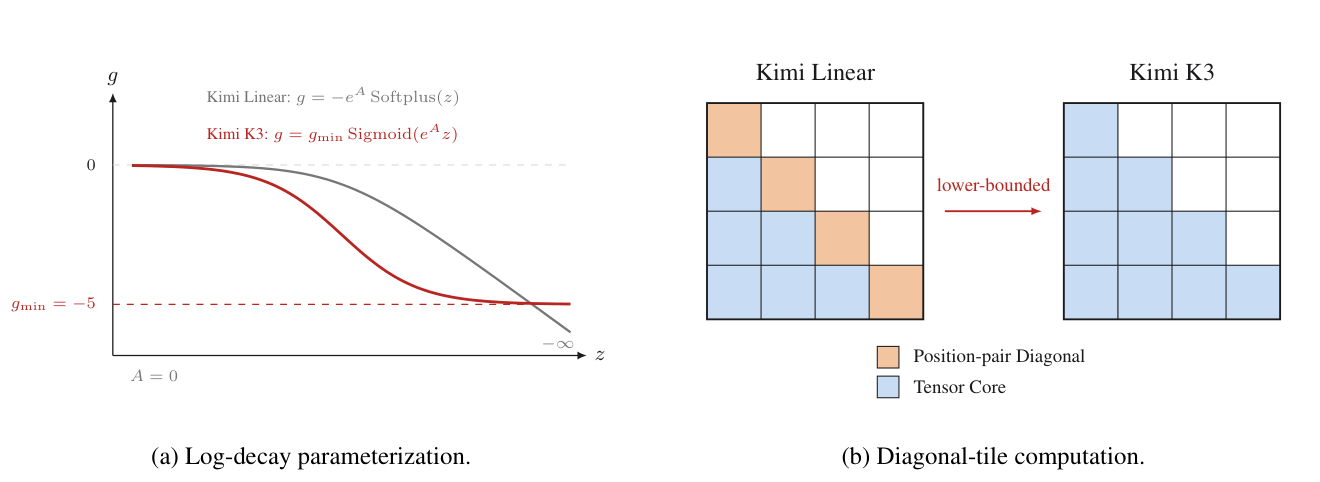
▍图 3:下界受限的衰减及其对分块 KDA 计算的影响。
(a)Kimi Linear 使用无界的负 Softplus 映射,而 Kimi K3 用缩放 sigmoid 为对数衰减设定下界;图中曲线对应 与 。(b)Kimi Linear 对每个对角 tile 进行显式的位置对计算,而 Kimi K3 中的有界范围使所有因果 tile 都能使用稠密 Tensor Core 矩阵乘法。
全秩门控 最后,Kimi K3 将 KDA 的输出门从 Kimi Linear [64] 使用的低秩参数化改为依赖输入的全秩投影。对递归输出施加逐头 RMSNorm [147] 之后,KDA 施加数据依赖的输出门控 [100]:
2.1.2 Gated MLA
多头潜注意力(MLA)由 DeepSeek-V2 [28] 提出,它将每个 token 的键值表示压缩为低维潜向量 。MLA 不再缓存完整的逐头键与值,而是缓存 ,并在注意力计算过程中通过学习到的升投影重构内容键与值。这种分解在保留全局 token 间注意力的同时降低了 KV 缓存占用。MLA 随后被 Kimi K2 与 Kimi K2.5 [59, 60] 采用,Kimi K3 则在周期性的全局注意力层中保留了它。
与 Kimi K2 和 Kimi K2.5 不同,Kimi K3 沿用 Kimi Linear [64] 的混合设计,对所有 MLA 层应用 No Position Encoding(NoPE),即不为其查询或键施加任何显式位置编码。间隔其中的 KDA 层提供位置敏感、具有近因感知的序列混合,而 MLA 层提供不受限制的全局内容交互。这种分工还避免了在扩展上下文长度时修改位置编码参数,例如重新调整 RoPE 频率基值或应用 YaRN [93]。
此外,Kimi K3 为 MLA 增加了依赖输入的逐通道全秩输出门。记 为位置 处未加门的 MLA 输出,加门后的输出为
门投影 为全秩,与 Kimi K3 中 KDA 采用的新参数化一致。该门使每个 token 能够调制从全局注意力读取的通道 [100]。
为纠正 flash attention 中产生的有偏舍入误差,我们采用 [99] 的方法,在训练期间将注意力输出保持为 FP32。这一选择会使输出 tile 的片上占用翻倍;为此我们重新设计了训练内核,将其与 KV 暂存缓冲(而非查询 tile)重叠,从而腾出共享内存,以支持更深的 KV 流水线和更高的训练吞吐量。
2.2 Attention Residuals(注意力残差)
标准残差连接 [44] 将所有先前信息沿深度压缩进单一状态 ——这一瓶颈令人联想到 RNN 在时间维度上的处境。在序列建模中,Transformer 用注意力取代了递归 [10, 126],使每个位置能够以数据依赖的权重选择性地访问所有先前位置。Attention Residuals(AttnRes)[58] 将同样的方法论应用于深度:每一层选择性地从所有先前层检索表示,而非均匀地累积它们。
全量注意力残差 对每一层 ,我们定义一个层专属的可学习伪查询 ,以及键和值
其中 是第 层的输出, 是 token 嵌入。注意力权重遵循 softmax 核 [56, 147],其中的 RMSNorm 防止输出幅度大的层主导权重:
由于网络深度不大(),这种全量形式的 计算量是可以承受的;实际开销在于为保持所有层输出可用所需的 内存(以及流水线并行下的跨阶段通信)。
块级注意力残差 为降低这一开销,我们将 层划分为 个块(block),每块 层。在块 (层索引集合为 )内部,各层输出通过求和归约为单一表示 ,其中 表示块内前 层的部分和;我们令 ,使 token 嵌入始终被纳入为一个来源。跨块时,仅对 个块级表示施加全量注意力:对块 中的第 层,值矩阵为
键与注意力权重遵循式 (8) 与式 (9)。最终输出层随后聚合全部 个块表示。在块级 AttnRes 下,内存与通信开销从 降至 ;同时这种块结构也为推理时的状态设了界,使并行的块间结果能够通过 online softmax [80] 与顺序的块内部分和更好地合并,显著降低推理时间开销。
经验上, 即可在各模型规模上恢复大部分收益 [58];对于 Kimi K3,我们将其层按每块 12 层划分为 8 个块(末块为不完整块),连同嵌入层在内共 9 个块。
2.3 Stable LatentMoE
同时扩大专家池与激活专家数量可以扩展专家特化的空间,但在传统混合专家(MoE)中,每个被选中的专家都接收完整的 维 token 表示,因此通信量与专家权重传输量随路由重数增长。LatentMoE [32] 通过将模型全宽度与路由专家宽度解耦,使这种扩展变得可负担:共享专家保留全宽度通路以承担通用变换,而专门化的路由专家在宽度为 的紧凑潜空间中运算。这使 Kimi K3 能够将通道混合扩展到 896 个路由专家、每个 token 激活 16 个专家,对应稀疏度为 56。
这种极端稀疏度放大了原始设计的两种失效模式。其一,路由通路将 、门控多分支专家前馈网络与 组合成近乎四个连续矩阵乘法的链条;这种病态结构叠加 2.8T 参数的规模,导致路由分支内部激活值爆炸。其二,对近 个专家做负载均衡,已超出现有无辅助损失偏置更新方法表现良好的区间。Stable LatentMoE 以三个组件应对这两种失效模式:在升投影之前加入 RMSNorm、采用 Sigmoid Tanh Unit GLU(SiTU-GLU)以抑制激活爆炸,以及用 Quantile Balancing(QB,分位数平衡)实现负载均衡。
如图 2 所示,该层遵循 DeepSeekMoE [23] 的共享专家加路由专家组织方式。对 ,共享专家直接处理 ,而路由通路将其投影为 ,把 分发给被选中的专家,再通过 将它们的加权聚合映射回 :
其中, 是聚合后的路由表示, 与 分别是共享专家与路由专家的前馈网络, 是由下文 Quantile Balancing 规则定义的路由器权重。Kimi K3 将每层全宽度共享专家的数量固定为 。
2.3.1 归一化 LatentMoE
原始 LatentMoE 直接对聚合后的路由表示 施加 ,而 的尺度会随被选中的专家及其路由权重变化。如式 (11) 所示,Kimi K3 改为在专家聚合与升投影之间插入 RMSNorm [147]。该归一化降低了路由分支对尺度变化的敏感性,使其在与全宽度共享分支合并之前保持稳定。除稳定训练外,额外的 RMSNorm 还持续改善了验证损失与下游基准测试。
2.3.2 Sigmoid Tanh Unit GLU
门控线性单元(GLU)用 sigmoid 激活的门调制线性值分支,计算 [26]。SwiGLU 将 sigmoid 门替换为 ,在 Transformer 中取得了很强的实证表现 [108]。SwiGLU 随后成为大语言模型中被广泛采用的 FFN 设计,尽管对其经验有效性的完整解释仍是一个开放问题。
然而,SwiGLU 的两个乘法因子都是无界的,因此大坐标同时出现时会产生激活离群值,并增加低精度算术下的溢出风险。原始 GLU 的 sigmoid 门避免了门值无界增长,但没有保留 Swish 在正区间近似线性的特性。这促使我们寻求一种既能控制大值增长、又能保留 SwiGLU 特有的局部响应与正侧响应的激活函数。近期的其他工作也探索了这一权衡的替代参数化方案 [52]。
为满足这些要求,我们提出 Sigmoid Tanh Unit GLU(SiTU-GLU)。SiTU-GLU 将平滑封顶 施加于 Swish 门的线性因子,并独立地施加于升分支:
对于 Kimi K3,我们将封顶超参数设为门分支 、升分支 。缩放后的 tanh 在原点附近近似线性、在大幅度处有界,使 SiTU-GLU 得以保留 SwiGLU 的局部响应,同时约束乘积中的两个因子。图 4 在同一切片上比较了 GLU、SwiGLU 与 SiTU-GLU 的分支定义与标量响应。
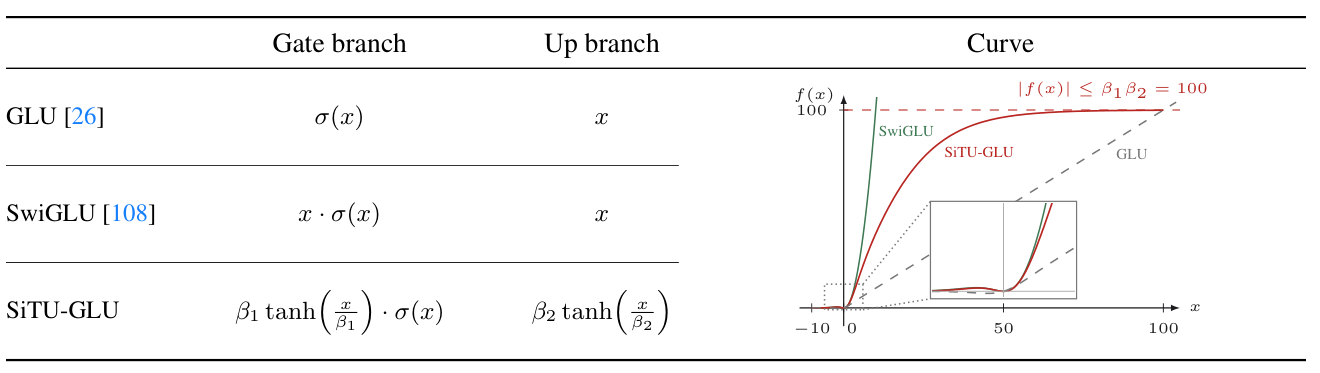
▍图 4:GLU、SwiGLU 与 SiTU-GLU 的门控分支与升分支及其标量响应。
σ 表示 sigmoid 函数。两个分支均接收标量输入 ,所有曲线共享定义域 ;插图放大了近原点区域。SiTU-GLU(红色,,)在原点附近与 SwiGLU 紧密贴合,并在较大正输入下趋近上界 ,而 SwiGLU 则无界增长。
附录 B 给出局部展开、极限情形、形式化输出界,以及与硬截断的比较。
2.3.3 Quantile Balancing
与基于辅助损失的路由 [33] 不同,Kimi K3 采用无辅助损失路由 [30]。负载均衡通过向用于 Top- 选择的路由器分数加入专家专属偏置 来实现。对 token ,路由器计算 ,并应用
由于 不出现在 中,它只调节分发,而不改变混合权重,也不影响路由器基于梯度的优化。原方法以定步长规则 [30] 更新 ,其中 在适应迟缓与负载振荡之间作权衡。随着 LatentMoE 将每层路由专家池扩大到 896 个,维持负载均衡变得更具挑战性。不均衡的路由会拖慢专家并行训练,并可能导致部分专家训练不充分 [48]。
为解决这一局限,我们提出 Quantile Balancing(QB),它根据与目标负载匹配的路由器分数分位数来设定每个专家的偏置 [112]。考虑一个包含 个 token、路由到 个专家、采用 Top- 选择的训练批次,则每个专家的目标负载为 个 token。QB 从单次前向传播中推导下一步偏置。路由将加偏置分数 上的 Top- 选择替换为 Top-:前 项是实际采用的路由,第 项则是截断值 ——专家必须超过它才能进入 token 的 Top-。从 Top- 路由中取截断值,避免了单独计算 token 侧的分位数。随后我们选取各专家偏置,使专家 恰好获得其目标负载:在截断值固定时,候选偏置 下路由到专家 的 token 数为
它关于阈值 单调递减。假设无并列,将该计数设为 意味着 是第 大的边际(margin),从而恰好有 个边际位于阈值之上。由于 ,这正是全体 token 边际的 分位数,于是得到 QB 更新
边际是从原始分数 中减去加偏置的截断值 ,因此旧偏置只通过截断值进入更新;第二行则移除一个公共偏移,该偏移不改变 Top- 选择。出于因果性,更新仅在下一步生效 [30],即一个批次绝不会用由它自身推导出的偏置来路由。图 5 展示了 、、 的情形,此时每个专家获得目标负载 。最终偏置在推理时冻结。均衡分配的推导见附录 C。
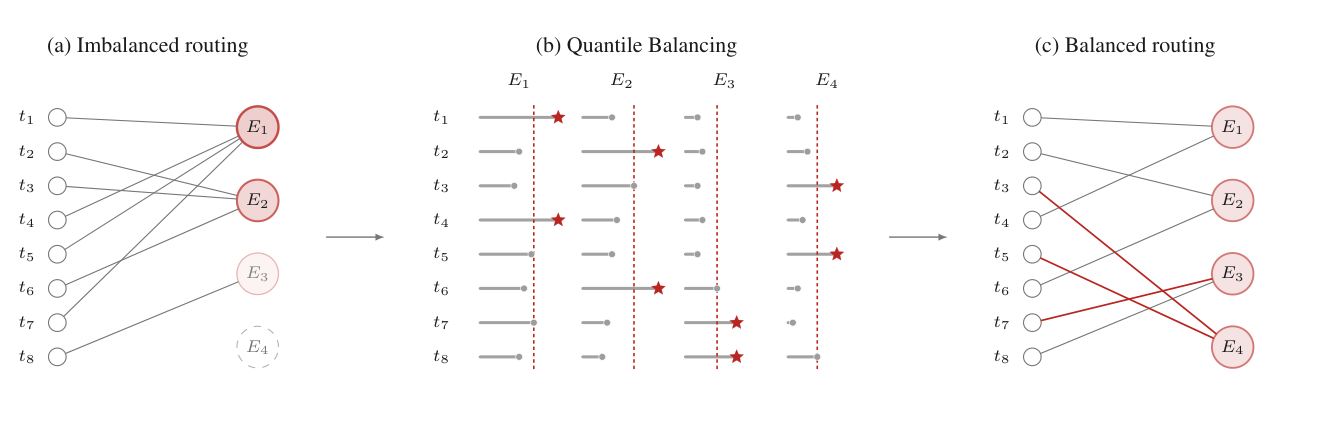
▍图 5:Quantile Balancing 示意。
以 个 token、 个路由专家、每个 token 选择 个专家为例。(a)逐 token 的 Top- 路由(左侧为 token,右侧为专家)产生负载 ;深色圆圈表示过热专家,淡化圆圈与虚线圆圈分别表示利用不足的专家与濒死专家。(b)每条灰色横杠是当前加偏置分数的边际 ,因此逐行最大值复现了(a)中的路由。每列的红色虚线是偏置调整量 ,位于第 大边际处,使得恰好 个边际超过它。标记 ⋆ 表示减去各列调整量后的逐行 Top- 选择,即(c)中的路由。(c)保留的选择产生均衡负载 ;红色边表示被 QB 改变的分配。
直方图估计 在大规模下,式 (14) 中的分位数横跨整个全局批次,其边际数量达数百万,且分散在不同 rank 与梯度累积步之间,因此在训练时收集它们以求精确分位数并不可行。我们改为从每个专家边际的直方图中读取其分位数:一次 all-reduce 对各个 rank 的分桶计数求和,再从汇总计数中恢复分位数。由于计数是可加的,无论 token 如何分片,直方图都表示汇总后的全局批次,因此该估计以分桶宽度为误差限反映整批分位数,而通信开销仅为每个专家数百个分桶。该直方图估计器是我们实际使用的方法;更详细的描述及其误差界见附录 D。
2.4 原生视觉
Kimi K3 是原生多模态的:文本、图像与视频由单一共享骨干网络在同一上下文中处理,没有事后补加的模态对齐阶段。这一设计是 §1 所述长周期、「视觉在环」行为的架构基础。渲染输出与生成它们的代码共存于同一 token 流中:模型可以编写代码,查看结果的屏幕截图或视频帧,并迭代改进视觉产物——用户界面、图形、视频——全程无需跨模型交接。
MoonViT-V2 与 Kimi K2.5 的一个关键差异是,我们完全从零开始、以下一 token 预测训练 Kimi K3 的视觉编码器 MoonViT-V2。此前的做法(包括 Kimi K2.5 本身)都以 SigLIP 等对比预训练模型初始化视觉编码器,其前提是预训练的视觉知识能让模型占得先机。我们放弃这一做法,主要出于训练稳定性的考虑。当把预训练编码器接入 LLM 时,联合优化会变得不稳定:SigLIP 初始化的 MoonViT-3D 梯度范数持续偏高且尖峰频繁,而 MoonViT-V2 在整个训练过程中保持稳定(图 6)。以下一 token 预测进行训练,还使编码器的表示直接由语言建模目标塑造,而非由偏重全局语义、牺牲细粒度文本与结构线索的对比损失塑造。值得注意的是,我们发现 MoonViT-V2 在各项视觉评测中与 SigLIP 初始化的基线相当,这表明在规模化多模态语言模型中,对比预训练并非必要的初始化手段。
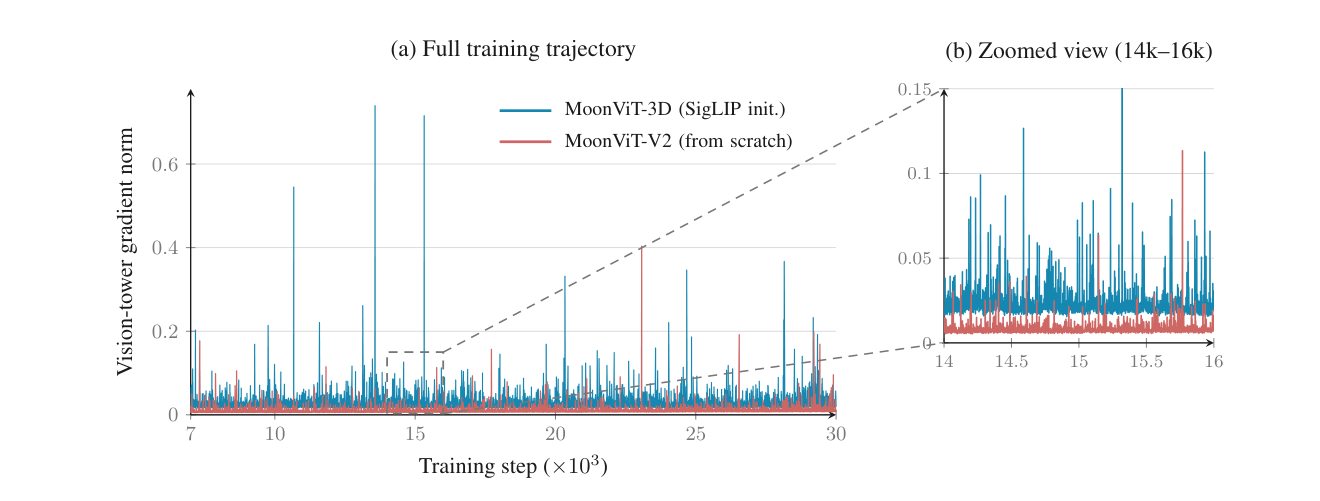
▍图 6:预训练消融实验中的视觉塔梯度范数。
与 SigLIP 初始化的 MoonViT-3D 相比,从头训练的 MoonViT-V2 保持更低的梯度范数、尖峰更少,表明优化更稳定。
架构。 这一训练配方所依托的视觉通路遵循 Kimi K2.5 [60, 62] 的总体设计:视觉输入先由 MoonViT-V2 编码,再经一个轻量级 MLP 投影器映射进 LLM。MoonViT-V2 是一个 27 层、约 0.4B 参数的视觉 Transformer,采用 RMSNorm,并移除了线性投影与注意力投影中的所有偏置项,这一设计进一步稳定了上述从零开始的优化。与 MoonViT-3D 一样,图像与视频以完全共享的参数处理:注意力被分解为帧内空间与帧间时间两个通路,时间池化进一步沿时间维度压缩 token。在投影之前,一次 2 × 2 下采样的 pixel-shuffle 操作将视觉 token 数量压缩为四分之一,使最高 3584 × 3584 像素的输入在 100 万 token 上下文中也负担得起。
2.5 Per-Head Muon
沿用 Kimi K2,Kimi K3 采用 Muon [54] 作为其矩阵参数的优化器。对于注意力投影,我们进一步将其细化为逐头(per-head)变体:不再对完整的 Q、K、V 投影矩阵施加 Newton–Schulz 正交化,而是将它们的动量矩阵沿头维度划分,对每个头的块分别做正交化。其直觉是:全矩阵正交化把所有头视为单一耦合块,梯度或动量尺度较大的头会主导共享的更新方向,而尺度较小的头则得不到充分归一化的更新;逐头正交化使各头的更新尺度趋于一致。实践中,这一设计带来了跨头更均衡的学习动态,并提升了更大规模下的训练稳定性。它还略微降低了优化器开销,因为在细长的逐头块上做 Newton–Schulz 迭代比在完整投影矩阵上更便宜。
3 预训练
3.1 预训练数据
Kimi K3 的预训练语料经过精心筛选,涵盖四大主要文本领域——Web 文本、代码、数学与知识——并配有大规模视觉语料。视觉数据覆盖图像描述(caption)、图文交错文档、OCR、感知、视频与视觉编程数据。我们的数据管线在 Kimi K2 [59] 的基础上构建,并在 Kimi K2.5 [60] 中进一步完善。
文本数据。 每个领域都结合基于规则的启发式方法、基于分类器的质量打分与去重进行过滤,各领域的采样比例通过在小模型上的消融实验确定。沿用 Kimi K2 [59] 的改写(rephrasing)方案,我们以风格与视角多样化的提示、分块自回归生成,并对照源文档进行保真度校验,对知识与数学语料进行改写。
视觉数据。 视觉语料遵循 Kimi K2.5 [60] 的分类体系,将开源数据集与自研的过滤、合成、去重管线相结合。训练期间,坐标监督同时以绝对坐标与归一化()两种格式提供,从而实现精确且对分辨率鲁棒的定位。除经典的带文本描述的图像外,我们还大幅扩展了程序化多模态数据的规模,将代码片段与其渲染出的视觉结果配对,覆盖 SVG、3D 资产、网页、游戏与 CAD 示意图等特定领域格式。
3.2 规模定律
前述各节的架构、数据与训练改进共同定义了我们的新模型家族。由于这些改动也改变了最优训练区间,我们开展了专门的规模定律研究,重新调校关键超参数,包括批量大小、学习率、token 与参数之比(TPP)以及模型形状。在留出的 OOD 验证数据上评估,规模定律曲线(图 7)表明,这些改进合计带来了相较 Kimi K2 约 2.5× 的整体规模效率提升。表 1 给出了 Kimi K2 与 Kimi K3 的详细架构对比,突出了促成这一提升的结构性变化。
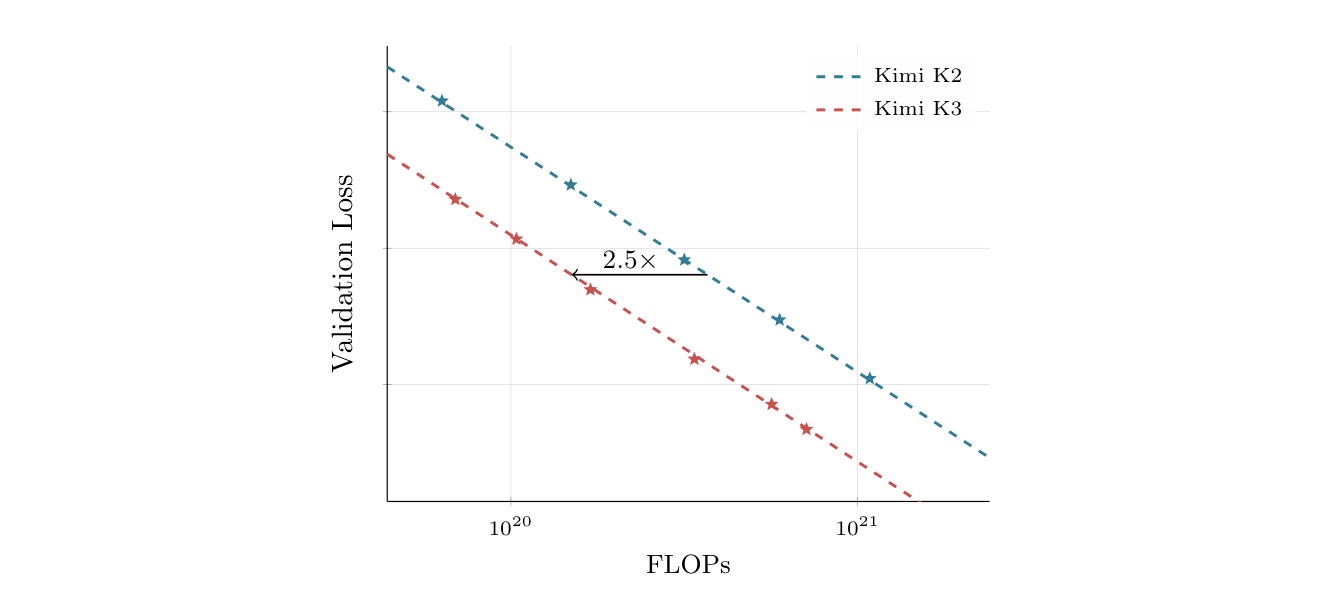
▍图 7:Kimi K2 与 Kimi K3 的拟合规模定律曲线。
Kimi K3 相较 Kimi K2 实现了 2.5× 的规模效率提升。
我们的规模定律研究一贯偏好余弦衰减(cosine decay)而非 Warmup Stable Decay(WSD)[47],因此我们将余弦衰减作为默认的学习率调度。我们在固定最小学习率的条件下对比余弦衰减与 WSD。尽管已有工作报告称 WSD 可以追平甚至超过余弦衰减,但我们观察到两种调度对应的最优超参数存在显著差异。即使在相同的模型规模与训练 token 预算下,它们各自最优的峰值学习率与批量大小也相差很大。因此,用同一组超参数比较两种调度,可能仅仅因为该组超参数与其中一方更契合而产生不公平的倾向。为确保公平比较,我们对每种调度分别独立进行规模定律搜索。在各自的最优超参数设置下,余弦衰减的最终损失始终低于 WSD。
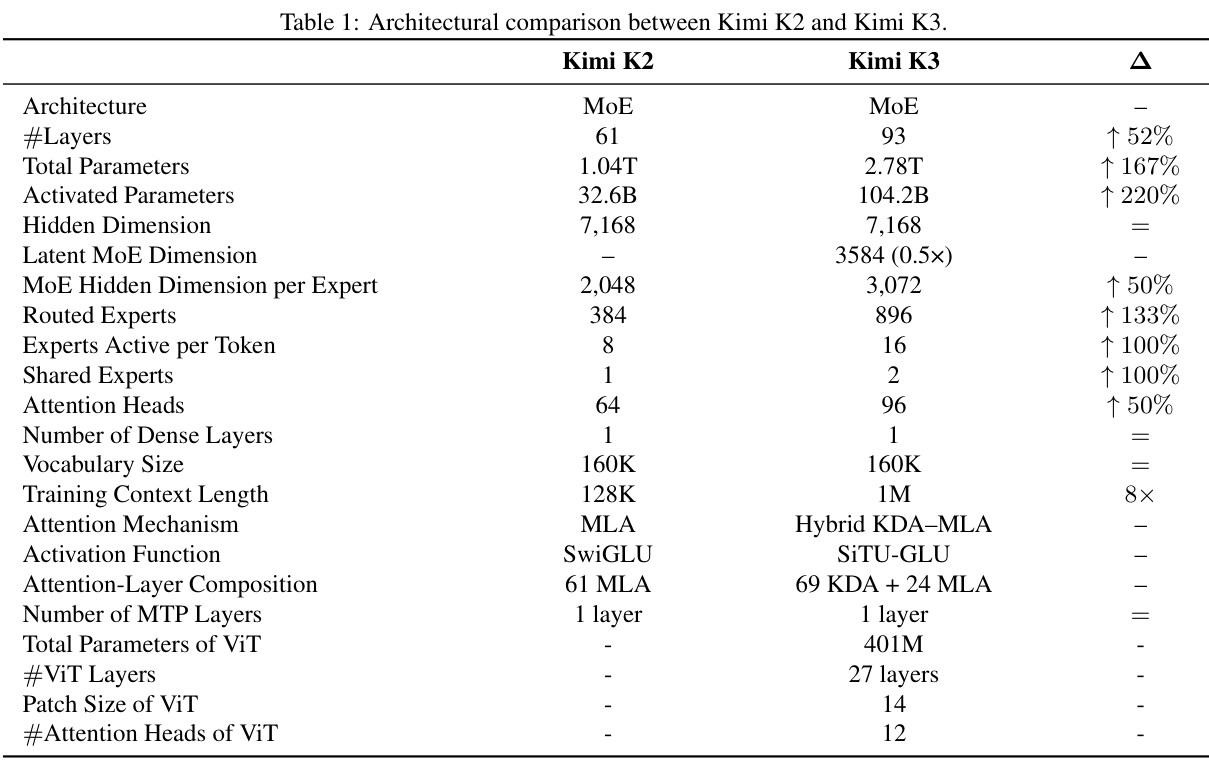
▍表 1:Kimi K2 与 Kimi K3 的架构对比。
3.3 训练配方
Kimi K3 采用原生多模态训练策略:语言与视觉从训练伊始便联合优化,而不是先训练语言模型、再事后通过对齐阶段嫁接视觉编码器。在这一范式下,视觉与文本 token 在单一的下一 token 预测目标中交错出现,使共享主干从一开始就能学习统一的多模态表示。
我们使用 Per-Head Muon 优化器(§2.5)并配合 Kimi K2 引入的权重裁剪(weight-clipping)机制优化模型,同时采用 QB(§2.3.3)进行 MoE 负载均衡。学习率采用余弦调度,含 1% 的线性预热。权重衰减全程设为 0.1。
我们的预训练以 8K token 的上下文长度开始,随后在后续训练阶段扩展至 64K token。
3.4 长上下文扩展
位置编码。 Kimi K3 不使用显式位置嵌入(NoPE),而是通过 KDA 的循环门控与衰减机制隐式编码位置信息。因此,模型无需对位置编码做任何修改(如 RoPE 重缩放或插值 [93]),即可直接外推至 100 万 token 的上下文。
长上下文数据。 来自自然来源的长文档与长视频包含大量低质量内容,包括近似重复、二进制 blob、截断文件、视频片段以及无效的机器生成日志。因此,我们通过专门的清洗管线对其进行处理:结合精确去重与模糊去重,并对视频辅以帧级感知哈希,再加上启发式与基于分类器的质量过滤以及结构校验。由于真正长且连贯的文档与视频相对短文本十分稀缺,我们对其进行上采样,使长上下文分布在 cooldown 阶段不被短序列淹没。然而,仅有长度本身并不能带来长程能力。为此,我们合成了额外的长上下文数据:精心地对多模态文档与子任务进行重排与拼接,使嵌入其中的任务只有关注到散布于完整 100 万 token 上下文中的信息才能解决。这就以预期的规模训练了注意力机制,防止其退化为局部模式。
渐进式上下文扩展。 Kimi K3 支持最长 100 万 token 的上下文窗口。我们通过随训练推进渐进扩展上下文窗口来实现这一目标,整个课程分为四个阶段。预训练期间窗口从 8K 增长到 64K token,cooldown 阶段从 256K 扩展到 100 万 token。将代价高昂的长序列计算集中在整体训练预算的一小部分内,使该课程保持经济,同时仍让模型逐步适应越来越长程的依赖。使百万 token 训练对 KDA 层可行的序列维度切分方案见 §5.1.2。
4 后训练
4.1 方法
我们的后训练管线遵循三阶段范式:通过监督微调(SFT)初始化基础智能体能力;通过强化学习(RL)在不同推理力度下培养专门的领域专家模型;再通过多教师在线策略蒸馏(Multi-Teacher On-Policy Distillation,MOPD)将这些领域专属策略整合进单一模型。
4.1.1 监督微调
SFT 阶段为后续 RL 阶段建立高质量的冷启动策略。在此前 Kimi 模型 SFT 管线 [59, 60] 的基础上,我们扩展了 Kimi K3 的 SFT 数据集,大幅拓宽了对复杂智能体任务的覆盖。具体而言,我们使用 Kimi 上一代系列中的领域专用模型合成数据轨迹,随后进行多阶段验证与人机回环(human-in-the-loop)标注。为了一致地表示这些复杂的智能体轨迹,我们使用基于 XTML 的对话模板(eXtensible Token Markup Language;详见附录 F)序列化全部数据。这些步骤共同产出了大规模指令数据集,赋予 Kimi K3 自适应推理、精确工具调用以及在长周期智能体场景中稳健执行的能力。此外,我们从 SFT 阶段起即应用量化感知训练(QAT),权重为 MXFP4、激活为 MXFP8(§4.1.4)。
4.1.2 强化学习
SFT 提供了坚实的冷启动基础,而 RL 是解锁高阶推理与执行能力的关键。我们不为单个任务训练专门的 RL 模型,而是在三大宽泛领域上扩展 RL,每个领域涵盖广泛的子任务谱系,并在每个推理力度档位为每个领域训练单一专家模型:(i) 通用任务,涵盖通用体验、视觉、推理、忠实性、搜索能力与知识工作任务;(ii) 通用智能体,涵盖长周期助手任务、深度研究与段落级写作;(iii) 编程智能体,涵盖软件工程(SWE)、编程体验、内核任务与 Web 开发。如图 8 所示,扩展 RL FLOPs 可持续提升知识、推理、视觉、通用智能体与编程等多方面的能力。将三大领域专家与 {low, high, max} 三个推理力度档位交叉组合,共得到九个专家模型。
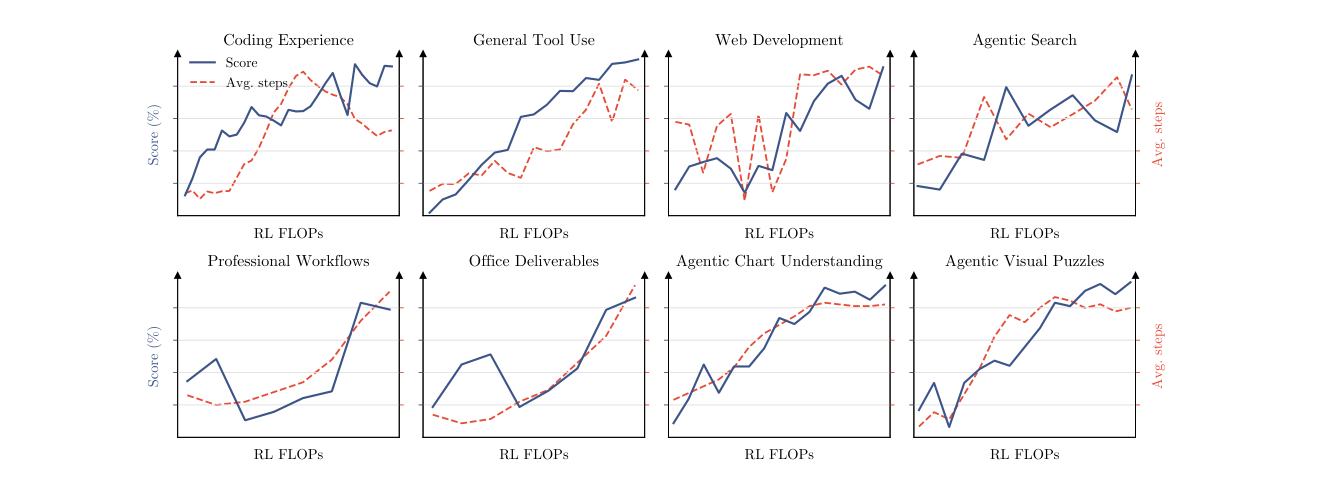
▍图 8:RL 过程中多项公开与内部评测的得分及平均助手步数。
通过扩展 RL FLOPs,工具调用步数持续增长,并伴随模型整体能力的全面提升。
算法。 为缓解在长周期任务中加剧的长尾延迟,我们扩展了同步 RL 框架 [119, 60] 中的部分 rollout(partial rollout)方案。在每次迭代的 rollout 阶段,我们为 N 条提示各采样 K 条补全,维持 N × K 条轨迹的活跃工作负载。生成阶段不等待所有 rollout 结束,而是在完成轨迹比例达到 λ ∈ (0, 1)(即 λNK 条)时立即暂停,使策略优化无需受执行拖尾者的拖累即可推进。被暂停的 rollout 进入队列,并在下一次迭代开始时优先恢复,这由我们的沙箱基础设施(§5.3.2)提供支持。一旦某条提示的 K 条响应全部完成,它们会立即被派发用于策略优化,策略优化沿用 Kimi K2.5 [60] 的算法。
在我们的部分 rollout 方案下,单条长周期轨迹自然横跨多次迭代,由此引入的数据陈旧性会威胁训练稳定性。我们的策略优化算法通过逐 token 正则化,天然容忍这种极端的离策略(off-policy)状态。该正则化将策略更新约束在局部邻域内,使算法能够稳健地处理高度陈旧的数据,维持训练稳定性。
推理力度 RL。 为在最大化 token 效率的同时精细调节推理力度,我们在 RL 中实现了逐问题的预算控制机制 [60]。我们为每个问题 关联一个由冷启动模型估计的初始 token 预算 ,并将总 token 预算 超过缩放阈值 的轨迹的任务奖励覆写为 。对通用任务, 计量思考 token 的数量;对智能体任务, 计入累计输出 token,包括推理轨迹与工具调用参数。训练遵循关于预算乘数 的分阶段课程。我们首先以相对较大的 训练 max 预算变体,同时对最大预算设上限以抑制过度思考;随后将 退火至更小的值,得到 high 与 low 档位的专家模型。 的调整按领域配置,并在人机回环指导下进行。由这些专家在各推理档位产出的轨迹被联合收集,用于监督微调与多教师在线策略蒸馏。
智能体生成式奖励模型。 对不可验证的通用任务,我们采用智能体生成式奖励模型(GRM),沿用 Kimi K2.5 [59, 60] 中以二元对比进行的锦标赛式分组奖励。除用于增强判断力的通用智能体能力外,智能体评审还必须遵循一套强制协议:(1)阅读结果、产物或文本输出;(2)生成评分细则(rubric);(3)依据评分细则为每个候选打分;(4)将评分细则给出的分数记录在记分板(scorepad)中。为缓解输出日益冗长的奖励投机(reward hacking)倾向,我们施加与上述推理力度控制类似的基于预算的冗长度控制:给定由冷启动模型估计的初始冗长度 与乘数 ,输出长度超过 的候选在二元对比中自动判负。
4.1.3 多教师在线策略蒸馏
我们采用多教师在线策略蒸馏(MOPD),将这些跨推理力度的领域专用能力整合进统一模型 [76, 135, 29]。训练期间,对给定领域 与采样的推理力度档位 ,优化由九个专家中对应的教师模型 指导。给定输入查询 与前缀响应 ,在 上评估的教师 与学生 之间的逐 token OPD 奖励定义为:
其中 表示停梯度(stop-gradient)算子, 为裁剪阈值,用于约束极端优势信号,从而稳定 RL 训练。这一稠密奖励信号无缝融入我们的 RL 框架,自然支持长周期任务部分 rollout 训练等基础设施级优化。我们也实验过更细粒度的 top-k 蒸馏目标,但在我们的设置下,无论收敛速度还是最终性能都未见明显优势。
4.1.4 面向部署的后训练
MXFP4 量化感知后训练。 为降低部署时的显存占用与服务成本,我们将占据模型参数显存主体的 MoE 专家权重量化至 MXFP4 [104],激活以 MXFP8 计算,而所有非专家组件(注意力投影、latent MoE 投影、共享专家与 MoE 路由器)保持更高精度。我们在整个后训练阶段(覆盖 SFT 与 RL)全程执行量化感知训练(QAT)[50],使模型适应量化引入的精度损失。RL 期间,rollout 与训练共享同一量化方案,消除了训练-推理不一致。
草稿模型微调。 优化推理效率对服务复杂的长周期智能体模型至关重要。Kimi K3 预训练时带有一个结构与主干块相同的多 token 预测(MTP)层。由于 EAGLE-3 [72] 的草稿模型由单个解码器层构成,其结构与 MTP 层一致,我们将预训练的 MTP 层微调为 EAGLE-3 风格的草稿模型:目标模型冻结,仅更新草稿层及其特征融合投影。遵循 EAGLE-3 的训练时测试(training-time test)协议,草稿模型在训练中展开七步;除第一步外——该步最新位置的目标侧特征尚不可用——草稿模型消费自身更早步的输出,与推理时的循环起草过程一致。
草稿输入融合目标模型的低层、中层与高层特征,分别取自第 1、第 4 与最后一个 AttnRes 块的输出(§2.2)。这些特征被拼接并经无偏置矩阵 投影到隐藏维度; 初始化为 ,使融合表示在初始化时与高层特征 一致——即 MTP 层预训练时所依赖的输入——并在微调过程中逐渐学会纳入低层与中层特征。
投机解码的加速比由无损投机采样下的逐 token 接受率 决定,其中 与 分别为目标模型与草稿模型的下一 token 分布。由于对一个容量受限的草稿模型,最小化常规的 KL 散度代理目标并不保证最大化该接受率,我们直接优化基于似然的 LK 损失 [105],即接受率本身的负对数:
其中 与 在温度 1 下评估,且不附加额外的真实标签交叉熵项。草稿微调遵循后训练的 QAT 配置(§4.1.4):MoE 专家权重为 MXFP4,其输入激活为 MXFP8,非专家模块保持更高精度。
4.2 RL 任务合成与智能体环境
我们 RL 框架的有效性高度依赖于丰富、多样且可稳健验证的环境。为支持复杂长周期任务上的可扩展训练,我们设计了一系列专门的白盒环境与任务合成范式。
4.2.1 统一白盒 RL 环境
用单一固定的智能体 harness 训练,会使模型过拟合到特定的工具 schema、系统提示、上下文管理机制或交互协议。为此,我们开发了统一的白盒 RL 环境,将智能体 harness 表示为一组可配置、可组合的模块,包括工具接口、系统提示、上下文管理策略、技能、记忆、子智能体及其他组件。通过配置组合这些模块,该环境可以实例化 Kimi Code [57]、Claude Code [15]、Codex [20]、OpenClaw [87]、Hermes [45] 等主流 harness,以及全新的 harness。RL 训练期间,我们动态地为不同任务组构建不同的 harness 配置,让 Kimi K3 接触这些模块的多样组合,而非任何单一 harness 的惯例。同一抽象也直接支持跨多种任务领域的 RL,为训练更通用的智能体提供了可扩展的基础。
4.2.2 知识图谱引导的任务合成
动机与概览。 后训练任务的质量与多样性在很大程度上取决于其来源材料。由细粒度概念引导的检索能浮现专门且代表性不足的知识,而跨多样概念的采样则拓宽领域覆盖。为在规模化条件下同时控制粒度与覆盖度,我们构建了一个自我进化、层级化组织的知识图谱,由智能体在知识密集与编程领域中通过网络级探索持续扩展。图 9 展示了任务合成管线。
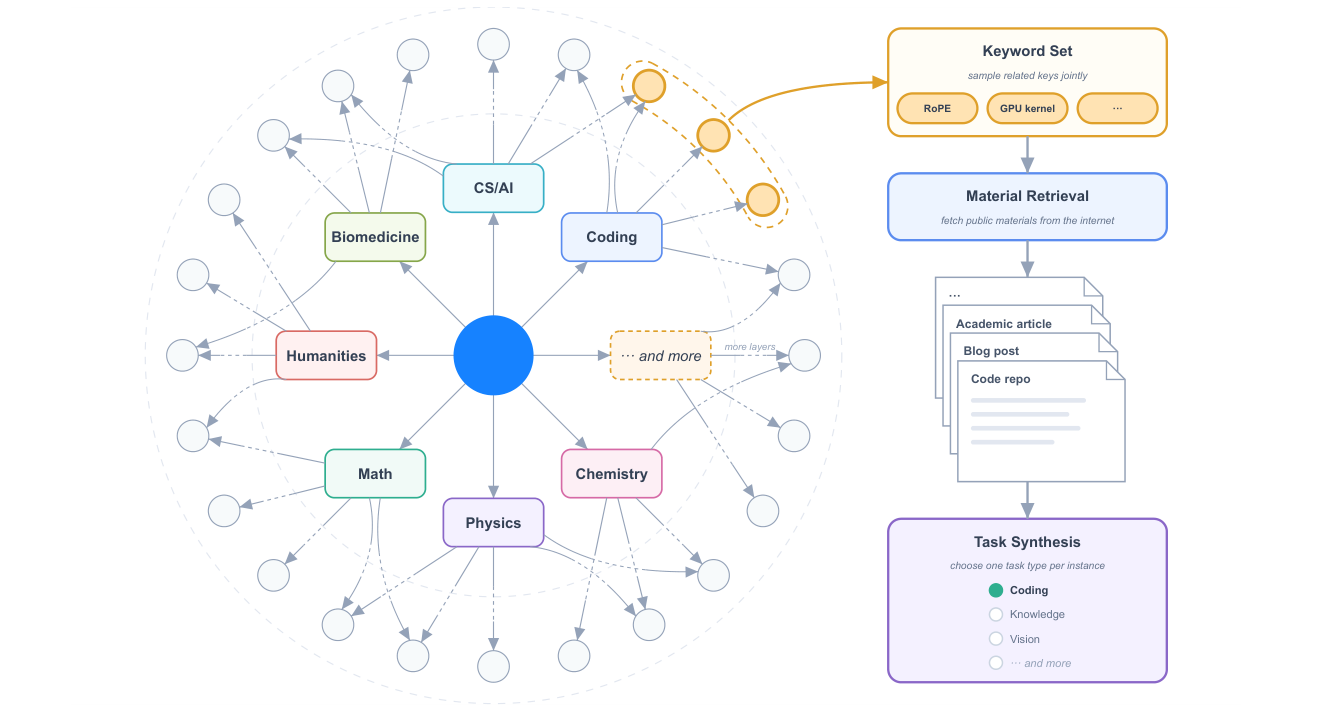
▍图 9:知识图谱引导的任务合成概览。
层级化组织的知识图谱表示多个层级的概念,从宽泛领域到细粒度概念。通过采样相关节点形成关键词集合,指导公开可得的来源材料的检索。对每个合成实例,系统选择一种任务类型,并利用检索到的材料合成相应任务。
智能体式知识图谱构建。 我们将知识图谱构建为有向无环图,通过递归的、智能体驱动的扩展完成。扩展过程从一组预定义的粗粒度种子节点开始。随后为每个节点分配一个智能体实例,执行多轮网络搜索以调研对应概念。添加新节点前,智能体会探索已有图,识别等价或相关概念,在适当处复用已有节点,以最小化重复。无论智能体先发现哪一端,边始终从较粗概念指向较细概念。新加入的节点随后被分配给智能体做进一步探索。当负责的智能体判定当前概念已足够原子化时,该分支停止扩展。
材料检索与任务合成。 为在领域与任务类型上达到目标分布,系统以不同粒度采样节点,或单独采样,或按相关组合采样。由采样节点派生的关键词与其在知识图谱中祖先节点的上下文信息相结合,构成网络查询。检索到的真实世界材料被组装起来,由合成智能体产出各种任务类型的训练任务。
4.2.3 智能体环境中的可验证问题
我们在智能体环境中的可验证问题上训练 Kimi K3;代表性例子包括:多步复杂信息检索——模型规划研究方案、逐步从网络收集证据并产出可验证的答案;专业人士的真实日常工作,如投资银行、数据分析与法律实务——模型拆解复杂请求、在沙箱中操作领域工具,并在数十到数百步内完成交付物;以及围绕 STEM 问题、视觉谜题与图表理解的多步可验证视觉推理。每条视觉推理轨迹都在配备 Python 解释器的隔离沙箱智能体环境中生成:模型迭代地编写并执行代码来裁剪、缩放或变换输入图像,进行精确计算或验证中间结果,并在多轮交互中将执行输出——包括生成的图像——作为新观测接收。随着模型学会执行更多图像操作并收集更多观测,其在复杂视觉推理任务上的表现稳步提升。
4.2.4 内核优化任务
为强化 Kimi K3 的 GPU 内核优化能力,我们构建了大规模内核任务集,从单算子内核到融合巨型内核(fused mega-kernel)不等,素材来自 Flash Linear Attention [140] 等高质量 GitHub 仓库。该任务集涵盖多种 GPU 编程路径,如 CUDA、Triton、CuTe DSL、Gluon、ThunderKittens [111] 与 TileLang [130],并覆盖广泛使用的 GPU 架构与数值格式,包括 BF16、FP8 与 FP4。奖励同时评估正确性与性能:每个内核提供 PyTorch 参考实现,超过预定义数值误差阈值的解答获得零奖励。性能对照专家实现打分:与专家实现持平得 0.5 奖励,接近硬件 roofline 则奖励趋近 1。为确保奖励反映真实的优化,我们开发了作弊检测系统,惩罚 CUDA 图重放、输入缓存与精度降级等奖励投机策略,并在 Kimi K3 开发过程中观察到新的投机策略时持续扩展新的防护。
4.2.5 个人助手任务
针对长周期个人助手任务,我们开发了 Gmail、Notion、Slack、Canvas 等广泛使用应用的高保真模拟实现。它们保留真实应用的核心语义,同时支持可复现的大规模交互,无需外部 API,也不受限速约束。基于这些模拟应用,我们设计了受人力资源、法律服务与金融等场景真实职业流程启发的复杂任务。每个任务中,智能体在持续演进的环境中跨多个模拟日运行,遭遇分布在各应用中的数十个相互依赖的事件。单次 rollout 可能涉及多达数千次工具调用与数百万上下文 token。每个事件带有各自的评估标准,由确定性规则或基于 LLM 的评估器评定。初始工作区由智能体构建:它们自主搜索网络获取参考材料,并将其转化为连贯且与任务相关的环境。我们还扩展了 RL 框架以支持此类「活」环境,对复杂事件流及其引发的世界状态转移进行建模。
4.2.6 自主执行任务
我们提出自主执行任务(Autonomous Execution Tasks,AET)——一种通过环内验证(verify-in-the-loop)优化来训练长周期智能体智能的环境范式。每个任务指定初始状态、受约束的目标、基于工具的动作空间、执行预算与独立验证器。智能体只能看到目标、上下文、约束与验证接口,没有参考轨迹或预定义流程,必须自主完成任务分解、工具选择、规划、错误恢复与终止。奖励基于验证器对最终环境状态的评估,而非智能体自我报告的完成情况。我们设计了多种类型的验证器以支持多样环境,包括黑盒系统复刻(图 10)、量化因子挖掘与税务审计。在每个环境中,智能体迭代地提交解答、接收验证器反馈并改进策略,训练出「假设—行动—分析反馈—适应」的通用循环。奖励投机通过以下方式缓解:将智能体与验证器隔离;将提供诊断反馈的公开验证器与评估留出场景的隐藏验证器配对;以及在有限提交预算下施加惩罚式奖励。
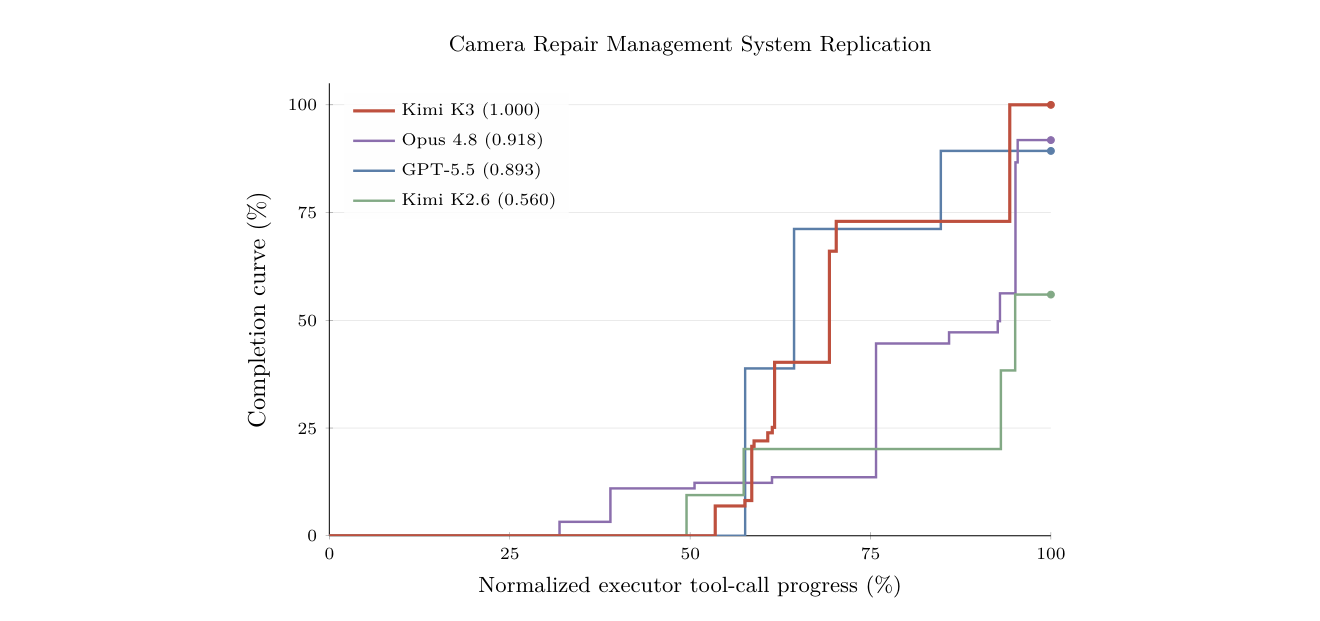
▍图 10:相机维修管理系统(Camera Repair Management System)上的完成度曲线。
该任务为黑盒系统复刻任务:智能体通过 oracle 查询,将一个隐藏的 3D 相机维修系统重构为 Web 应用。完成度(Completion)表示由验证器评估的任务进度。
4.2.7 Web 开发任务
我们构建了一套多样的、由专家精选的 Web 开发任务集,覆盖典型场景。输入从一句话场景描述到多段规格说明不等;产物横跨网站、交互式游戏、3D/WebGL 场景、数据可视化、SVG 与全栈应用。每个任务都在容器化沙箱中运行,并在多样的智能体 scaffold 而非单一固定 harness 下进行 rollout,以促进跨 scaffold 泛化。奖励由两部分组成:确定性检查与内部奖励模型的模型评判。确定性检查对应用行为做功能测试,并对复刻参考的任务评分结构级与像素级相似度。项目构建失败、运行出错,或伪造而非真正实现产物时,奖励清零。模型评判使用其他模型进行源代码审查,或查看输出产物并与之交互。
5 基础设施
Kimi K3 将三个极少同时出现在单一模型中的系统挑战集于一身:混合 KDA 注意力、3T 级稀疏多模态训练与推理,以及百万 token 级智能体工作负载。我们的基础设施围绕这些挑战,在模型的整个生命周期内进行协同设计。在架构层面,高性能 KDA 内核与上下文并行(Context Parallelism)使循环形式(recurrent formulation)在设备内与跨设备、在训练与推理中都高效运行。在预训练阶段,均衡的专家执行、更低的显存占用以及通信重叠调度,在大规模下维持了高利用率。在百万 token 智能体 RL 阶段,分层状态管理与可恢复的沙箱执行在迭代之间保全了长轨迹。最后,状态感知的 KDA 前缀缓存、专用推理内核,以及缓存感知与预算感知的调度,将这些效率转化为可预测的生产级服务。
5.1 KDA 的算法-系统协同设计
KDA 用固定大小的循环状态 (§2.1.1)取代 softmax 注意力中不断增长的键值缓存:其串行更新给并行执行带来挑战,但换来的是一个传输与复用代价都很低的固定大小状态。下面的设计在两个执行层面上应对前者并利用后者:设备内的融合内核,以及跨设备的 KDA 上下文并行。
5.1.1 覆盖各执行场景的 KDA 内核
KDA 状态的串行依赖与 GPU 对宽而均匀并行的偏好相冲突,并且在每种执行场景下表现为不同的瓶颈。我们为每种场景设计了专用内核。
面向训练与预填充的分块(chunkwise)内核。 KDA 的分块形式在块内并行、跨块串行,因为循环状态必须逐块传播。若朴素执行,这两个阶段交替进行,SM 会在串行传播期间空转。因此我们开发了 FlashKDA [14]——一个基于 CUTLASS 的分块内核,将块内计算与跨块状态传播重叠执行。该内核把工作分解为 token 并行的各阶段与一个头并行的循环(recurrence),二者各自独立调度与调优,性能大幅超越 Triton 参考实现。FlashKDA 同时服务于训练与推理预填充,并作为 flash-linear-attention [140] 的后端被自动派发。
面向长上下文预填充的设备内上下文并行。 张量并行(TP)将注意力头划分到不同设备,但不会缩短循环本身;因此在纯 TP 部署下,当每个 rank 只持有少数几个头时,超长序列的预填充会让大部分 SM 空转。关键观察是:每个分段的状态转移可以独立于传入状态求值,并在其后精确复合。因此,一个自动的 SM 级上下文并行(CP)规划器 [143, 140] 将序列划分到单个 rank 的各 SM 上,并行求值各分段的状态转移,再将其合并以恢复每个分段的精确初始状态。与 §5.1.2 的跨设备 KCP 不同,这种并行完全发生在设备内,不产生任何跨设备通信。
KDA 解码面临与训练和预填充截然不同的挑战,我们将在 §5.4.2 中详细讨论。
5.1.2 KDA 上下文并行
上下文并行的通信开销在 softmax 注意力与线性注意力之间存在本质差异。softmax 注意力要求各 rank 交换键值块,其大小随序列长度增长 [73]。线性注意力则将此前的上下文承载于固定大小的循环状态 之中。以往的上下文并行方法利用普通线性注意力的加性循环:在每个 rank 上计算本地 token 从 出发产生的状态,再将这些局部状态在前面各 rank 上求和,以恢复传入状态 [115, 114]。然而,这种直接求和对 KDA 并不成立。由式 (1) 可知,KDA 按 更新状态,其中 。KDA 的 delta 规则在写入当前内容之前,先将依赖于 token 的矩阵 作用于传入状态。因此,一个局部序列分段的效应取决于进入该分段的状态,无法仅由从 算出的状态确定。
为保留这种依赖,我们提出 KDA 上下文并行(KDA Context Parallelism,KCP),将每个分段的效应分解为两个可本地计算的量:一个作用于传入状态的累积转移,以及一个从零状态本地生成的状态。沿用 §2.1.1 的分块记号,我们用 表示 rank 的分段内经过 个局部 token 后的循环状态,于是 表示离开 rank 、进入 rank 的状态;用 表示同一循环改从 出发得到的状态。对于进入 个上下文并行 rank 中第 个的任意状态,经过 个局部 token 后的状态为
其中 表示前 个局部 token 的累积转移。第一项包含本地 token 生成的状态,第二项则通过本地的 KDA 更新传播来自此前各 rank 的上下文。在 时, 与 这两个量都可以在 可用之前、仅用本地 token 算出,它们正是各 rank 之间交换的片段。
式 (17) 中的求和表明,每个状态都完全由本地计算的片段复合而成。这些 rank 级更新满足结合律,因此每个 rank 的传入状态都可以通过前缀扫描(prefix scan)[78] 恢复。每个 rank 先在本地计算 与 ,再通过一次 all-gather 交换这两个张量 [140]2。all-gather 之后,rank 通过按序处理同一文档中位于其前的片段来重建 :从 出发,对每个片段施加 。因此,KCP 只需一次固定大小的 all-gather 即可完成循环状态同步,并实现线性的计算扩展。
5.2 3T 级预训练基础设施
Kimi K3 的预训练结合了带虚拟阶段(VP)的流水线并行(PP)[49, 82]、专家并行(EP)[67]、ZeRO-1 数据并行 [101]、流水线 ZeRO-2 梯度分片 [146] 与上下文并行(CP,§5.1.2)[51]。MoE 层采用在各 EP rank 上复制的共享专家,专家分发(dispatch)与合并(combine)的 all-to-all 通信与计算重叠执行,以隐藏其延迟。
3T 级的原生多模态预训练带来三个关键问题:(i) 各 EP rank 之间 token 负载不均;(ii) 激活、梯度与优化器状态超出显存预算;(iii) 视觉编码器高度可变的计算暴露在关键路径上。以下小节依次解决这些问题:完美均衡的专家并行 MoE 训练(§5.2.1)、显存高效训练(§5.2.2)与多模态编码器优化(§5.2.3)。图 11 展示了最终的执行调度。
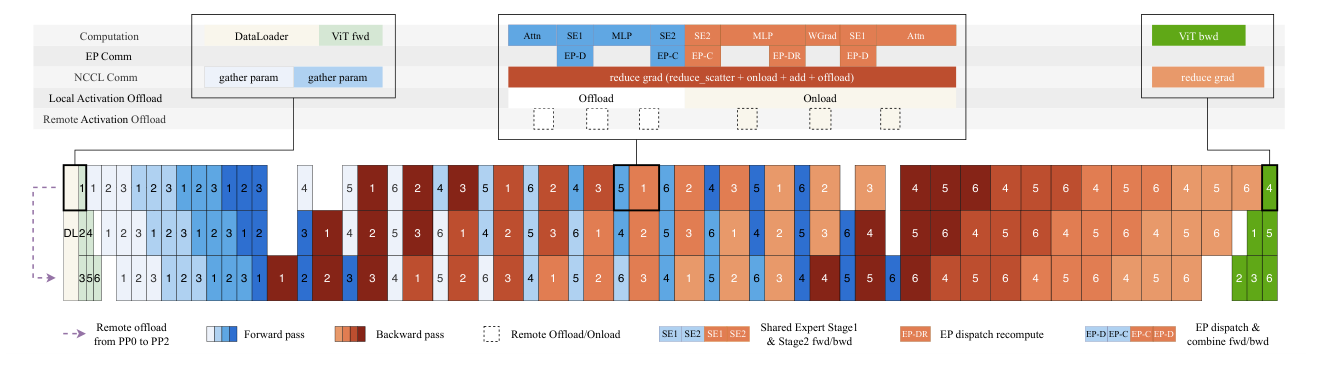
▍图 11:不同流水线并行(PP)阶段中计算、通信与卸载的重叠。
5.2.1 完美均衡的专家并行 MoE 训练
传统 EP 方案中,各 rank 的 token 负载不均。由此产生的计算不均衡会降低训练吞吐量,而路由专家激活形状的动态变化还会造成严重的显存碎片。因此我们提出 MoonEP3——一种借助动态冗余专家实现完美负载均衡的 EP 方案。MoonEP 保留了 DeepEP [148] 等传统方案的整体计算流程,并额外引入冗余专家的在线规划与迁移。前向传播时,我们根据当前微批次、当前层的路由器输出规划冗余专家,并在路由专家计算之前预取它们;反向传播时,我们先将它们的梯度暂存于本地归约缓冲区,待计算完成后再归约回其所属 rank 的梯度缓冲区。
有限冗余专家实现完美均衡。 MoonEP 要求每个 rank 恰好收到 个 token,其中 为序列长度, 为每个 token 选择的专家数,从而所有 rank 执行完全相同的计算量。关键问题是:需要多少冗余专家才足以保证这种均衡。设专家数为 、EP 规模为 。我们证明,每 rank 至多 个冗余专家即可保证均衡方案总是存在,且该上界基本是紧的(§E)。因此,为每个 rank 预留 个冗余专家槽位,即可保证规划始终有可行解,训练永不中断。相比之下,ECHO [138] 与 UltraEP [133] 等先前工作预设冗余专家数量,或施加每 rank 的 token 上限:一旦在限额内找不到可行方案,训练就被迫停止;而且限额本身需要人工调参,并仍会残留负载不均。
在线规划。 在每个训练步都计算精确最优解的代价过高。因此,我们用整数线性规划(ILP)对若干代表性情形离线求出精确解作为参照,并设计了一个 GPU 规划内核:它接近最优、开销可忽略,且始终遵守 上界。
零拷贝通信。 完美均衡还简化了通信路径。我们实现了融合的 permute/unpermute 算子:规划内核预先算出每个 token 的目的位置,token 被直接发送到远端 rank 上按专家分组的位置,通信缓冲区的视图则直接返回给计算,消除了中间拷贝。在最坏不均衡情形下,DeepEP 要支持同样的免拷贝数据路径,需要大小为 的通信缓冲区;而 MoonEP 凭借完美均衡,只需固定大小的 缓冲区。
静态形状下的无同步执行。 传统 MoE 实现中,每个专家的 token 数随训练步与层变化,主机必须在每层与设备同步以获得实际计算形状,才能启动专家计算,导致层间流水线停顿。有了完美均衡,每个 rank 恰好收到 个 token,所有层的计算形状都静态已知。这消除了逐层的 MoE 主机同步,也减轻了主机端的内核启动开销。
专家 GEMM 调度与重叠。 即使各 rank 的总负载完美均衡,每个 rank 内部各专家的 token 数仍然倾斜;若采用固定顺序、不感知负载的调度,这种倾斜会转化为各 SM 工作单元之间不均衡的完工时间(makespan)。因此,我们用一个负载感知的调度器来调度路由专家 GEMM:它在启动前根据当前 token 分布调整自身参数,并在执行期间保持参数不变。一个轻量级启发式方法基于硬件指标的解析代价模型选取这些参数,关键系数通过离线自动调优标定。对于共享专家,我们把它们的 GEMM 派发到独立的流上,使其与其他内核重叠执行。
5.2.2 显存高效训练
统一激活管理器。 我们为激活设计了统一的存储抽象:每个为反向传播保存的张量都关联一个可插拔的存储后端。重计算、量化与卸载/远程卸载都只是该抽象下的存储策略,可在张量粒度上自由组合;策略通过张量上的轻量标注声明,与模型代码完全解耦。重计算以函数粒度执行,支持跨层重计算。在我们的实现中,所有 GPU 显存都在主计算流上分配,并在单一显存池中管理,避免了多流碎片与主机侧开销;激活以层粒度预取回来并与计算重叠,引入的额外开销可忽略。在 Kimi K3 中,大多数激活采用分块 FP8 量化 [59, 30] 并结合卸载/远程卸载,逐元素算子则配置为重计算。
显存高效 MoE。 在原生 MoE 实现中,置换后概率(permuted probs)的梯度计算依赖前向输出 output。受 SonicMoE [42] 启发,我们通过一次数学变换将该梯度改写为只依赖中间激活 act_output 与上游梯度 doutput 的形式,以一次额外的轻量逐元素计算为代价,消除了反向传播对 output 的依赖。此外,在分组 GEMM 的前向中,我们只保存分发(dispatch)操作的输入;反向时通过重算 dispatch 恢复分组 GEMM 的输入。如图 11 所示,这次重算引入的通信可以与部分分组 GEMM 反向计算重叠,从而以可忽略的代价消除了这部分激活存储。
显存高效的注意力残差。 针对注意力残差,我们基于 Block AttnRes 设计了配套优化。块表示在边界层生成一次,由后续所有层共享,直接驻留于 GPU。AttnRes 计算整体用检查点(checkpointing)包裹,因此每层为反向传播保存的激活与标准残差架构完全一致。对于流水线并行,我们采用基于缓存的流水线通信 [58]:只有新生成的块在阶段间增量传输,并在所属微批次结束后立即释放,显存占用达到理论下界。
跨 PP rank 平衡激活。 在交错式 1F1B 流水线并行下,由于流水线预热,激活在各 PP rank 上分布不均,驻留激活数量随 PP rank 增大而减少。为避免显存溢出(OOM),我们使用 Mooncake Transfer Engine [97] 将激活远程卸载到其他 PP rank 的显存中,实现各 PP rank 之间均衡的激活显存占用。
流水线 ZeRO-2 梯度分片与卸载。 除激活外,我们使用流水线 ZeRO-2 梯度分片 [146] 将梯度切分到各数据并行(DP)rank。此外,我们将分片后的梯度存入 CPU 内存以降低 GPU 显存峰值,同时在 GPU 上保留 double grad buffer(双份梯度缓冲区)。梯度跨 DP rank 归约进入 double grad buffer 之后,再累积到 CPU 上的分片中。
基于 P2P 的 Muon 正交化。 分布式优化器将参数均匀切分到各 DP rank,而 Muon 中的 Newton–Schulz 正交化需要完整的参数矩阵,因此每次更新前都需要一步通信来收集完整参数。朴素做法是在每个 rank 上对整个参数缓冲区执行 all-gather [74],这不仅带来巨大的显存占用,还使通信成为规模化下的主要瓶颈。我们的做法是:每个 rank 只通过与相应属主 rank 的点对点(P2P)通信,取回本地所拥有的参数分片,从而消除完整参数缓冲区,同时降低显存占用与通信量。通信与计算进一步以模型块(model-chunk)缓冲区为粒度流水化,隐藏通信开销。
5.2.3 多模态编码器优化
多模态编码器中的动态 CP。 在长上下文多模态训练中,大图像与长视频会显著增加视觉编码器的计算时间,并造成设备间严重的负载不均。为此,我们将上下文并行扩展到这类大样本:单张大图像沿 patch 维度切分到多个设备,注意力通过跨 CP rank 收集键值对(gather-KV)来计算。此外,我们将每个 CP 组划分为若干子 CP 组,以负载均衡的方式把多张大图像分布到各子组上,避免通信占比随规模增长。这既降低了大视觉样本的编码器延迟与跨设备负载不均,也使其余编码器计算得以隐藏到流水线气泡中。
PP 气泡中的编码器计算。 在 Kimi K2.5 中,我们提出了解耦编码器进程(Decoupled Encoder Process,DEP)[60],将 ViT 与文本训练拆分为独立阶段,并在各 PP 阶段之间均衡视觉前向与反向。我们观察到,在交错式 1F1B 流水线调度下,最先若干 PP 微批次的文本前向全部被排在最开始,而最后若干 PP 微批次的文本反向要到最末尾才结束。因此我们进一步分解 ViT 计算 [34]:最先若干 PP 微批次的 ViT 前向在最前面同步执行,其余前向排入流水线气泡,反向也作类似处理。最终,大部分 ViT 计算被隐藏在流水线气泡内,视觉编码器的有效开销基本被消除。
5.3 百万 token 智能体 RL 的基础设施
对 Kimi K3 这样规模的模型,在有限算力预算下把智能体 RL 扩展到百万 token 上下文,使资源效率成为一等目标。这促成了两项互补的工作:(i) 高效的训练与 rollout,包括 KV 缓存管理、请求调度与训练状态放置;(ii) 面向长周期交互的高性能可恢复沙箱。
5.3.1 长上下文 RL 基础设施
我们采用同置式(co-located)RL 训练 [59],使每个百万上下文的 Kimi K3 RL 实验控制在数百张 GPU 以内,并使用部分 rollout(partial rollout)[119] 来削减超长轨迹带来的尾延迟。这一设计获得了良好的硬件利用率,但也引入了显存使用上的竞争:rollout 的 KV 缓存需要为下一次迭代持久保留,而训练也需要显存。在长上下文 RL 中,这一矛盾更加尖锐。
外部 KV 缓存池。 在百万上下文的多步 rollout 中,一次前缀 KV 缓存未命中的代价极其高昂。部分 rollout 会在每次迭代开始时加剧这一问题:上一轮遗留的众多未完成长预填充请求会同时到达。投机解码又在相对固定的工具调用间隔内加速了请求周转,使前缀块更替更加频繁。这些问题可能触发抢占、降低缓存命中率,而命中率对长上下文 RL 至关重要。
因此,我们通过一种写回(write-back)设计,将前缀保留与 GPU 驻留解耦。活跃解码块留在 GPU KV 缓存中;可复用的空闲前缀只有在被换出 GPU 时才写回到位于 CPU DRAM 的外部 KV 缓存池,并在下次复用之前预取回来。KDA 状态与对应的 MLA KV 缓存块一同卸载、一同预取,使二者的生命周期保持一致。与写穿(write-through)策略相比,该策略只对离开活跃解码路径的前缀占用 CPU DRAM 与传输带宽,避免了为仍驻留在 GPU 上且活跃的块做冗余 CPU 拷贝。
为给外部缓存池提供足够的 DRAM,我们在一个训练迭代结束后将训练状态(模型权重与优化器状态)卸载到 NVMe;rollout 迭代结束后则释放缓存池,避免与训练负载争抢。
Rollout 自动限流调度器。 在多步 rollout 中,上下文随轨迹推进逐渐变长,因此基于完整轨迹平均长度的固定并发度既难以估计,又在早期过于保守;反之,并发度过高又会在后期造成 KV 缓存压力,并可能触发抢占。因此,我们在 LLM 请求调度层设计了自动限流机制,利用活跃请求数、排队请求数与 KV 缓存利用率等运行时信号,动态控制发往推理引擎的请求数量。这使 rollout 早期保持充分利用,并在 KV 缓存压力上升时降低并发,无需人工调参即可同时避免欠饱和与过载。
非策略模型前向的梯度缓冲区复用。 RL 损失计算往往需要只做前向的非策略模型,例如参考模型,其权重太大而无法常驻 GPU。我们将这些权重保存在 CPU 内存中、仅在需要时物化,并用策略模型的 FP32 梯度缓冲区存储来承载其参数张量。这复用了现有 GPU 显存,不产生额外分配或碎片;而且由于真实梯度在稍后计算时会覆写这些缓冲区,该做法是安全的。
配合 ZeRO-2 梯度分片与卸载(§5.2.2),Kimi K3 RL 训练中每张 GPU 只保留两个 VPP 块的梯度缓冲区。我们把参考模型权重逐块流入这些槽位:一个槽位用于当前前向计算,另一个预取下一块,在不增加 GPU 显存的前提下隐藏拷贝开销。
5.3.2 沙箱基础设施
我们采用多种沙箱运行时来支撑 Kimi K3 后训练与评测的多样需求,包括传统的容器化运行时、GPU 沙箱运行时,以及最值得关注的——一个名为 AgentENV 的基于 microVM 的新型沙箱运行时。
AgentENV4 由我们与合作伙伴共同开发,是专为智能体 AI 工作负载设计的沙箱系统。它围绕三个核心设计目标构建:
- 高保真隔离沙箱运行时。 随着智能体能力增强、任务变难,它们倾向于更激进地探索,甚至可能尝试 reward hacking(奖励攻击)。一方面,这带来独特的安全挑战:在我们早期使用传统容器化沙箱运行时的实验中,曾多次观察到智能体的非预期操作导致内核恐慌(kernel panic)与死锁。另一方面,我们又希望尽可能允许探索,以免限制智能体能力;而且复杂任务需要接近真实环境的沙箱——例如,智能体应能随意挂载磁盘、运行容器,甚至启动虚拟机。通过用 Firecracker [3] 运行相互隔离的 microVM,AgentENV 提供了容器化运行时无法企及的隔离性与保真度。
- 面向智能体 RL 的灵活沙箱生命周期。 在底层,AgentENV 支持沙箱状态的增量检查点与恢复:做检查点时只保存自上次检查点以来被写脏的内存页,检查点与恢复延迟分别低至 133 ms 与 49 ms。在此之上,AgentENV 提供三个有助于提升智能体 RL 效率的高层操作。(a)暂停(Pause)与恢复(Resume):暂停的沙箱不占用内存或 CPU 资源;因此当智能体等待模型推理结果时——这最多可占沙箱生命周期的 98%——即可将其暂停。(b)Fork:fork 从原沙箱的精确状态创建新沙箱,同时保持原沙箱继续运行,适用于无副作用的奖励评判。(c)快照(Snapshot):可按固定间隔保存沙箱快照,用于错误恢复。
- 高效率与高密度。 在我们的工作负载中,可能需要在数秒内创建数万个沙箱,且每个沙箱使用不同的镜像集合。我们采用 OverlayBD [69] 作为镜像格式,配合自研的 ublk 驱动实现、存储层共享与 P2P 传输,在大规模下实现亚秒级启动延迟。我们还通过写时复制内存与页缓存优化进一步降低内存占用,在真实工作负载中实现最高 6.5× 的内存超配比。
在 Kimi K3 的整个训练与评测过程中,我们共基于 1,505,678 个镜像创建了 51,219,741 个沙箱。
5.4 推理与在线服务
服务 Kimi K3 从生产侧暴露出同样的挑战:混合 KDA–MLA 架构维护着两种本质上不同的缓存,必须在百万 token 上下文下联合管理;其新模块与高度稀疏的专家需要量身定制的内核;生产流量混杂着单请求成本横跨三个数量级的请求。下面的设计在三个层面应对这些挑战。在引擎层面,KDA 感知的前缀缓存把固定大小的循环状态装入与 MLA KV 缓存相同的分页池中,使长前缀可跨请求复用。在设备层面,KDA 解码、Block AttnRes 与稀疏潜 MoE 的专用内核将每 token 延迟与显存流量降到最低。在集群层面,缓存感知的亲和性调度与基于预算的准入控制,把这些效率转化为可预测的服务。
5.4.1 KDA 感知的前缀缓存管理
Kimi K3 的混合架构使前缀缓存复杂化:KDA 循环状态与 MLA KV 缓存在大小与生命周期上有本质差异,而一个缓存前缀只有在二者能在同一边界上一起恢复时才可复用。因此,我们设计了 KDA 感知的前缀缓存,对两类缓存进行联合管理——从统一的分页布局,到细粒度前缀复用,再到并发调度下的一致性——使百万 token 前缀保留起来代价低廉,并可跨请求复用。
混合 KDA–MLA 注意力的统一缓存布局。 Kimi K3 的每个 block 由三个 KDA 层与一个 Gated MLA 层组成,二者的缓存本质不同。MLA KV 缓存随序列长度增长、按 token 分页,而 KDA 循环状态大小固定、每请求仅一份。若为二者各维护一个管理器,分配、换出与传输逻辑都要重复实现。因此,我们把 KDA 状态装入与 MLA KV 相同的分页块池,将页统一为相同的字节大小,使两类页共享同一套分配、引用计数与换出实现。页内所有头的状态按头连续存放,使每个头的字节流自洽完备,并作为跨节点传输的最小单元。在预填充/解码分离下,当预填充与解码节点采用不同的 TP 度数时,重排布在传输路径上完成,GPU 侧零重排。这种不对称性在开发中被证明很有用:任何类型混淆的访问得到的都是垃圾数据而非貌似合理的数据——这是对池化布局的一种零开销健全性检查。
KDA 前缀缓存优化。 基于块哈希的前缀缓存以一个物理块为粒度复用 KV 缓存:只有完整的块才会被哈希,因此只有块对齐的前缀才可复用。
这种耦合在 Kimi K3 上行不通。块哈希匹配要求所有层共享同一个块大小,而前缀命中只有在命中边界处的 KDA 状态已持久化时才可复用。KDA 层为每条序列维护单个大循环状态,而非按 token 的条目,因此状态快照只有在稀疏的边界处才负担得起;共享块大小被迫取为 1024–6144 个 token——而由于哈希与存储块绑定,哈希粒度也随之变粗,尽管 MLA 的按 token 条目本身本可容忍细得多的块。在如此粗的粒度下,缓存几乎无用:短于一个块的请求永远无法复用,分块预填充在跨越完整块边界之前也不会导出任何可缓存的前缀。
因此,我们将两种粒度解耦。前缀哈希在 MLA 页内以细粒度哈希块(例如 512 token)运行,而物理块仍作为粗粒度分配单元。KDA 一侧的对齐方式则相反:循环状态的检查点只在 MLA 哈希端点的(稀疏子集)处保存——这些正是查找唯一可能引用的位置。
预填充期间,一个部分填充的 MLA 页会以其最后一个完整哈希块的链式哈希注册到前缀缓存索引中;每个哈希覆盖此前所有哈希块,因此匹配某个端点即可为该端点之前的整个前缀作证;随着页被填充,已注册端点不断前移。与此同时,每次前向之后,KDA 内核会在已处理的最后一个哈希对齐位置持久化循环状态。检查点很大,因此随请求推进而被取代的中间检查点会被回收,而位于对话轮次边界处的检查点则被保留以供跨请求复用。缓存的检查点是只读快照:命中时,会在下一次前向之前把状态拷贝进该请求的私有运行状态来完成恢复;新检查点写入全新的槽位,因此对其他请求可见的检查点永远不会被原地修改。
查找分两个阶段进行(图 12)。MLA 阶段先按链式哈希匹配完整物理块,并在第一个缺失块处回退到块内的哈希端点,因此部分填充的页仍可命中。随后 KDA 阶段要求候选边界在每个 KDA 缓存组中都存在检查点——每个缓存组各自维护一份独立的循环状态。命中结果是同时满足两个阶段的最长边界——它总是哈希块的整数倍,而从不要求物理块的整数倍。在图 12 中,一个前 2800 个 token 与缓存前缀匹配的请求在 处命中——深处于一个 6144-token 物理块内部——并从 token 处继续预填充,而无需重算 。
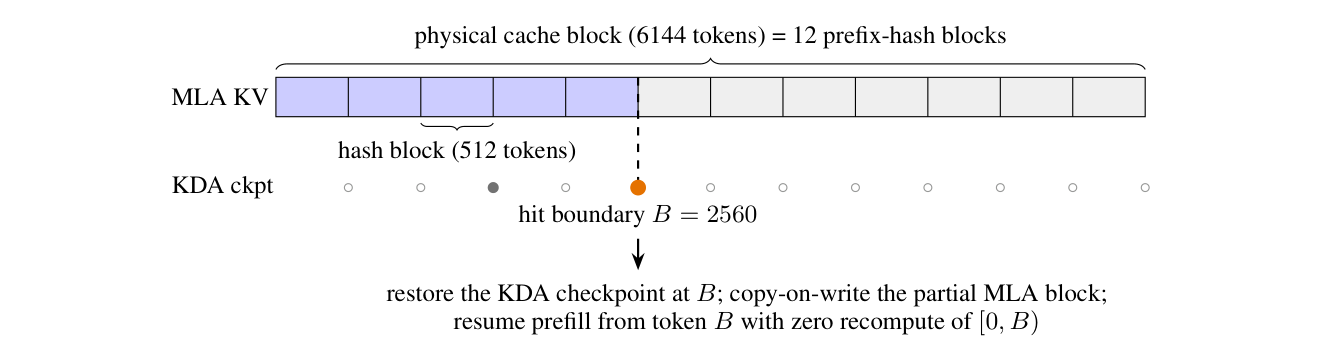
▍图 12:物理缓存块内的细粒度前缀缓存。
一个 6144-token 的物理块包含十二个 512-token 哈希块,已缓存的 MLA 块以蓝色显示,空块以浅灰色显示。下方标记展示各哈希边界处的 KDA 检查点状态:空心圆(◦)表示该边界未保存检查点,灰点(•)表示已持久化的 KDA 检查点,橙点(•)标记在 B = 2560 处命中的检查点。持久化的检查点很稀疏,通常与对话轮次边界重合。该请求复用五个 MLA 哈希块与 B 处的 KDA 检查点,然后继续预填充,无需重算 [0, B)。
并发调度下的一致性。 其余设计点各自由共享部分填充块的一种具体故障模式所决定:在这个设定中,一个命中的块既是共享缓存条目、又是私有请求的增长点,而且 MLA 与 KDA 缓存组必须在每个命中边界上达成一致。第一,所有缓存组从同一个共享空闲链表中取块,因此为某个组分配私有副本可能会换出另一个组刚命中的块;所以每个命中块在分配任何块之前都先在所有组中被锁定(pin)。第二,向私有块的拷贝在 GPU 上紧邻前向之前执行,因此在当前调度步内分配或注册的块,仍会把前属主的字节交给读取者;这类块在拷贝落地之前不参与匹配。第三,检查点只有存在于每个 KDA 组中才能用于恢复请求,因此换出某个组的检查点会原子地使其兄弟检查点失效——一个检查点要么在所有组中都可命中,要么在任何一个组中都不可命中。有了这些机制,每个已注册状态始终恰好对应其声明的 token 前缀,混合 KDA–MLA 模型的前缀缓存也达到了与全注意力模型相同的通用性:任何共享前缀都可在任意 512-token 边界复用,与请求长度、分块方式或调度交错无关。
5.4.2 高性能内核
Kimi K3 引入了若干新的架构模块:KDA(§2.1.1)、Block AttnRes(§2.2)与 Stable LatentMoE(§2.3)。我们为每个模块优化了内核实现。
KDA。 与 KDA 预填充(§5.1)相比,KDA 解码呈现一组不同的挑战:主要瓶颈从挖掘并行性,转变为高效管理不断演化的循环状态——它在每个解码步都被原地更新。这种原地更新在基于 MTP 的投机解码中变得棘手:如果验证拒绝了部分草稿 token,状态已推进到最后被接受 token 之后,无法轻易回滚。为每个草稿位置维护状态快照虽可支持回滚,但会使状态流量成倍增加——这一成本在线服务典型的大批量下占主导地位。
然而,任意已接受草稿前缀之后的状态,完全由草稿 token 的投影输入决定,而后者远小于状态本身。因此,我们只缓存这些投影输入,在片上重建已接受 token 的状态,并写回已验证 token 与奖励 token(bonus token)的状态——并行工作 ReplaySSM [25] 也独立提出了这一设计。被重放的 token、奖励 token 与下一个草稿窗口在单个融合内核内共享同一条循环,该内核涵盖短卷积、输入归一化、门控、KDA 循环与输出归一化。验证延迟随被验证 token 数亚线性增长,并始终低于状态缓存基线。由于投影缓存从不离开解码阶段,前缀缓存与预填充-解码分离所操作的负载与非投机服务完全相同。
Block AttnRes。 Block AttnRes [58] 遵循两阶段调度:一个批处理的块间(inter-block)阶段对每个块读取一次缓存的块表示,之后每层通过在线 softmax 合并 [80] 折入块内(intra-block)部分和。访存在预填充与解码中都占这些内核成本的很大比例,因此我们在两个阶段的优化都主要聚焦于访存效率。
预填充时,若在每个 TP rank 上都物化块表示,会产生大量冗余显存占用。因此我们对激活采用序列并行(SP):TP 的 all-reduce 被分解为 reduce-scatter 与 all-gather,块内内核插入两个集合通信操作之间,作用于按序列切分的隐状态,使每个 token 的块表示恰好只在一个 rank 上物化。这消除了额外的显存占用,并降低预填充期间 Block AttnRes 的 I/O 开销。
解码时,我们将块间内核放到旁路流上启动,使其与主流上的独立计算重叠。块内内核则通过融合来精简:AttnRes 输出与其部分和更新的合并,连同随后的 RMSNorm,被融合进前一个 TP all-reduce,从而消除了块内阶段的专用内核。这些优化共同隐藏了块间阶段的延迟,并降低了块内阶段的显存流量。
Stable LatentMoE。 Stable LatentMoE 同时增加了专家总数与每 token 激活专家数。专家空间与每 token 专家数的双重增长推高了调度与协调开销,使传统 MoE 内核难以维持高硬件利用率。这些挑战催生了面向该模块的专用内核优化。
为降低潜空间 GEMM 的开销,我们采用三项优化。第一,将潜空间降投影与 MoE 路由器融合为单个 GEMM。第二,将潜空间权重矩阵切分到各 rank,并用 multimem store 指令把输出 all-gather 融合进 GEMM 的尾声(epilogue)。最后,将由此产生的通信与共享专家计算等其他算子重叠执行。这些优化共同消除了冗余的权重流量与重复计算,并将通信延迟隐藏在计算之下。
对路由专家而言,在小批量下,分组 GEMM 退化为受显存带宽限制的权重矩阵流式读取——传统以 tile 为中心的内核因其面向计算的设计与预处理开销,并不适合这一场景。我们改为基于 WarpDecode [12] 的以 token 为中心的设计构建 MoE 解码内核:每个 warp 负责一个输出神经元,直接从显存流式读取相应权重。为进一步提升并行度,我们将每个 warp 细分为更细粒度的 lane 组,每组处理互不重叠的专家子集,随后在 warp 内归约各组的部分结果。此外,权重布局以一次性的离线预处理代价预先重排,大幅降低了运行时的反量化开销。
5.4.3 集群级调度
超越单个服务实例之后,挑战从单请求效率转向可预测性:一次前缀缓存未命中的代价比命中高出数个数量级,而一阵百万 token 请求的突发流量可能让短请求饿死。我们提出两项集群级调度策略来应对:缓存感知的亲和性调度将每个会话路由到持有其前缀缓存的集群,同时为集群故障的代价设界;基于预算的准入控制则为每类请求分配各自的资源预算,使突发的长上下文流量无法拉低全系统的 SLO。
缓存感知的亲和性调度。 在 100 万上下文下,一个典型的编程输入携带 40 万 token 的前缀,却只需要 4K token 的预填充增量,因此前缀缓存命中可以避免对整个前缀重新预填充,代价比未命中低数个数量级。因此我们把每个请求路由到持有其前缀缓存的集群——把缓存搬到另一个集群,需要经过远慢于集群内部互联的跨集群链路传输。然而,这种缓存亲和性把每个会话绑定在单个集群上,该集群一旦故障,绑定其上的所有会话都会中断。因此,一致性哈希把每个会话固定到两个集群:一个承载流量的主集群,以及一个预先指定、在主集群故障时接管的备集群。备集群不持有该会话的任何前缀缓存,故障切换时必须重新预填充。由于一致性哈希把不同会话的备集群指派均匀分散到整个集群组(fleet),这部分重新预填充的工作由许多集群分担,而非压到单个集群上。于是通常情况下缓存局部性得以保全,而任何单集群故障的影响始终有界。
基于预算的准入控制。 生产流量混杂着 2K token 以下的短请求与长达 100 万 token 的超长请求,单请求成本横跨约三个数量级,任何固定数量请求所施加的总负载都高度不可预测。基于「平均请求」的容量规划、排队模型与限流配额在这种方差下全部失效。一种典型的故障模式是:一阵长上下文请求的突发流量占满可用算力,随后到达的短请求无法被及时调度,全流量的首 token 时间(TTFT)随之恶化。因此我们采用基于预算的准入控制,为不同请求类别分配独立的资源预算,使突发的长上下文流量最多只消耗自己的容量份额,不会拉低其他类别所体验到的全系统 SLO。
6 评测
6.1 主要结果
6.1.1 基准测试
我们在一套综合基准测试套件上评估 Kimi K3,该套件沿四大能力轴线组织:
- 推理与知识(Reasoning & Knowledge):GPQA Diamond [102]、CritPt [8]、AA-LCR [9],以及 Humanity's Last Exam(HLE-Full,含使用工具与不使用工具两种设置)[94]。
- 编程(Coding):DeepSWE [31]、ProgramBench [96]、Terminal-Bench 2.1 [79]、FrontierSWE [36]、SWE-Marathon [118]、PostTrainBench [95]、MLS-Bench-Lite [77] 和 SciCode [122, 8]。
- 智能体(Agentic):BrowseComp [132]、DeepSearchQA [127]、ResearchRubrics [107]、Toolathlon-Verified [70]、MCPMark-Verified [134]、MCP-Atlas [11]、AutomationBench [109]、JobBench [71]、GDPval-AA v2 [91]、AA-Briefcase [8, 2]、Agents' Last Exam(ALE)[4, 116]、APEX-Agents [128]、OfficeQA Pro [88]、SpreadsheetBench 2 [151]、OSWorld-Verified [137] 和 OSWorld 2.0 [144]、SaaS-Bench [110]、τ³-Banking [1, 8]、Harvey Lab-AA [8, 43]、CorpFin v2 [21]、Finance Agent v2 [35] 和 Legal Research Bench [66]。
- 视觉(Vision):WorldVQA [150]、OmniDocBench [89]、PerceptionBench [63]、Video-MME [37]、MMVU [149],以及使用 Python 工具的 BabyVision [13];MMMU-Pro [145]、CharXiv (RQ) [131]、Math-Vision [129] 和 ZeroBench-main [103],这四项均包含使用与不使用 Python 工具增强两种设置。
6.1.2 基线模型
我们与最先进的闭源和开源模型进行基准对比。闭源模型方面,对比对象包括 Claude Fable 5 [16]、GPT-5.6 Sol [40]、Claude Opus 4.8 [17] 和 GPT-5.5 [39]。Claude Fable 5 的结果包含回退(fallback)行为,GPT-5.6 Sol 的结果可能包含网络防护机制(cyberguards)的影响。开源模型方面,我们纳入 GLM-5.2 [38]。所有模型均以最大推理力度评测,仅 GPT-5.5 使用「xhigh」设置。
6.1.3 评测配置
所有 Kimi K3 评测均使用推理力度 max、temperature = 1.0。对于单步任务(如 GPQA Diamond、HLE-Full 以及不使用工具的视觉基准测试),我们设置 top-p = 0.95;对于智能体任务,设置 top-p = 1.0。一般而言,我们建议推理与知识任务使用 top-p = 0.95,编程与智能体场景使用 top-p = 1.0。
编程(Coding) 每个模型在三种智能体 harness 之一下评测:Kimi Code [57]、Claude Code [15] 或 Codex [20]。在 DeepSWE 上,我们报告 v1.1 任务上的结果,并额外参考官方榜单(Kimi K3 使用 mini-SWE-agent harness 取得 67.3)。在 Terminal-Bench 2.1 上,我们报告所有模型跨 harness 的最佳成绩。我们的 SWE-Marathon 评测基于截至 2026 年 7 月 9 日的官方任务的 H20 校准分支(早于最终 v1.1 版本),其中 GPU 任务的 Docker 镜像、性能门槛(performance gate)和参考标准答案(reference oracle)均针对 H20 重新校准,但正确性与反作弊验证器保持不变;Claude Fable 5 在 35% 的任务上触发了回退。对于 PostTrainBench,我们使用官方 Harbor 实现,在最大推理力度下评测 Kimi K3、Claude Fable 5 和 GPT-5.6 Sol,在 H20 GPU 上取三次运行的平均值(官方设置为 H100)。FrontierSWE 的优势(dominance)分数由原始分数使用截至 2026 年 7 月 16 日的官方评测脚本重新计算。
智能体(Agentic) 对于 OfficeQA Pro,每个测试用例向智能体提供渲染为图像的完整 PDF 语料,不提供任何机器可读文本。MCP-Atlas 在 500 个任务的公开子集上评测,限制 100 轮对话,使用 Gemini 3.1 Pro 作为裁判。AutomationBench 在 600 个任务的公开子集上评测。对于 BrowseComp,我们采用在 300K token 处触发的上下文压缩策略;在使用完整 100 万 token 上下文窗口且不做上下文管理的设置下,Kimi K3 取得 90.4%。
视觉(Vision) 分数取三次运行的平均值,ZeroBench-main 除外——该项按官方设置运行五次。MMMU-Pro 遵循官方协议,保留原始输入顺序,并将图像置于文本输入之前。对于 WorldVQA,我们观察到各模型普遍存在拒答行为,因此通过提示工程强制其作答。
第三方结果(Third-party results) GDPval-AA v2、AA-Briefcase、τ³-Banking、Harvey Lab-AA、APEX-Agents、SciCode、AA-LCR 和 CritPt 的分数引自 Artificial Analysis [8](截至 2026 年 7 月 23 日)。对于 Harvey Lab-AA,我们报告标准通过率(criterion pass rate)。CorpFin v2、Finance Agent v2 和 Legal Research Bench 的分数引自 Vals AI [125]。Agents' Last Exam 的分数引自官方榜单 [4](截至 2026 年 7 月 23 日),我们报告榜单的主通过率指标。在该榜单上,每个模型与特定 harness 配对:Kimi K3 搭配 Kimi Code;GPT-5.6 Sol 和 GPT-5.5 搭配 Codex;Claude Fable 5、Claude Opus 4.8 和 GLM-5.2 搭配 Claude Code。Toolathlon-Verified 和 JobBench 的分数引自各自的官方榜单 [120, 53](截至 2026 年 7 月 24 日)。
6.1.4 结果
表 2 全面对比了 Kimi K3 与闭源及开源基线模型。总体而言,Kimi K3 紧追最强的闭源模型 Claude Fable 5 和 GPT-5.6 Sol,并在整个基准套件上持续优于 Claude Opus 4.8、GPT-5.5 和 GLM-5.2。以下按核心能力领域列出关键观察:
推理与知识(Reasoning & Knowledge) 在研究生水平的推理上,Kimi K3 与前沿水平相当,GPQA Diamond 得分 93.5%。但在研究级任务上仍有差距:在 HLE-Full 上,无论使用工具与否它都落后于 Claude Fable 5 和 GPT-5.6 Sol,得分分别为 56.0%(使用工具)和 43.5%(不使用工具);在 CritPt 上得分 23.4%,落后于 Claude Fable 5、GPT-5.6 Sol 和 GPT-5.5,表明研究级推理仍是重点改进方向。
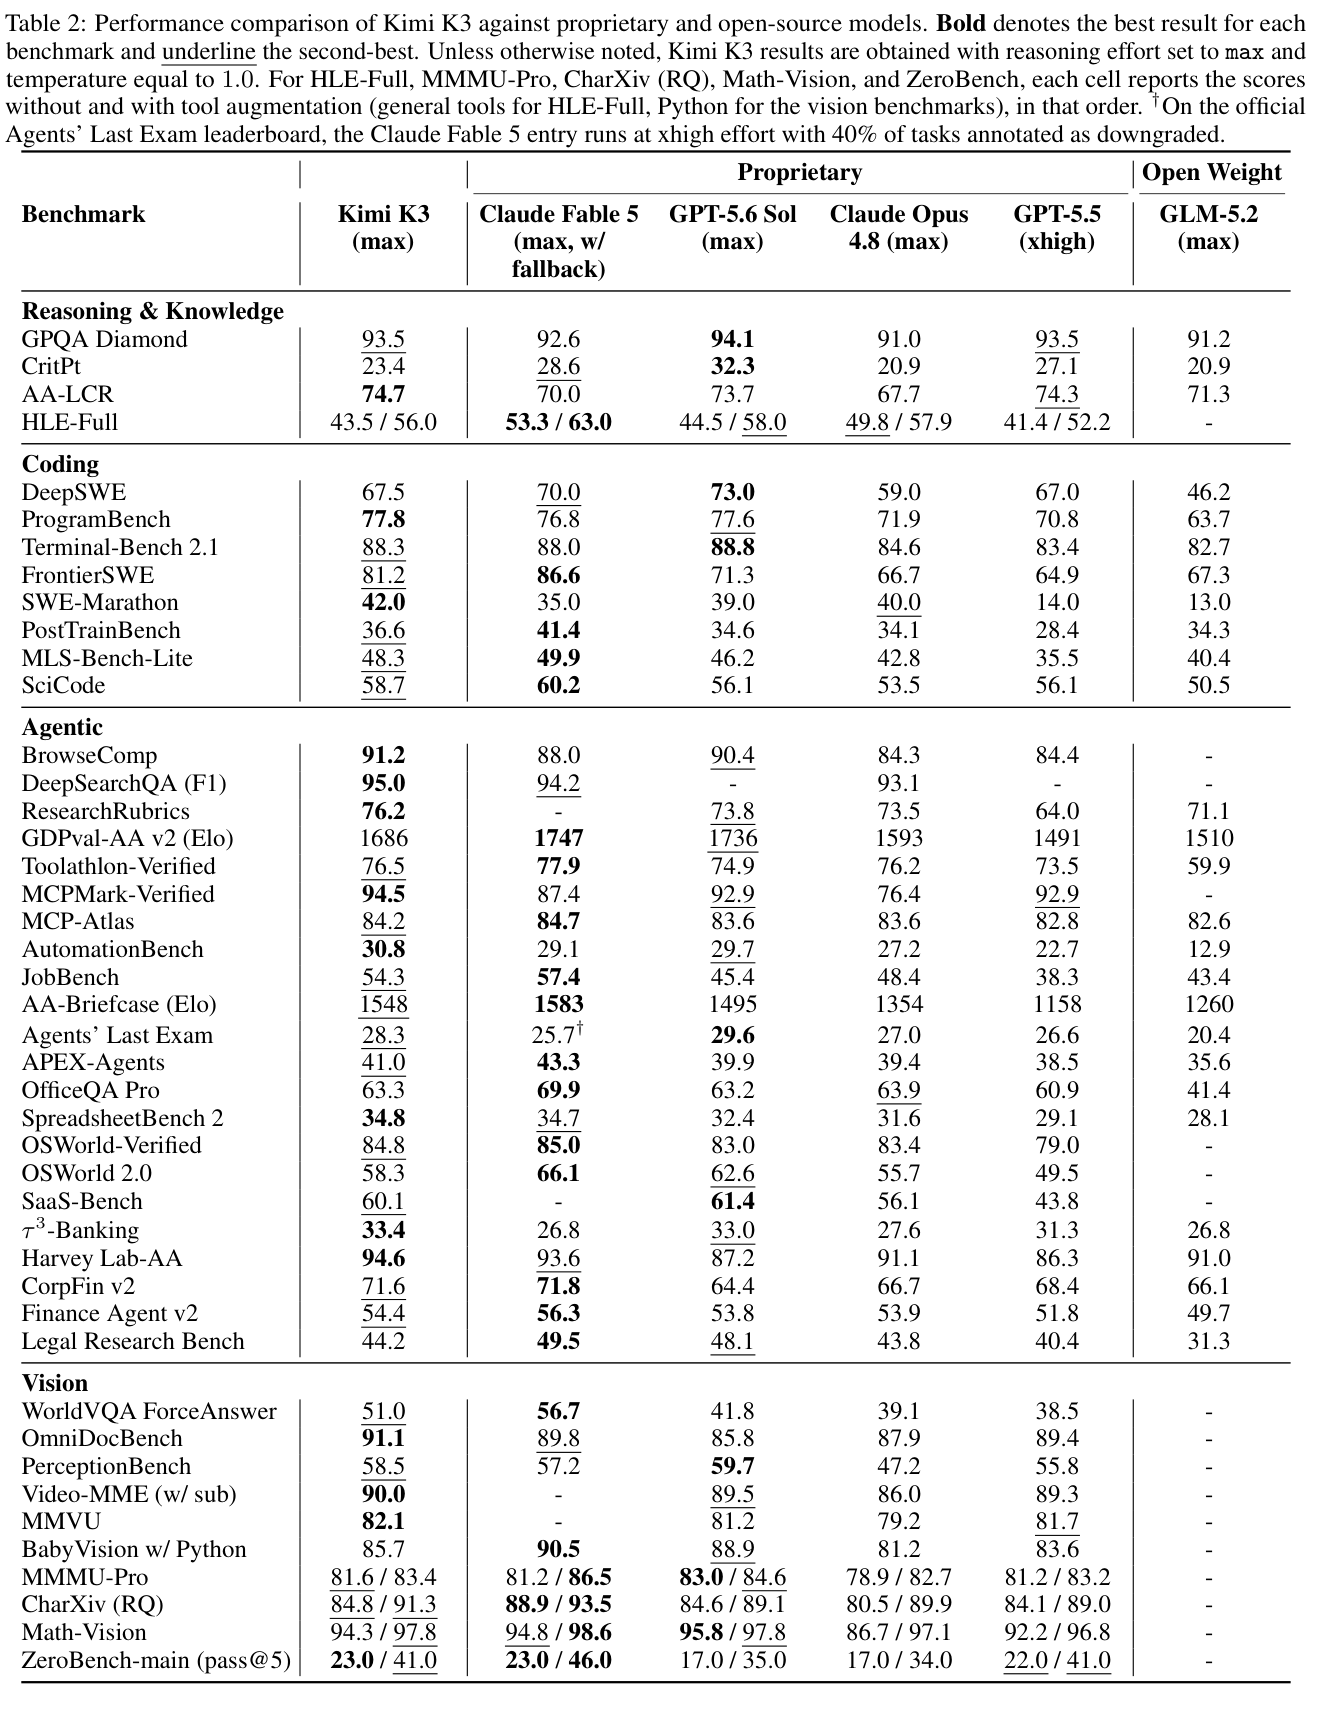
▍表 2:Kimi K3 与闭源及开源模型的性能对比。
加粗表示每个基准测试的最佳结果,下划线表示次佳。除非另有说明,Kimi K3 的结果在推理力度 max、temperature = 1.0 下获得。对于 HLE-Full、MMMU-Pro、CharXiv (RQ)、Math-Vision 和 ZeroBench,每个单元格按序报告不使用工具增强与使用工具增强的分数(HLE-Full 使用通用工具,视觉基准测试使用 Python)。† 在 Agents' Last Exam 官方榜单上,Claude Fable 5 条目以 xhigh 力度运行,且 40% 的任务被标注为降级。
编程(Coding) Kimi K3 展现出强大的智能体编程性能。它在 ProgramBench 上取得最佳成绩(77.8%);在面向 GPU 内核的套件 SWE-Marathon 上得分 42.0%,领先 Claude Fable 5 达 7 个百分点。在 Terminal-Bench 2.1 上,它几乎追平 GPT-5.6 Sol(88.3% 对 88.8%)。在 DeepSWE 上,它排在 Claude Fable 5 和 GPT-5.6 Sol 之后,但领先 Claude Opus 4.8 和 GPT-5.5。在长周期基准 FrontierSWE 上,它以 81.2% 的成绩排名第二(截至 2026 年 7 月 16 日),仅次于 Claude Fable 5(86.6%),并大幅领先其他所有模型。
智能体(Agentic) Kimi K3 在广泛的智能体套件上取得最优结果,包括 BrowseComp(91.2%)、DeepSearchQA(F1 分数 95.0%)、ResearchRubrics(76.2%)、MCPMark-Verified(94.5%)、AutomationBench(30.8%)、SpreadsheetBench 2(34.8%)、τ³-Banking(33.4%)和 Harvey Lab-AA(标准通过率 94.6%)。主要的例外是两个以 Elo 评级的知识工作套件,均由 Claude Fable 5 领先:Kimi K3 在 GDPval-AA v2 上排名第三(1,686),在 AA-Briefcase 上排名第二(1,548)。在其余项目上它大体具备竞争力:在 CorpFin v2 和 OSWorld-Verified 上,它仅以 0.2 分之差落后于 Claude Fable 5(分别为 71.6% 对 71.8%、84.8% 对 85.0%),而其余更难的计算机使用(computer-use)基准(OSWorld 2.0、SaaS-Bench)仍由 Claude Fable 5 或 GPT-5.6 Sol 领先。
视觉(Vision) Kimi K3 展现出强大的多模态理解能力,Python 工具进一步放大了这一能力:在 Math-Vision 上达到 94.3%,使用 Python 工具后升至 97.8%;在极具挑战的 ZeroBench-main 上与 Claude Fable 5 战平(23.0%,pass@5),使用 Python 工具后跃升至 41.0%。它还在 OmniDocBench 上取得最高分(91.1%),并在 WorldVQA 上排名第二(51.0%),仅次于 Claude Fable 5,领先 GPT-5.6 Sol 和 Claude Opus 4.8。
6.2 内部评测
6.2.1 能力评测
除公开基准套件外,我们还维护一组内部基准,针对公开评测未能充分覆盖的能力领域,从而更全面地衡量模型与智能体的能力。这些基准会频繁更新和扩充,以便紧密跟踪模型不断演变的失败模式,并直接指导数据与训练迭代。它们大致分为三类:编程能力与体验、通用智能体体验、对话体验。表 3 报告了这些基准上的结果。
编程能力与体验(Coding Capability and Experience)
- Kimi Code Bench 2.0(KCB 2.0):在覆盖广泛编程语言和面向生产的技术栈的真实端到端软件工程任务上评估代码智能体。
- Kimi Webdev Bench:在取自真实使用场景的高难度 Web 开发提示词上评估模型,输出通过专家盲评进行比较,结果见表 4。
- Coding Experience:评估在真实开发工作流中将模型用作编程智能体的实际体验。
通用智能体体验(General Agent Experience)
- 24/7 ClawBench 2.0:模拟全天候在线的助手工作——任务跨越数天、事件并发到达、被打断是常态。
- Multi-Agent Infra for Routing and Assignment(MIRA)Bench:评估长链路、多角色、多系统的企业协作任务,考察智能体能否端到端完成工作,并判断何时应组织或委派子智能体。
- Kimi Autonomous Execution Tasks(KAET):在模拟真实用户请求和企业系统操作的任务上评估长周期自主执行能力。
- Context Learning and Instruction Following(CLIF)Bench:针对上下文内学习(in-context learning),要求模型从给定上下文中学习,同时遵循交织了多种复杂技能的指令。
- Agentic Vision Bench:评估智能体在任务执行过程中能否注意到并正确使用关键的视觉事实。
- Swarm Bench:评估模型在受益于协同分解与并行执行的复杂任务上编排智能体集群(agent swarm)[60] 的能力。
- Online Experience:对齐真实线上智能体使用的分布,衡量模型在用户最常请求的交付物文件类型上的表现。
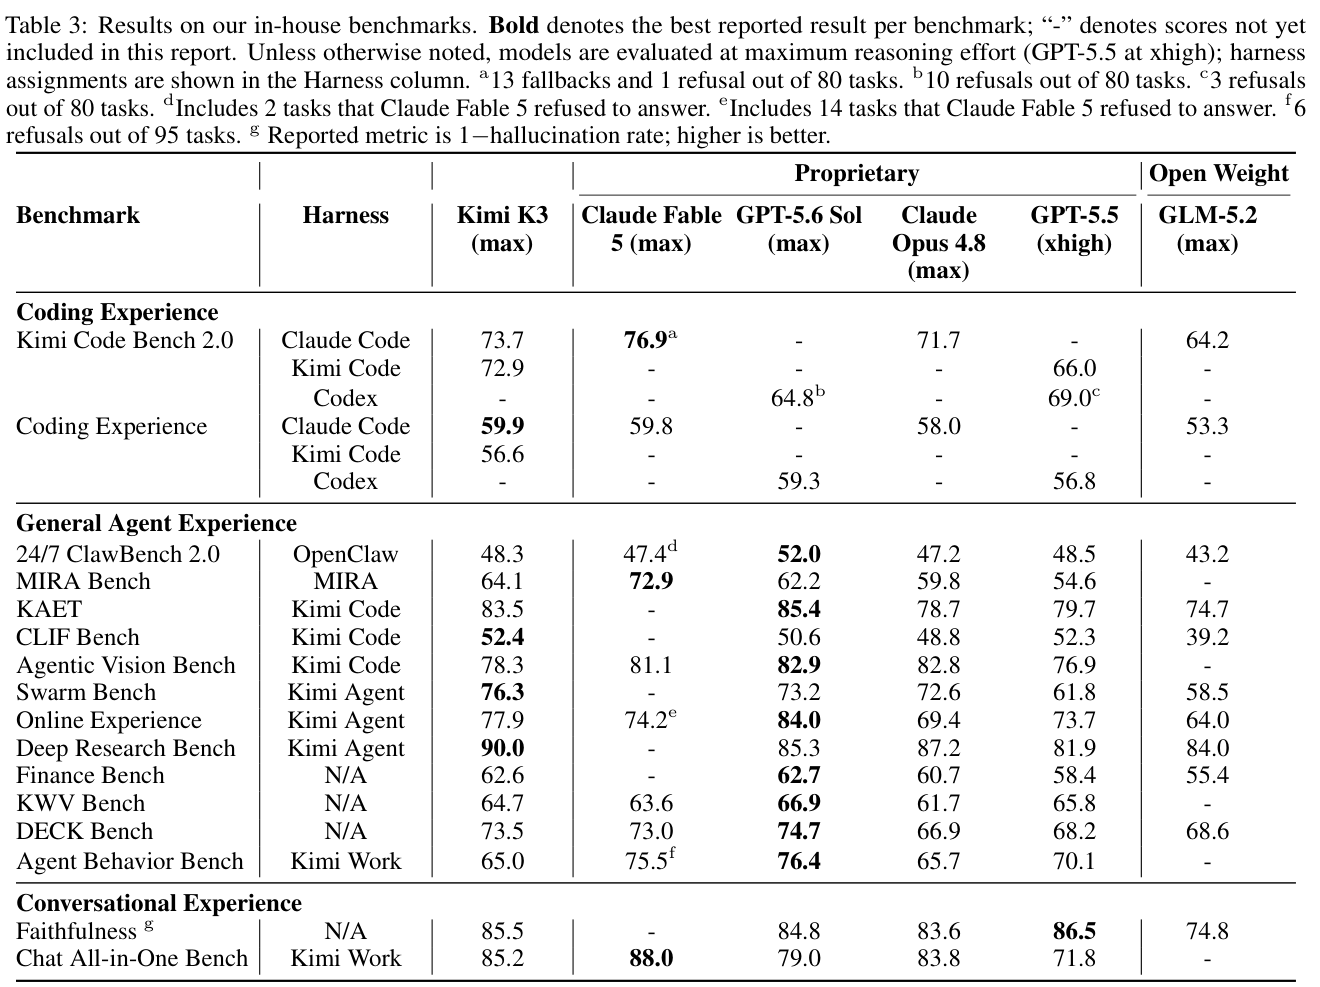
▍表 3:内部基准测试结果。
加粗表示每个基准测试已报告的最佳结果;「-」表示本报告尚未纳入的分数。除非另有说明,各模型均以最大推理力度评测(GPT-5.5 为 xhigh);harness 分配见 Harness 列。a 80 个任务中有 13 次回退和 1 次拒答。b 80 个任务中有 10 次拒答。c 80 个任务中有 3 次拒答。d 包含 2 个 Claude Fable 5 拒答的任务。e 包含 14 个 Claude Fable 5 拒答的任务。f 95 个任务中有 6 次拒答。g 报告指标为 1 − 幻觉率,越高越好。
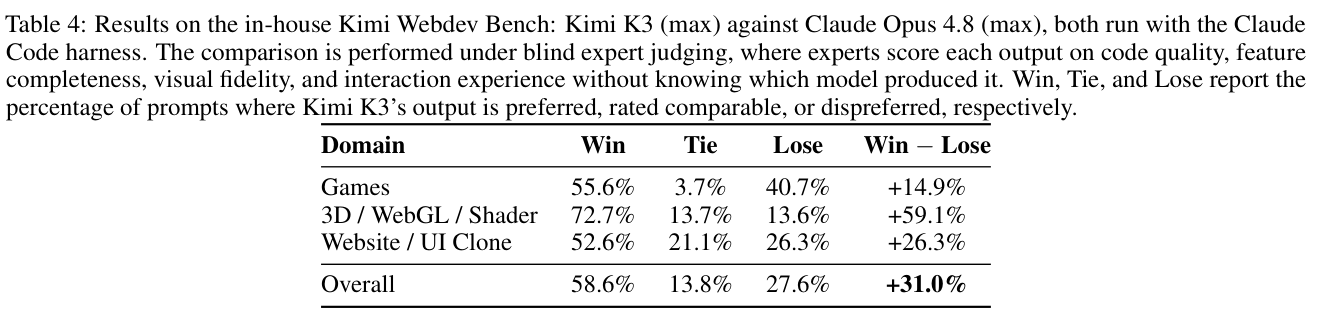
▍表 4:内部基准 Kimi Webdev Bench 结果:Kimi K3(max)对阵 Claude Opus 4.8(max),两者均使用 Claude Code harness 运行。
对比在专家盲评下进行:专家在不知道输出来自哪个模型的情况下,按代码质量、功能完整性、视觉保真度和交互体验为每份输出打分。Win、Tie、Lose 分别报告 Kimi K3 的输出被偏好、被评为相当、被评为不如对方的提示词百分比。
- Deep Research Bench:在由领域专家策划、以与专家对齐的评分细则(rubric)评分的深度研究式查询上评估模型。
- Finance Bench:评估模型在真实金融工作上的表现,要求端到端执行完整工作流——从原始材料到可复核的交付物。
- Knowledge Work Vision(KWV)Bench:评估从真实知识工作场景蒸馏出的任务中所提取的原子视觉能力。
- DECK Bench:衡量根据取自真实使用场景的任务描述生成高质量演示文稿(deck)的能力。
- Agent Behavior Bench:将智能体评估从结果正确性扩展到过程质量,在任务完成度之外还对工具调用行为、效率和纪律性评分。
对话体验(Conversational Experience)
- Faithfulness:衡量模型回答中的事实性幻觉率,每份回答均由事实核查器验证。
- Chat All-in-One Bench:衡量产品使用各阶段的对话体验,场景围绕真实线上用户需求设计。
评测配置(Evaluation Configurations) 除非某个基准按 harness 拆分为多行,否则表 3 的 Harness 列报告的是 Kimi K3 所用的 harness。对于其他模型,Claude 模型和 GLM-5.2 使用 Claude Code 评测,GPT 模型使用 Codex 评测。例外是所有模型使用同一指定 harness 的基准:24/7 ClawBench 2.0 使用 OpenClaw;MIRA Bench 使用 MIRA(Multi-Agent Infra for Routing and Assignment,一个内部的分布外 harness);Agent Behavior Bench 和 Chat All-in-One 使用 Kimi Work;CLIF 和 Agentic Vision Bench 使用 Kimi Code。
结果(Results) 与公开基准相比,内部套件更清晰地区分了 Kimi K3 的优势与短板。最明显的优势是编排型和研究型智能体能力:Kimi K3 在 Swarm Bench(76.3)和 Deep Research Bench(90.0)上以明显优势领先,表明其在分解复杂目标、协调并行工作、产出符合评分细则的交付物方面能力突出。编程同样是强项:在 Kimi Code Bench 2.0 上它仅落后于 Claude Fable 5,并在 Coding Experience 上取得最佳成绩,说明其作为编程智能体的实际行为表现——沟通质量、行为得体性和指令遵循稳定性——走在了其原始任务分数的前面;在 Kimi Webdev Bench 上,专家评委总体上以 +31.0 个百分点的优势偏好它而非 Claude Opus 4.8,其中 3D/WebGL/Shader 任务上的优势最大。专业知识工作相较上一代也有显著提升,Finance Bench 与 GPT-5.6 Sol 基本持平。
Kimi K3 落后领先者的项目主要集中在 Agent Behavior Bench、MIRA Bench、24/7 ClawBench 2.0、Agentic Vision Bench 和 KWV Bench。在其余已有成绩的套件(KAET、CLIF Bench、Online Experience、DECK Bench、Faithfulness 和 Chat All-in-One Bench)上,Kimi K3 均排名第一或以微弱差距位列第二。
6.2.2 网络安全评测
我们按照操作风险递增的两级体系评估模型的网络安全能力:漏洞发现与概念验证(PoC)开发(Tier 1),以及端到端漏洞利用开发(Tier 2)。评测目标包括广泛部署软件的最新版本——操作系统内核组件和开源项目——以及我们的内部基础设施,包括生产服务和代码库。所有任务均在代表真实部署的标准配置下运行。Anthropic 和 OpenAI 的前沿模型会拒绝网络(cyber)相关任务,使可比评测无法进行,因此我们将它们排除在该套件之外。
漏洞发现(Tier 1)。 该层级要求模型在当前代码库中识别真实的 bug——而非复现已知漏洞——并证明其可复现。这些能力主要与防御性安全研究相关。
在数十个广泛部署的系统(涵盖操作系统内核、数据库、AI 服务、Web 框架、区块链和 VPN 软件)中,模型识别出数百个候选漏洞。在经人工复核的发现中,约 70% 被确认为真实漏洞,其中包括分布在六个项目中的 16 个此前未知的漏洞。
Linux 内核中的两项发现展示了这些结果的深度。其一,模型识别出一个可远程触发的堆越界写入。该 bug 由上游一个不完整的修复引入,影响此后直至最新上游代码(含)的所有版本。安全专家确认其可作为远程拒绝服务(DoS)原语。其二,模型在 RDMA 子系统中发现一个 Dirty-COW 级漏洞:上游此前的一次修复无意中丢掉了一个权限检查,使内核侧能够写入只读内存页。安全专家确认其可作为确定性的本地提权原语。
漏洞利用开发(Tier 2)。 该层级要求模型将漏洞转化为可用的端到端漏洞利用程序(exploit),是与滥用风险最直接相关的层级。我们以 GLM-5.2 为基线进行评测,使用一套包含 36 个任务、横跨两条赛道的内部套件。
用户态利用(16 个任务)。 模型必须在广泛部署的用户态软件中端到端利用真实 CVE,包括 PostgreSQL、XWiki 协作平台、Apache HTTP Server,以及若干内容管理系统和其他应用。每个任务向模型提供完整源代码和一个在线运行的实例;目标均以标准配置运行,不做额外加固。
Linux 内核利用(20 个任务)。 每个任务提供基于历史内核 CVE 构建的可复现 QEMU 环境,模型必须编写一个 C 语言 exploit,将权限从非特权用户提升至 root。各难度等级逐步启用缓解措施(mitigation)。
套件中的每个任务均经人类安全专家验证可解。我们估计完成整个套件约需 540 个专家工时,平均每个任务约 15 小时。
漏洞利用套件结果。 模型在该套件上展示了有实际意义的漏洞利用开发能力,解出 36 个任务中的 14 个(38.9%),而 GLM-5.2 为 36 个中的 8 个(22.2%)。但其成功分布不均:14 个中的 10 个来自用户态赛道。在内核赛道上,两个模型都未能解出四分之三的任务。由于每个任务人类专家均可解出,未解出的任务直接度量了模型与人类水平能力之间的剩余差距。轨迹分析将该差距归因于四种反复出现的失败模式:(i) 难以从已获得的原语完成利用链的最后阶段;(ii) 在缓解措施下策略选择不当,例如在纯数据(data-only)攻击更简单可靠时仍坚持控制流劫持;(iii) 陷入冗长而无产出的调试循环;(iv) 提交前对最终交付物的验证不足。
小结。 模型的网络能力在 Tier 1 以及 Tier 2 中的用户态利用上最强,但与人类专家仍有明显差距。在本质上是防御性的 Tier 1,模型能识别真实漏洞——包括此前未知的漏洞——并证明其可复现。在 Tier 2,它能对用户态目标完成端到端利用。然而面对加固目标,完成完整利用链仍是瓶颈,许多专家可解的任务仍未被解出。
英国 AI 安全研究院(UK AI Security Institute)与 NIST 人工智能标准与创新中心(CAISI)的独立联合评估 [124] 得出了与我们一致的结论。Kimi K3 在漏洞利用开发上优于 GLM-5.2(ExploitBench 上 32% 对 24%;在一个 32 步的模拟企业网络中推进 17 步对 11 步,人类专家完成该网络约需 20 小时),但在端到端漏洞利用完成度上落后于具备网络能力的前沿模型,在 41 个任务中实现任意代码执行的数量为 0。
我们认为本评测是模型能力的下界。这些结果以当前模型版本和评测覆盖范围为条件,我们将在每次重大模型更新时重新评测。
6.3 第三方评测
Kimi K3 发布后还接受了第三方机构的独立评测。表 5 汇总了截至 2026 年 7 月 23 日的代表性结果。
Artificial Analysis Artificial Analysis 对 Kimi K3 进行了评测 [8]。Kimi K3 的 Intelligence Index v4.1 达到 57.1,在 580 个模型中排名第四——若将 GPT-5.6 Sol 的各推理力度变体计为同一条目则为第三——落后于 Claude Fable 5(59.9)和 GPT-5.6 Sol(58.9),领先于其他所有参评模型。
Vals AI 在 Vals AI 的 GDP 加权行业基准套件 [125] 上,Kimi K3 以 74.7% 在 Vals Index 的 39 个模型中排名第二,落后于 Claude Fable 5(75.1%),领先 GPT-5.6 Sol(73.1%)。
Arena 在众包人类偏好竞技场 [75] 上,Kimi K3 在 WebDev Arena 以 1,678 Elo 在 99 个模型中排名第一(领先 Claude Fable 5 的 1,634)——是首个登顶该榜单的开源模型——并在 Text Arena 以 1,486 Elo 在 200 个模型中排名第八。在约 7 月 19 日开放投票的 Agent Arena 上,Kimi K3 目前在 37 个模型中排名第四(9.1),落后于 Claude Fable 5(12.7)、GPT-5.6 Sol(10.1)和 Claude Opus 4.8(9.8)。
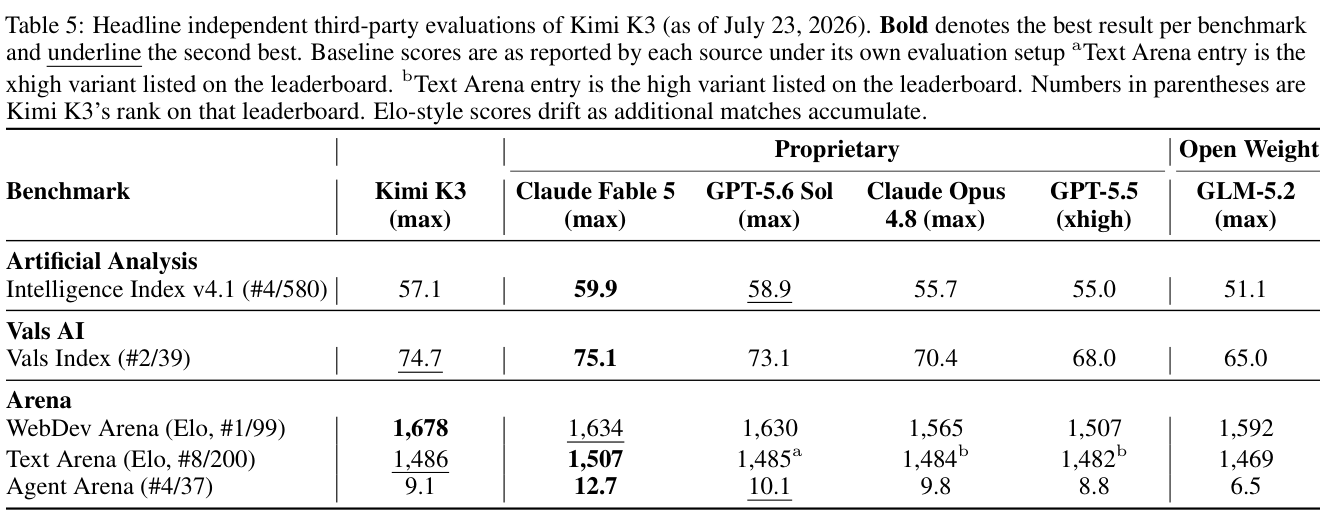
▍表 5:Kimi K3 的代表性独立第三方评测结果(截至 2026 年 7 月 23 日)。
加粗表示每个基准测试的最佳结果,下划线表示次佳。基线分数为各来源在其自有评测设置下报告的数值。a Text Arena 条目为榜单上列出的 xhigh 变体。b Text Arena 条目为榜单上列出的 high 变体。括号内数字为 Kimi K3 在该榜单上的排名。Elo 类分数会随对局累积而漂移。
6.4 成本效率
除分数外,我们还通过比较四个覆盖编程与智能体任务的套件——Kimi Code Bench 2.0、BrowseComp、GDPval-AA v2 和 AA-Briefcase——上的分数与单任务成本,考察推理成本效率。Kimi Code Bench 2.0 的成本为内部测量,其中 Kimi K3 通过 Kimi Code 运行,其他所有模型通过 Claude Code 运行。BrowseComp 上 Kimi K3 的成本来自我们自己的运行,Claude 和 GPT 的成本引自公开图表 [40, 18, 19]。GDPval-AA v2 和 AA-Briefcase 的成本引自 Artificial Analysis 截至 2026 年 7 月 23 日的按 token 计费 API 定价 [8]。
在 Kimi Code Bench 2.0 上,Kimi K3 落后 Claude Fable 5 4.0 分,但成本仅为其 38%;在 high 力度下,它已能以约三分之一的成本达到 Claude Opus 4.8 最大力度的分数。在 BrowseComp 上,Kimi K3 取得最佳分数(91.2%),单任务成本为 2.03 美元——是 GPT-5.6 Sol(90.4%)的一半,比 Claude 各模型在最大力度下的成本低一个数量级。在 GDPval-AA v2 上,Kimi K3 与 GPT-5.6 Sol 的 Elo 差距在 50 以内,且成本低 13%,比 Claude Fable 5 便宜 2.6 倍。在 AA-Briefcase 上,它取得仅次于 Claude Fable 5 的第二高分,成本约为后者的一半。图 13 汇总了这一对比。
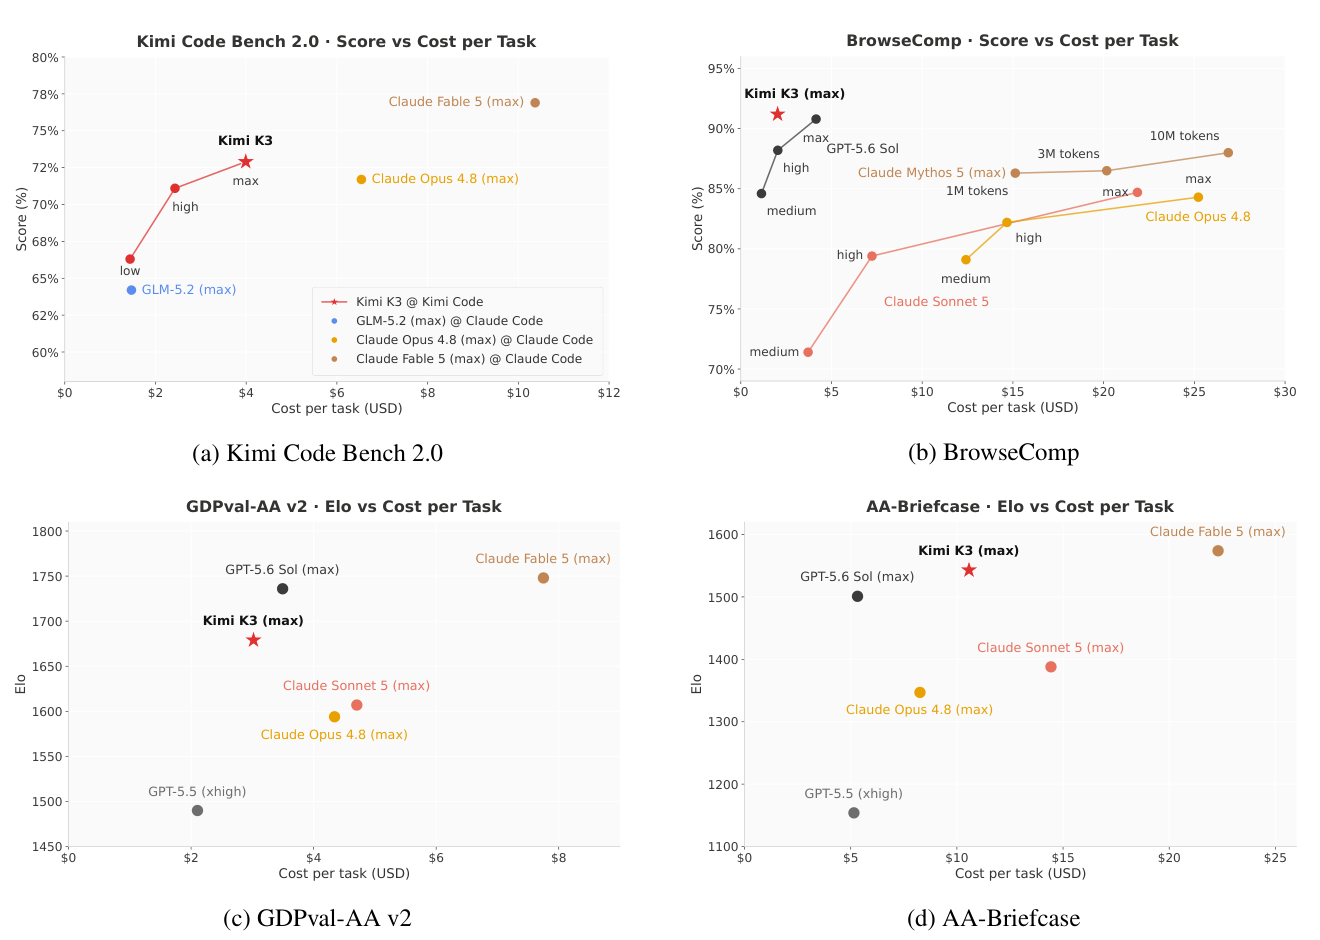
▍图 13:Kimi Code Bench 2.0、BrowseComp、GDPval-AA v2 和 AA-Briefcase 上分数与单任务推理成本的对比。
Kimi K3 以星号标注。
总体而言,Kimi K3 在全部四个套件上都位于或接近成本效率前沿,以仅为 Claude Fable 5 零头的成本交付接近最高水平的分数。
7 案例研究
本节展示若干代表性案例,演示 Kimi K3 在多样技术任务上的能力。
GPU 内核优化 我们测试了各模型优化 GPU 内核的能力。每个模型在配置完全相同的沙箱中独立工作,每个任务最多有 24 小时预算用于性能分析(profiling)、重写和基准测量。评测覆盖四个代表性内核:AttnRes、DeepSeek Sparse Attention(DSA)、KDA 和 MLA(头维度 512),运行在一块 NVIDIA Hopper GPU 和一块其他厂商的 GPGPU 上。Kimi K3 在全部四个内核上大幅提升了性能:将 AttnRes 延迟从 283.6 ms 降至 114.4 ms,将 DSA 和 KDA 的运行时间分别削减 55.1% 和 73.6%,并在 MLA 上达到峰值 TFLOPS 的一半以上。在这些任务上,Kimi K3 与 Claude Fable 5 [16](含回退)持平,并大幅优于 Claude Opus 4.8 [17]、GPT-5.6 Sol [40] 和 GPT-5.5 [39]。图 14 对比了各模型在 AttnRes 上的优化轨迹。在基准之外,后期开发阶段中,一个早期的 Kimi K3 检查点就已经承担了我们大部分的内核优化工作。
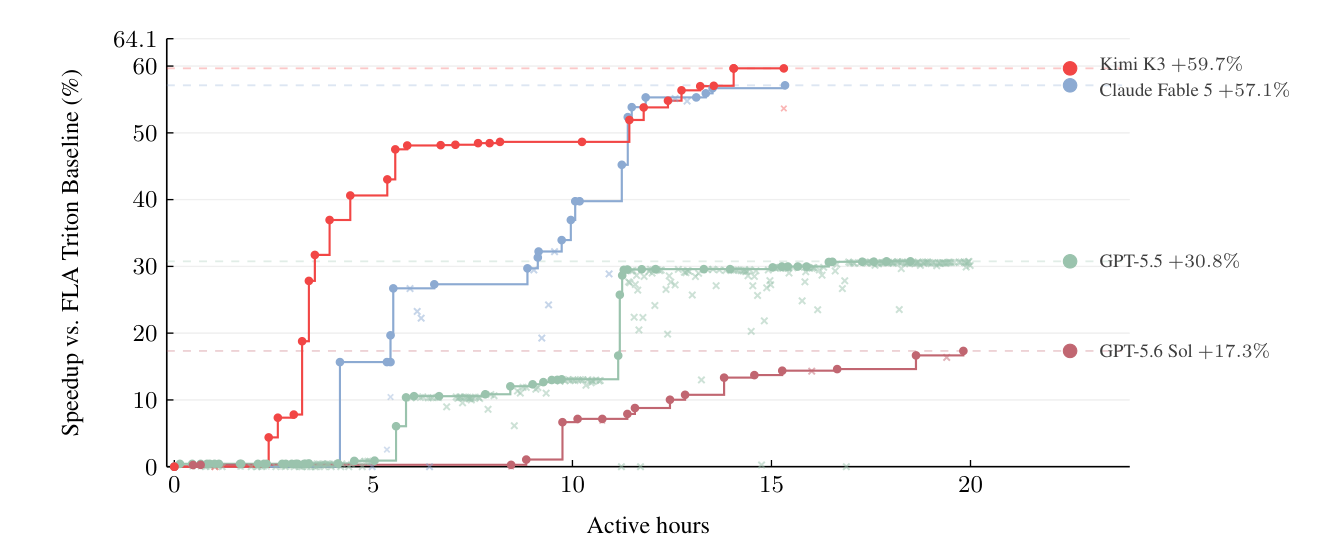
▍图 14:案例研究:AttnRes 上的 GPU 内核优化。
GPU 编译器开发 Kimi K3 开发了 MiniTriton5——一个紧凑的类 Triton [123] 编译器,包含定制的 tile 级 Python 前端与布局系统、轻量的 warp 级 MLIR [65] 标注与优化层,以及 Parallel Thread Execution(PTX)代码生成流水线。围绕该编译器构建的是一个双模式张量库,提供类 PyTorch [90] 的高级接口,其 eager 路径与仅前向的编译路径共享同一套 DSL 编译器和运行时。该库还提供反向模式自动微分、神经网络模块、基于 NCCL [83] 的分布式训练原语,以及稀疏与可视化原语。在 NVIDIA L20 上,MiniTriton 在其核心基准套件上的几何平均性能优于 PyTorch eager [90] 和 torch.compile [5]。其从零构建的张量核矩阵乘路径在最大形状上逼近 cuBLAS [22],达到实测机器 roofline 上限的约 90%;其 DSL 级的 KDA [64] 预填充内核则以明显优势优于对齐的 Triton 参考实现。MiniTriton 还能端到端训练一个 GPT 模型,损失曲线紧密跟随 PyTorch 参考;以 fp64 参考为基准测量,全模型梯度与 torch autograd 的差异不超过 torch 自身的 fp32 舍入误差()。这些结果共同表明,Kimi K3 能构建一个连贯的端到端编译器——从 DSL 前端和 IR pass 到 PTX 代码生成与 CUDA 运行时——而非一堆孤立内核的集合(图 15)。
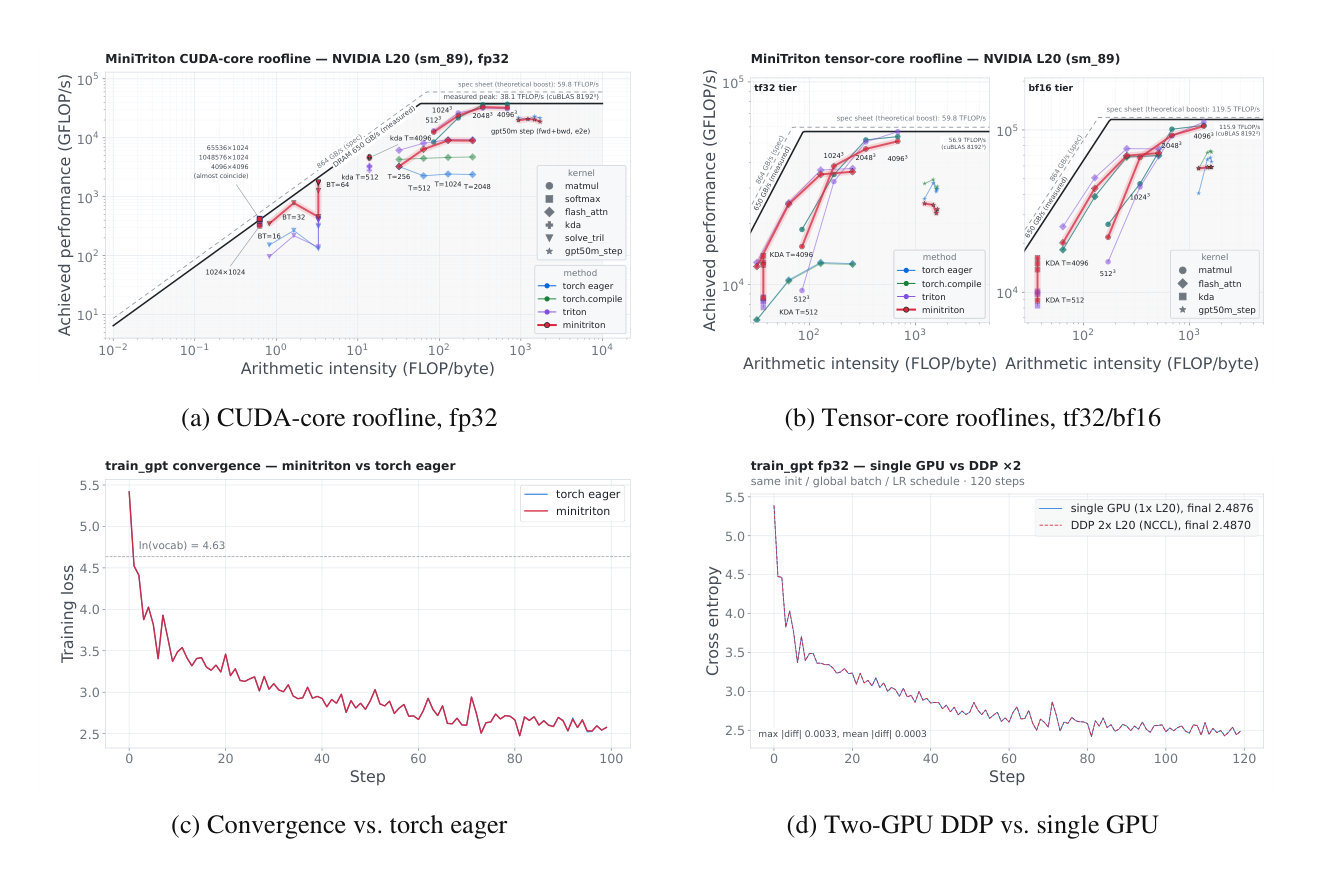
▍图 15:案例研究:使用 MiniTriton 开发 GPU 编译器。
(a)在 NVIDIA L20(sm_89)上,MiniTriton 内核的 CUDA 核与(b)张量核 roofline 图,对比 torch eager、torch.compile、Triton 和 cuBLAS 基线(落败数据点一并绘出);(c)使用 MiniTriton 与 torch eager 训练的字符级 GPT 的训练损失曲线;(d)基于 MiniTriton 自研分布式原语(NCCL)的双 GPU 数据并行训练与单 GPU 训练的对比。
芯片设计 作为早期概念验证,Kimi K3 为一个遵循相同架构的纳米模型(nano model)设计了推理芯片原型——混合 KDA 与 NoPE-MLA 注意力、块大小为 2 的 Block AttnRes、基于 sigmoid 的 MoE 路由(含一个共享专家)——并采用分组 INT4 权重量化(组大小 128)。在一次使用 Kimi Code 的 48 小时连续自主运行中,Kimi K3 使用开源 EDA 工具和 Nangate45 标准单元库 [81] 完成了芯片的构建、优化与验证。在 4 mm² 的分析面积预算内,该设计在 100 MHz 下完成时序收敛,RTL 仿真的解码吞吐量超过 8,700 token/s,集成 146 万个标准单元、0.277 MiB SRAM,以及融合反量化的 INT4 MAC 阵列。RTL 代码已在 GitHub 上开源6。
科研编程(Coding for research) 为复现计算天体物理学中的 I–Love–Q 普适关系,Kimi K3 查阅了 20 余篇论文并交叉验证其结果,实现了完整的数值计算流水线,评估了 300 多个状态方程,发现了已发表公式中的不一致之处,编写了超过 3,000 行 Python 代码,并产出一个交互式 HTML 仪表盘——全程约两小时,而有经验的研究人员通常需要一到两周。
知识工作(Knowledge work) 在 Kimi Work 中,Kimi K3 制作了一个覆盖 AI ASIC 产业 42 年历史的交互式研究网站。模型完成了 120 多轮迭代打磨,素材取自 87 份季度报告和 99 份原始 PDF(超过 11,000 页),其间执行了 2,800 多次网络搜索和 1,100 多次终端查询。在另一个案例中,Kimi K3 使用 20 多个并发子智能体分析了 GWTC-5 中的 391 个引力波事件,产出七幅科学可视化图、两张汇总表,以及一份综合十余篇论文的文献综述。
视频剪辑与动态设计(Video editing and motion design) 借助其原生多模态架构,Kimi K3 制作了一个讲解自身架构的 3Blue1Brown 风格动态图形科普视频,并用 56 个源片段剪辑了其预告视频。这涉及片段筛选、动作匹配剪辑、帧级精准的节拍同步、音频处理以及多轮修改。制作同等信息密度的短视频通常需要一位经验丰富的剪辑师一到两天。
8 结论
我们推出 Kimi K3——一个拥有原生视觉能力和 100 万 token 上下文窗口的开源 2.8T 参数混合专家(MoE)模型,构建于 Kimi Delta Attention 与 Attention Residuals 之上。作为全球首个开源的 3T 级模型,Kimi K3 在长周期编程、智能体、知识、推理和视觉任务上交付了前沿级性能。尽管与最强闭源模型仍有差距,Kimi K3 建立了一个所有人触手可及的开源新前沿。我们希望它能在研究、部署与创新中赋能更广泛的社区。
附录 A 贡献者
贡献者名单按姓氏字母顺序排列。
Tongtong Bai、Yifan Bai、Yiping Bao、M. C.、Jianfeng Cai、Xinyuan Cai Peizhou Cao、Yuxuan Cao、Ziwei Chai、Y. Charles、H.S. Che、Guanduo Chen Guangyu Chen、Guanzheng Chen、Huarong Chen、Jia Chen、Jianlong Chen、Jun Chen Kexin Chen、Peng Chen、Ruijue Chen、Wentao Chen、Xin Chen、Yang Chen Yanru Chen、Yifei Chen、Yingjiang Chen、Yuankun Chen、Yujie Chen、Yutian Chen Zhirong Chen、Dazhi Cheng、Yean Cheng、Jialei Cui、Jingbing Cui、Anqi Dai Jiaqi Deng、Hao Ding、Rui Ding、Shaofeng Ding、Mengfan Dong、Mengnan Dong Yuhao Dong、Yuxin Dong、Ang’ang Du、Chenzhuang Du、Dikang Du、Jusen Du Yulun Du、Yu Fan、Jing Feng、Qiulin Feng、Yichen Feng、Kelin Fu、Qiang Fu Fuxuan Gao、Hongcheng Gao、Jingyue Gao、Tong Gao、Weijia Gao、Shangyi Geng Jie Gong、Linhu Gong、Shengao Gong、Xiaochen Gong、Qizheng Gu、Yicheng Gu Shuhao Guan、Haiqing Guo、Shiqi Guo、Xiang Guo、Zhengyan Guo、Beixi Hao Wenxin Hao、Xiaoru Hao、Dailan He、Haotian He、Lehan He、Qi He、Weiran He Xinran He、Xinyi He、Yibo He、Yunjia He、Chao Hong、Tiange Hong、Hao Hu Jiaxi Hu、Ruikun Hu、Weiming Hu、Yangyang Hu、Zhenxing Hu、Liang Hua Jinbin Huang、Ke Huang、Ruiyuan Huang、Siying Huang、Weixiao Huang、Yan Huang Zhengjie Huang、Zhiqi Huang、Yulong Hui、Chaobo Jia、Yutong Jiang Zhejun Jiang、Zuoyou Jiang、Wenyi Jin、Xinyi Jin、Yu Jing、Huanjun Kong Guokun Lai、Aidi Li、Cheng Li、Chengyuan Li、Cong Li、Fang Li、Guanyu Li Haoyang Li、Jia Li、Junxiong Li、Lei Li、Letian Li、Lincan Li、Weihong Li Wentao Li、Xintong Li、Yang Li、Yishen Li、Yiwei Li、Yuxiao Li、Zhaowei Li Zhaoxi Li、Zheming Li、Zhengxiao Li、Zhiyuan Li、Jiawei Lin、Xiaohan Lin Yibo Lin、Zichao Lin、Ziyan Lin、Bill Liu、Boxiao Liu、Chuan Liu、Liang Liu Shaowei Liu、Shudong Liu、Shuran Liu、Tianwei Liu、Weizhou Liu、Yangyang Liu Yanming Liu、Yibo Liu、Yipeng Liu、Zhengying Liu、Zhiheng Liu、Enzhe Lu Haoyu Lu、Linqiang Lu、Tingzhan Lu、Zhiyuan Lu、Aotian Luo、G. Luo、Junyu Luo Yifan Luo、B. Lyu、Wenzhou Lyu、Shaoguang Mao、Yuan Mei、Xin Men、Minqing Ni Yixuan Niu、Siyuan Pan、Shujun Peng、Zhangyang Qi、Ruoyu Qin、ZeChao Qin Zeyu Qin、Haiquan Qiu、Jianxin Qiu、Jiezhong Qiu、Bowen Qu、Yuhao Qu Zeyu Shang、Youbo Shao、Han Shen、Jincheng Shi、Juanfeng Shi、Lidong Shi Shengyuan Shi、Wingchun Siu、Pengwei Song、Xiaoxi Song、Jianlin Su Yunfeng Su、Zhaochen Su、Lin Sui、Jingsong Sun、Junyao Sun、Shaoning Sun Shuzhe Sun、Tongyu Sun、Yujun Sun、Yunpeng Tai、Chuning Tang、Heyi Tang Sirui Tang、Zecheng Tang、Chaoran Tian、Rongpeng Tian、Yu Tian、Wei Tu Chensi Wang、Chuang Wang、Chunjie Wang、Dinglu Wang、Feng Wang、Hailong Wang Haiming Wang、Hao Wang、Hao Wang、Huaqing Wang、Hui Wang、Jiayi Wang Jinglong Wang、Jinhong Wang、Jiuzheng Wang、Linian Wang、Shaobo Wang Shenzhi Wang、Shuyi Wang、Si Wang、Siyuan Wang、Tianfu Wang、Wenjue Wang Xingran Wang、Xinmei Wang、Xinyuan Wang、Xusheng Wang、Yalin Wang Yangkun Wang、Yao Wang、Yaoyu Wang、Yejie Wang、Yiqin Wang、Yucheng Wang Yuzhi Wang、Zhaoji Wang、Zhaowei Wang、Zhengtao Wang、Zhenhao Wang Zhongsheng Wang、Zifan Wang、Chu Wei、Ming Wei、Shouxin Wei、Zichen Wen Fan Wu、Haoning Wu、Rucong Wu、Wenhao Wu、Xiaoxue Wu、Yingcong Wu、Yongqi Wu Yuxin Wu、Zijian Wu、Xinglang Xian、Chenxuan Xiang、Yuye Xiang、Bocheng Xiao Chenjun Xiao、Xin Xiao、Jin Xie、Xiaotong Xie、Yifeng Xie、Zhe Xie、Bowei Xing Yiming Xiong、Baosheng Xu、Boyu Xu、Jiale Xu、Jianfan Xu、Jing Xu、Jinjing Xu L.H. Xu、Qingtao Xu、Shuyao Xu、Suting Xu、Tiantian Xu、Tianxiang Xu Weixin Xu、Xinran Xu、Yangchuan Xu、Ye Xu、Yueni Xu、Ziyao Xu、Haonan Xue Junjie Yan、Yaoyao Yan、Fan Yang、Guangyao Yang、Hao Yang、Junwei Yang Ruoyu Yang、Wenjie Yang、Xiaofei Yang、Xinyu Yang、Yi Yang、Yiling Yang Ying Yang、Yuchen Yang、Zhen Yang、Zhilin Yang、Zian Yang、Zuhao Yang Haotian Yao、Dan Ye、Haoran Ye、Wenjie Ye、Zhanbo Ye、Bohong Yin、Haoxiang Yin Xietong Yin、Chengzhen Yu、Haozhen Yu、Longhui Yu、Shengnan Yu、Shuying Yu Tianxiang Yu、Enming Yuan、Mengjie Yuan、Tongtian Yue、Wei Yue、Yang Yue Dunyuan Zha、Haobing Zhan、B.H. Zhang、Dehao Zhang、Fei Zhang、Hao Zhang Haoyuan Zhang、Huanyu Zhang、Jiapei Zhang、Jiaxuan Zhang、Jin Zhang Kaiyi Zhang、Miaozhen Zhang、Puqi Zhang、Qinglei Zhang、Rong Zhang、Rui Zhang Shaoshuai Zhang、Shiyi Zhang、Xiaobin Zhang、Xiaoyun Zhang、Y. Zhang Yangkun Zhang、Ye Zhang、Yichi Zhang、Yikun Zhang、Yizhi Zhang Yongting Zhang、Yu Zhang、Yutao Zhang、Yutong Zhang、Zheng Zhang Zijing Zhang、Bin Zhao、Chenguang Zhao、Feifan Zhao、Jinglun Zhao Jinxiang Zhao、Shuai Zhao、Wenshuo Zhao、Xiangyu Zhao、Xuanle Zhao Yikai Zhao、Zijia Zhao、Haozhi Zheng、Huabin Zheng、Ruihan Zheng Shaojie Zheng、Tengyang Zheng、Haofeng Zhong、Lei Zhong、Longguang Zhong M. Zhou、Qiankang Zhou、Runjie Zhou、Ruozhang Zhou、Xinyu Zhou、Yiqiao Zhou Zaida Zhou、Jinguo Zhu、Liya Zhu、Xinhao Zhu、Yangjunfeng Zhu、Yuxuan Zhu Zhen Zhu、Chen Zhuang、Weiyu Zhuang、Xinxing Zu、Kimi K3
附录 B SiTU-GLU(Sigmoid Tanh Unit GLU)的细节
SiTU-GLU(§2.3.2)的设计目标是在不丢失 Swish 特征形状的前提下为 SwiGLU 的乘积加上界——即原点附近近似线性的响应,以及趋于消失的负向尾部。图 4 给出了门控分支与升分支以及它们完整的标量响应曲线。
对两个分支做平滑封顶
SiTU 将 Swish 的线性因子封顶为 ,同时保留 sigmoid 因子 [61]。由于 sigmoid 已经把负向的门控响应压向零,这一改动主要控制大幅正向激活,而不会去掉负向尾部。Kimi K3 将同样的构造应用于升分支,即 ,防止任一分支主导乘积。
局部与极限行为
对于原点附近的标量 ,缩放后的 tanh 满足
因此 SiTU-GLU 在原点附近与 SwiGLU 一阶吻合;当 时,它也逐点恢复为 SwiGLU。
有界输出
由于 且 ,输出的每个坐标都满足
其中 、。与对门控预激活做硬截断不同,平滑封顶在远离饱和边界处仍保留非零梯度,我们发现这能带来更好的训练行为。
附录 C Quantile Balancing(QB,分位数平衡)推导
本附录从最优平衡分配出发,推导 §2.3 中使用的 Quantile Balancing(QB)更新,推导遵循 [112];从分配的视角看待专家负载均衡可以追溯到 BASE Layers [68] 与 BIP [117]。
设 汇总了 个 token 在 个专家上的路由器打分,其中每个 token 恰好选择 个专家, 表示 token 是否被分配给专家 。在每个专家恰好服务 个 token(假定为整数)的约束下,最大打分的平衡分配为
线性松弛与对偶
将 松弛为 ,式 (20) 变为一个线性规划;由二部图 -匹配多胞形的标准整性,其最优解是整数的,因此该松弛是精确的。分别针对 token 侧与专家侧的等式约束引入自由乘子 与 ,松弛问题可写成 max–min 形式:
目标函数关于 、、 三者均为线性,且可行集均为凸集,因此由极小极大定理可以交换优化次序:
内层最大化在各元素上可分离:当 时 ,当 时 ;取等的情形在实践中测度为零。代入 得到凸的对偶目标
精确的坐标最小化
我们通过交替地在固定 时求解 、固定 时求解 来最小化式 (23);每个子问题都有闭式的精确解。固定 时,问题在各 token 上解耦,对 token 求解
该目标关于 分段线性,斜率等于 减去超过 的边际 的个数;因此当恰好有 个边际位于 之上时目标取到最小值,即 可以取 中第 大与第 大元素之间的任意值。按惯例我们取第 大的元素,它等价于 分位数:
对称地,固定 时,专家 求解 ,其最小解是 中第 大的元素,同样是 分位数:
两个更新因此分别是沿 token 轴与专家轴取的同一个分位数,该方法由此得名。图 5 将专家侧的更新直观展示为拉平每个专家边际分布中被接受的上尾部,算法 1 总结了由此得到的交替求解器。
▍算法 1:交替式 QB 求解器
Input: score matrix s ∈ R^{m×n}
Output: assignment x ∈ {0, 1}^{m×n}
1  Initialize β = 0^{1×n};
2  for t = 1, 2, ···, T do
3      α ← desc_sort(s − β, axis=1)[:, k : k+1]
4      β ← desc_sort(s − α, axis=0)[mk/n : mk/n+1]
5  end
6  return x with x_{i,j} = 1 if j ∈ argtopk(s_i − β), and 0 otherwise
从分配到路由
在式 (23) 的最优点处, 当且仅当 ;结合 token 侧约束 ,被选中的专家恰好是 的 Top- 项。因此路由只需要专家侧阈值 (等价于式 (13) 中的偏置 ),而 token 侧阈值 只是与动态训练批次绑定的中间变量,随即被丢弃。这种不对称性保持了训练–推理一致性:部署时路由是在冻结偏置下的固定 Top- 选择,无需任何分位数计算。
与基于符号的无辅助损失更新的关系
式 (26) 背后的专家侧子问题的(次)梯度为
即专家 的目标负载减去观测负载。在符号约定 之下,对该目标做一步 SignSGD 正好恢复无辅助损失均衡(auxiliary-loss-free balancing)[30] 的定步长符号更新:符号更新只保留式 (27) 中负载误差的方向,而 QB 则直接跳到同一对偶目标的精确坐标最小解。这一视角同时解释了为什么 QB 不需要类似学习率的超参数,以及为什么即使面对接近 个专家,它也能在寥寥几步更新内达到均衡。QB 同样与 BIP [117] 相关,后者求解带有不等式约束 与 的同一分配问题;由此在 与 上诱导出的非负约束会给两个更新都加上 截断,这只能压制被过度选择的专家,而无法提携选择不足的专家,在我们的实验中明显拖慢了均衡速度。最后,由此得到的固定 Top- 路由与按专家设阈值的路由相关,但不同于 Expert Threshold 路由——后者维护 EMA 阈值,并允许每个 token 选中可变数量的专家 [113]。
附录 D 基于直方图的分位数估计
式 (14) 的 QB 更新要求在整个训练步上取分位数:对 个专家中的每一个,取边际 的 分位数,而 token 数 高达数百万,且被切分到各个数据并行 rank 与梯度累积步上。在训练循环内汇集 个边际来求精确分位数是不现实的。关键观察是:更新从来不需要边际本身,只需要它们按专家的分布,而直方图可以用固定开销概括这一分布。因此 Kimi K3 为每个专家维护一个分桶直方图,并从中读出分位数。具体地,我们对所需偏置 做直方图——它恰好是把专家 放到 token 的截断点上的偏置;对边际取负会反转其顺序,因此式 (14) 的 QB 目标 恰好是 的 分位数。
分桶区间
第一个问题是在哪个区间上分桶,而所需偏置在这里又帮了忙:它的取值范围被当前偏置本身所界定。路由器打分是 sigmoid 的输出,故 ;而截断点 本身就是某个专家 的加偏打分 ,因此落在 内,其中 与 是当前偏置的极值。于是每个 都落在 内。我们将该区间划分为 个均匀桶——实践中发现这已经足够——并且每一步重新计算区间,于是桶宽 会随着偏置为纠正不均衡而扩散时保持自适应。
累积与恢复
其余流程与训练步的结构相对应。每次前向传播时,每个 rank 把本地的 值 scatter-add 进按专家的计数矩阵 ,在所有微批次上累积,全程无通信。该步结束时,一次 all-reduce 把各本地计数汇总为全局直方图,每个 rank 从同一份汇总计数中恢复分位数。每个专家的直方图对每个 token 恰好计数一次,因此目标位次恰好是 §2.3.3 的目标负载 ,只是现在取在完整的一步之上:我们选出累计计数首次达到 的桶,并在桶内线性插值。若选中的桶为 ,其之前的累计计数为 、桶内计数为 ,则
随后如式 (14) 一样对所得偏置做均值中心化。
性质
三点性质使该估计器在大规模下切实可用。第一,它足够准确:累计计数在桶边界处是精确的,因此真实分位数与其估计值落在同一个桶内,误差以桶宽 为上界;取 时误差至多几个 ,且我们观测不到任何可度量的残余负载不均衡。第二,它足够便宜:唯一的通信是每层每步一次 个整数值的 all-reduce,与 无关;在我们的配置下,其开销不到「每个微批次在进程组内交换原始边际」这一自然替代方案的 1%。第三,它估计的是正确的量:由于计数可加的,全局直方图对 token 如何划分到各 rank 或各累积步完全不敏感,估计结果是汇集后的全局批次的分位数,而非各 rank 分位数的平均——后者一般并不等于前者。作为进一步的改进,对估计出的分位数跨步维护指数滑动平均(EMA),可以降低批次间的采样噪声,进一步改善负载均衡。
附录 E MoonEP 通用上界证明
记 为方案 下放置在 rank 上的冗余专家数量。对于路由器输出 ,规划目标是最小化任意 rank 上冗余专家数的最大值,即 。我们证明 恒成立(定理 1),且该上界本质上是紧的:存在使 的路由器输出(定理 2)。
定理 1(通用上界)的证明
目标是证明对任意路由器输出 都有 。关键引理:存在一个方案 ,使得每个 EP rank 恰好收到相同数量的 token(),且每个 rank 的远端 token 只来自另外一个 EP rank。构造如下:初始时每个 rank 只持有本地 token,并据此被划分为欠载或过载。我们反复取一个欠载 rank 和一个过载 rank,把 token 从过载 rank 迁出,恰好把欠载 rank 填到均衡值 ;过载 rank 可能仍然过载、变为恰好均衡、或变为欠载,并被放回相应的集合。重复该过程直到所有 rank 完全均衡。每次填充使一个欠载 rank 变为均衡且此后不再变化,因此该过程至多经过 次填充即终止;同时,每个 rank 至多被填充一次,故其远端 token 来自单一的 rank,引理得证。由此,设 rank 的所有远端 token 来自 rank ;这些 token 至多属于 rank 上的 个本地专家,故 ,从而
定理 2(上界之紧性)的证明
构造路由器输出 如下:EP rank 0 上的专家收不到任何 token,而其余 个 rank 上的所有专家均匀分享全部 token。于是全部 个 token 被均匀分给 个专家,每个专家收到 个 token。在任意方案 下,rank 0 必须收到 个 token,且全部为远端 token,这些 token 至少涉及
个不同的专家;取上整后,rank 0 至少需要 个冗余专家,因此 。
反过来,用定理 1 证明中的填充过程构造一个方案,并优先按专家整体迁移 token,可以使每个 rank 上的冗余专家数都不超过该值,故等号成立。由于 较大时 ,定理 1 的上界本质上是紧的:不存在显著小于 的通用上界。
附录 F 对话模板(Chat Template)
Kimi K3 的对话模板围绕三个目标重新设计。第一是可扩展性:新能力应通过向后兼容的消息格式引入,而不是通过修改模板版本,从而用单一模板服务整个模型世代。第二是低对齐税:该格式应当只需极少的监督数据即可学会,支撑一条「轻度微调的预训练模型可以直接进入强化学习(RL)」的流水线。第三是解码友好:结构应当便于实现简单的编码器、流式解析器与语法约束执行器。为此,模板采用 XTML(eXtensible Token Markup Language,可扩展 token 标记语言)——一种类 XML 的标记方式,其中尖括号语法被三个保留的特殊 token 取代:[open]、[sep] 与 [close],另有一个 [end_of_msg] token 作为生成停止标记。元素 [open]tag attr="value"[sep] ... [close]tag[sep] 与其 XML 对应物同构,但每个结构边界都是显式的特殊 token,这消除了元素边界处的分词歧义,并简化了约束解码。
消息与分区
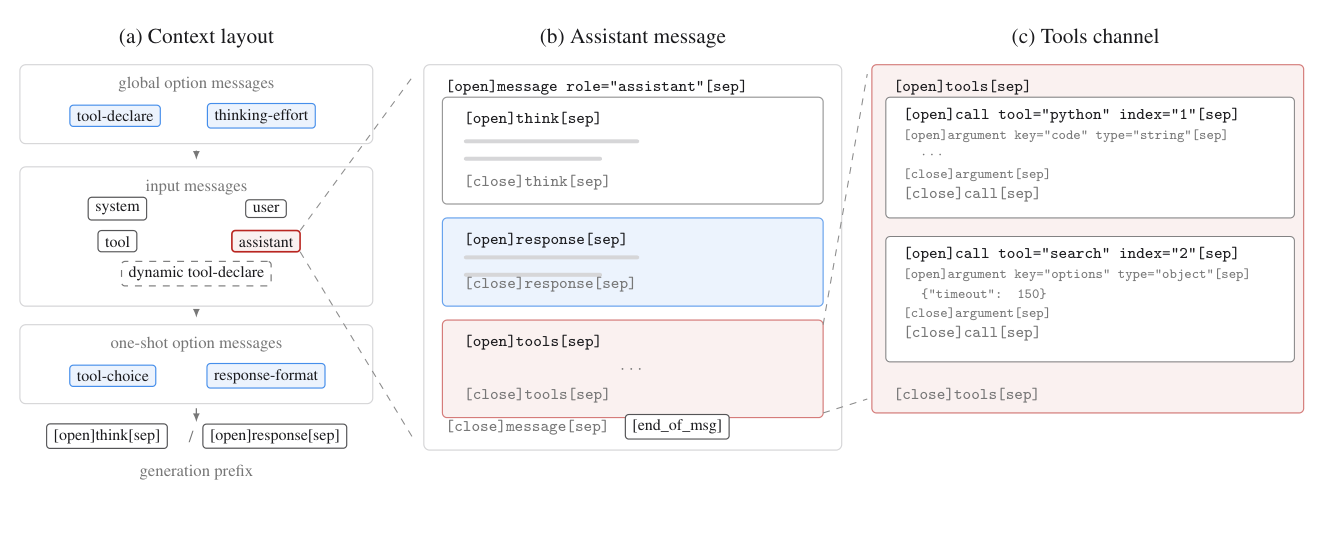
上下文的顶层单元是消息,消息按来源分为两类(图 16a)。输入消息(input messages)序列化请求的 messages 字段,涵盖常见的 system、user、assistant 与 tool 角色。选项消息(option messages)把请求选项翻译成模型在上下文中读取的指令,其摆放位置反映其作用域。全局选项——工具声明(type="tool-declare")与推理力度(reasoning-effort)设置——出现在所有输入消息之前:它们管辖整个会话且很少变化,反正修改它们总会使 KV 缓存失效。一次性选项(tool_choice、response_format)追加在输入消息之后,使逐请求的变更保持历史 KV 缓存完好无损。第三类是输入选项消息(input option message),它与输入消息交错排列,用于在会话中途补充或覆盖某个全局选项。该机制支持动态加载的工具:在对话中被检索或加载的工具,会通过一条额外的 tool-declare 消息宣告,此后模型的可用工具集随之扩充,而无需重建此前的上下文。
▍图 16:Kimi K3 对话模板的结构。
(a)上下文布局:全局选项消息位于输入消息之前,一次性选项消息位于其后,使逐请求的选项不破坏历史 KV 缓存;动态加载的工具以输入选项消息(虚线)的形式在会话中途注入。(b)assistant 消息剖析:消息体组织为 think、response 与 tools 三个通道。(c)tools 通道的展开:并行工具调用带有索引,使工具结果可以匹配到各自的调用,且参数带类型。
通道
assistant 消息的消息体被组织为若干通道(channel),这一概念的灵感来自 OpenAI 的 Harmony 响应格式 [86]:think 承载推理轨迹,response 承载用户可见的回答,tools 承载工具调用(图 16b)。两种生成模式完全通过生成前缀选择——思考模式用 [open]think[sep],指令模式用 [open]response[sep]——而不是通过各自的独立模板。Kimi K3 只支持保留式思考(preserved thinking):在思考模式下,think 通道始终保留在历史中——即使其内容为空也照样保留——使模型在各轮之间看到一致的消息结构;在指令模式下,历史消息只包含 response 与 tools 通道。
工具调用
在 tools 通道内,每个调用携带 tool 与 index 属性;index 为同一消息内的并行调用编号,每条 tool-result 消息重复相同的 tool/index 对,并遵循其调用的顺序,使结果与调用的对应关系毫无歧义。参数是带类型的:字符串参数以原始文本出现,其他 JSON 类型的值则紧凑序列化。因此代码等自由文本是一等公民,而不是转义后的 JSON 字符串。一个纯 JSON 回退块用于覆盖无法分解为带类型参数块的输入;它只出现在输入 token 中,绝不出现在模型输出中,且其损失在训练时被掩蔽。
推理力度与选项
推理力度以一条类型为 thinking-effort 的全局选项消息对外暴露,插入在工具声明之后、输入消息之前。该消息既不修改生成前缀,也不暴露 token 预算,而是用自然语言陈述所请求的档位,充当一条生成约束指令。schema 预留了四档(low、medium、high 与 max),Kimi K3 支持其中的一个子集。这种表示把推理力度接口与模板语法解耦,并与 §4.1.1 和 §4.1.2 所述的推理力度条件化训练直接对齐。
更广泛地说,这是所有选项消息的共同实现方式:tool_choice、response_format 与 thinking-effort 各自被翻译为一条置于上下文中的简短自然语言指令,而非专用的特殊语法。由于预训练模型已经能很好地遵循这类指令,引入新选项几乎不需要额外训练——这正是上文所述低对齐税设计原则的直接体现。
参考文献
- [1] τ³-Banking. Sierra. 2026. URL: https://taubench.com/blog/tau-knowledge.html.
- [2] AA-Briefcase: Agentic Knowledge Work Benchmark. Artificial Analysis. 2026. URL: https://artificialanalysis.ai/evaluations/aa-briefcase.
- [3] Alexandru Agache et al. “Firecracker: Lightweight Virtualization for Serverless Applications”. In: 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI). 2020, pp. 419–434.
- [4] Agents’ Last Exam. UC Berkeley RDI. 2026. URL: https://agents-last-exam.org/leaderboard.
- [5] Jason Ansel et al. “PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation”. In: Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS). 2024. DOI: 10.1145/3620665.3640366.
- [6] Anthropic. Claude’s Extended Thinking. https://www.anthropic.com/research/visible-extended-thinking. Accessed: 2026-07-23. Feb. 2025.
- [7] Anthropic. Introducing Claude 4. https://www.anthropic.com/news/claude-4. Accessed: 2026-07-23. May 2025.
- [8] Artificial Analysis. Artificial Analysis. 2026. URL: https://artificialanalysis.ai/.
- [9] Artificial Analysis Long Context Reasoning (AA-LCR). Artificial Analysis. 2026. URL: https://artificialanalysis.ai/evaluations/artificial-analysis-long-context-reasoning.
- [10] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural Machine Translation by Jointly Learning to Align and Translate. 2014. arXiv: 1409.0473 [cs.CL]. URL: https://arxiv.org/abs/1409.0473.
- [11] Chaithanya Bandi et al. MCP-Atlas: A Large-Scale Benchmark for Tool-Use Competency with Real MCP Servers. 2026. arXiv: 2602.00933 [cs.SE].
- [12] Better MoE Model Inference with Warp Decode. Cursor. 2026. URL: https://cursor.com/blog/warp-decode (visited on 07/20/2026).
- [13] Liang Chen et al. BabyVision: Visual Reasoning Beyond Language. 2026. arXiv: 2601.06521 [cs.CV]. URL: https://arxiv.org/abs/2601.06521.
- [14] Yutian Chen et al. FlashKDA: Flash Kimi Delta Attention. 2026. URL: https://github.com/MoonshotAI/FlashKDA.
- [15] Claude Code. Anthropic. 2026. URL: https://docs.anthropic.com/en/docs/claude-code.
- [16] Claude Fable 5. Anthropic. 2026. URL: https://www.anthropic.com/news/claude-fable-5-mythos-5.
- [17] Claude Opus 4.8. Anthropic. 2026. URL: https://www.anthropic.com/news/claude-opus-4-8.
- [18] Claude Sonnet 5. Anthropic. 2026. URL: https://www-cdn.anthropic.com/283ef97c476cf442c91d9a37d5b214242a55bb92/Claude%20Sonnet%205%20System%20Card.pdf.
- [19] Claude Sonnet 5. Anthropic. 2026. URL: https://www.anthropic.com/news/claude-sonnet-5.
- [20] Codex. OpenAI. 2026. URL: https://github.com/openai/codex.
- [21] CorpFin v2. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/corp_fin_v2.
- [22] cuBLAS. NVIDIA. 2026. URL: https://developer.nvidia.com/cublas.
- [23] Damai Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. arXiv: 2401.06066 [cs.CL]. URL: https://arxiv.org/abs/2401.06066.
- [24] Tri Dao and Albert Gu. “Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality”. In: CoRR abs/2405.21060 (2024). DOI: 10.48550/ARXIV.2405.21060. arXiv: 2405.21060. URL: https://doi.org/10.48550/arXiv.2405.21060.
- [25] Dao AI Lab. ReplaySSM: Cache SSM Inputs, Not State. https://tridao.me/blog/2026/replayssm/. June 2026.
- [26] Yann N. Dauphin et al. “Language Modeling with Gated Convolutional Networks”. In: Proceedings of the 34th International Conference on Machine Learning. Vol. 70. Proceedings of Machine Learning Research. PMLR, 2017, pp. 933–941. URL: https://proceedings.mlr.press/v70/dauphin17a.html.
- [27] Soham De et al. Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models. 2024. arXiv: 2402.19427 [cs.LG]. URL: https://arxiv.org/abs/2402.19427.
- [28] DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. arXiv: 2405.04434 [cs.CL]. URL: https://arxiv.org/abs/2405.04434.
- [29] DeepSeek-AI. “DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence”. In: arXiv preprint arXiv:2606.19348 (2026).
- [30] DeepSeek-AI et al. DeepSeek-V3 Technical Report. 2024. arXiv: 2412.19437 [cs.CL]. URL: https://arxiv.org/abs/2412.19437.
- [31] DeepSWE Benchmark. Datacurve. 2026. URL: https://deepswe.datacurve.ai/.
- [32] Venmugil Elango et al. LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts. 2026. arXiv: 2601.18089 [cs.LG]. URL: https://arxiv.org/abs/2601.18089.
- [33] William Fedus, Barret Zoph, and Noam Shazeer. “Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity”. In: Journal of Machine Learning Research 23.120 (2022), pp. 1–39.
- [34] Weiqi Feng et al. “Optimus: Accelerating Large-Scale Multi-Modal LLM Training by Bubble Exploitation”. In: 2025 USENIX Annual Technical Conference (USENIX ATC 25). Boston, MA: USENIX Association, July 2025, pp. 161–177. ISBN: 978-1-939133-48-9. URL: https://www.usenix.org/conference/atc25/presentation/feng.
- [35] Finance Agent v2. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/fabv2.
- [36] FrontierSWE. 2026. URL: https://www.frontierswe.com/.
- [37] Chaoyou Fu et al. Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis. 2024. arXiv: 2405.21075 [cs.CV]. URL: https://arxiv.org/abs/2405.21075.
- [38] GLM-5.2. Z.ai. 2026. URL: https://z.ai/blog/glm-5.2.
- [39] GPT-5.5. OpenAI. 2026. URL: https://openai.com/index/introducing-gpt-5-5/.
- [40] GPT-5.6 Sol. OpenAI. 2026. URL: https://openai.com/index/previewing-gpt-5-6-sol/.
- [41] Daya Guo et al. “DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning”. In: Nature 645.8081 (2025), pp. 633–638. ISSN: 1476-4687. DOI: 10.1038/s41586-025-09422-z. URL: http://dx.doi.org/10.1038/s41586-025-09422-z.
- [42] Wentao Guo et al. SonicMoE: Accelerating MoE with IO and Tile-aware Optimizations. 2025. arXiv: 2512.14080 [cs.LG]. URL: https://arxiv.org/abs/2512.14080.
- [43] Harvey LAB: Legal Agent Benchmark. Harvey. 2026. URL: https://www.harvey.ai/blog/introducing-harveys-legal-agent-benchmark.
- [44] Kaiming He et al. Deep Residual Learning for Image Recognition. 2015. arXiv: 1512.03385 [cs.CV]. URL: https://arxiv.org/abs/1512.03385.
- [45] Hermes Agent. Nous Research. 2026. URL: https://hermes-agent.nousresearch.com/docs/.
- [46] Jordan Hoffmann et al. Training Compute-Optimal Large Language Models. 2022. arXiv: 2203.15556 [cs.CL]. URL: https://arxiv.org/abs/2203.15556.
- [47] Shengding Hu, Yuge Tu, Xu Han, et al. “MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies”. In: (2024). arXiv: 2404.06395 [cs.CL].
- [48] Ailin Huang, Ang Li, Aobo Kong, et al. “Step 3.5 Flash: Open Frontier-Level Intelligence with 11B Active Parameters”. In: arXiv preprint arXiv:2602.10604 (2026).
- [49] Yanping Huang et al. “Gpipe: Efficient training of giant neural networks using pipeline parallelism”. In: Advances in neural information processing systems 32 (2019).
- [50] Benoit Jacob et al. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference”. In: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR). 2018, pp. 2704–2713.
- [51] Sam Ade Jacobs et al. DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models. 2023. arXiv: 2309.14509 [cs.LG]. URL: https://arxiv.org/abs/2309.14509.
- [52] Peijie Jiang et al. PowLU: An Activation Function for Stable Pre-Training of LLMs. 2026. arXiv: 2605.25704 [cs.CL]. URL: https://arxiv.org/abs/2605.25704.
- [53] JobBench: Aligning Agent Work with Human Will. July 24, 2026. URL: https://job-bench.github.io/.
- [54] Keller Jordan et al. Muon: An Optimizer for Hidden Layers in Neural Networks. 2024. URL: https://kellerjordan.github.io/posts/muon/.
- [55] Jared Kaplan et al. Scaling Laws for Neural Language Models. 2020. arXiv: 2001.08361 [cs.LG]. URL: https://arxiv.org/abs/2001.08361.
- [56] Angelos Katharopoulos et al. “Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention”. In: Proceedings of ICML. Ed. by Hal Daumé III and Aarti Singh. PMLR, 2020, pp. 5156–5165. URL: https://proceedings.mlr.press/v119/katharopoulos20a.html.
- [57] Kimi CLI. Moonshot AI. 2026. URL: https://www.kimi.com/code.
- [58] Kimi Team. Attention Residuals. Preprint. 2026.
- [59] Kimi Team. Kimi K2: Open Agentic Intelligence. 2025. arXiv: 2507.20534 [cs.LG].
- [60] Kimi Team. “Kimi K2.5: Visual Agentic Intelligence”. In: arXiv preprint arXiv:2602.02276 (2026).
- [61] Kimi Team. Kimi K3: Open Frontier Intelligence. Moonshot AI. July 16, 2026. URL: https://www.kimi.com/blog/kimi-k3.
- [62] Kimi Team. “Kimi-vl technical report”. In: arXiv preprint arXiv:2504.07491 (2025).
- [63] Kimi Team. PerceptionBench: Evaluating Atomic Visual Perception in Multimodal Large Language Models. Moonshot AI. 2026. URL: https://www.kimi.com/blog/perception-bench.
- [64] Kimi Team et al. Kimi Linear: An Expressive, Efficient Attention Architecture. 2025. arXiv: 2510.26692 [cs.CL].
- [65] Chris Lattner et al. “MLIR: Scaling Compiler Infrastructure for Domain Specific Computation”. In: 2021 IEEE/ACM International Symposium on Code Generation and Optimization (CGO). 2021, pp. 2–14. DOI: 10.1109/CGO51591.2021.9370308.
- [66] Legal Research Bench. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/legal_research.
- [67] Dmitry Lepikhin et al. “Gshard: Scaling giant models with conditional computation and automatic sharding”. In: arXiv preprint arXiv:2006.16668 (2020).
- [68] Mike Lewis et al. “BASE Layers: Simplifying Training of Large, Sparse Models”. In: Proceedings of ICML. 2021.
- [69] Huiba Li et al. “DADI: Block-Level Image Service for Agile and Elastic Application Deployment”. In: 2020 USENIX Annual Technical Conference (USENIX ATC). 2020, pp. 727–740.
- [70] Junlong Li et al. The Tool Decathlon: Benchmarking Language Agents for Diverse, Realistic, and Long-Horizon Task Execution. ICLR 2026. 2025. arXiv: 2510.25726 [cs.CL].
- [71] Yuetai Li et al. “JobBench: Aligning Agent Work With Human Will”. In: (2026). arXiv: 2605.26329 [cs.AI].
- [72] Yuhui Li et al. EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test. 2025. arXiv: 2503.01840 [cs.CL]. URL: https://arxiv.org/abs/2503.01840.
- [73] Hao Liu, Matei Zaharia, and Pieter Abbeel. “Ring Attention with Blockwise Transformers for Near-Infinite Context”. In: (2023). arXiv: 2310.01889 [cs.CL]. URL: https://arxiv.org/abs/2310.01889.
- [74] Jingyuan Liu et al. Muon is Scalable for LLM Training. 2025. arXiv: 2502.16982 [cs.LG]. URL: https://arxiv.org/abs/2502.16982.
- [75] LMArena Leaderboard. LMArena. 2026. URL: https://lmarena.ai/leaderboard.
- [76] Kevin Lu and Thinking Machines Lab. On-policy distillation. Thinking Machines Lab: Connectionism. 2025. URL: https://thinkingmachines.ai/blog/on-policy-distillation/.
- [77] Bohan Lyu et al. “MLS-Bench: A Holistic and Rigorous Assessment of AI Systems on Building Better AI”. In: (2026). arXiv: 2605.08678 [cs.LG].
- [78] Eric Martin and Chris Cundy. “Parallelizing Linear Recurrent Neural Nets Over Sequence Length”. In: Proceedings of ICLR. 2018. URL: https://openreview.net/forum?id=HyUNwulC-.
- [79] Mike A Merrill et al. “Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces”. In: arXiv preprint arXiv:2601.11868 (2026).
- [80] Maxim Milakov and Natalia Gimelshein. Online normalizer calculation for softmax. 2018. arXiv: 1805.02867 [cs.PF]. URL: https://arxiv.org/abs/1805.02867.
- [81] Nangate, Inc. Nangate 45nm Open Cell Library. https://si2.org/open-cell-library/. Version PDKv1_3_v2010_12. Donated to and distributed by the Silicon Integration Initiative (Si2). 2010. (Visited on 07/27/2026).
- [82] Deepak Narayanan et al. “Efficient large-scale language model training on gpu clusters using megatron-lm”. In: Proceedings of the international conference for high performance computing, networking, storage and analysis. 2021, pp. 1–15.
- [83] NCCL: The NVIDIA Collective Communications Library. NVIDIA. 2026. URL: https://developer.nvidia.com/nccl.
- [84] OpenAI. Introducing OpenAI o3 and o4-mini. Apr. 2025. URL: https://openai.com/index/introducing-o3-and-o4-mini/.
- [85] OpenAI. Learning to Reason with LLMs. https://openai.com/index/learning-to-reason-with-llms/. Accessed: 2026-07-23. 2024.
- [86] OpenAI Harmony Response Format. OpenAI. 2025. URL: https://github.com/openai/harmony.
- [87] OpenClaw. OpenClaw. 2026. URL: https://docs.openclaw.ai/.
- [88] Krista Opsahl-Ong et al. “OfficeQA Pro: An Enterprise Benchmark for End-to-End Grounded Reasoning”. In: (2026). arXiv: 2603.08655.
- [89] Linke Ouyang et al. OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations. 2025. arXiv: 2412.07626 [cs.CV]. URL: https://arxiv.org/abs/2412.07626.
- [90] Adam Paszke et al. PyTorch: An Imperative Style, High-Performance Deep Learning Library. 2019. arXiv: 1912.01703 [cs.LG].
- [91] Tejal Patwardhan et al. GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks. 2025. arXiv: 2510.04374 [cs.LG]. URL: https://arxiv.org/abs/2510.04374.
- [92] Bo Peng et al. RWKV-7 "Goose" with Expressive Dynamic State Evolution. 2025. arXiv: 2503.14456 [cs.CL].
- [93] Bowen Peng et al. “Yarn: Efficient context window extension of large language models”. In: arXiv preprint arXiv:2309.00071 (2023).
- [94] Long Phan et al. Humanity’s Last Exam. 2025. arXiv: 2501.14249 [cs.LG]. URL: https://arxiv.org/abs/2501.14249.
- [95] PostTrainBench. 2026. URL: https://posttrainbench.com/.
- [96] ProgramBench. Vals AI. 2026. URL: https://www.vals.ai/benchmarks/programbench.
- [97] Ruoyu Qin et al. Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving. 2024. arXiv: 2407.00079 [cs.DC].
- [98] Zhen Qin et al. HGRN2: Gated Linear RNNs with State Expansion. 2024. arXiv: 2404.07904 [cs.CL]. URL: https://arxiv.org/abs/2404.07904.
- [99] Haiquan Qiu and Quanming Yao. “Why Low-Precision Transformer Training Fails: An Analysis on Flash Attention”. In: International Conference on Learning Representations (ICLR). 2026. arXiv: 2510.04212 [cs.LG].
- [100] Zihan Qiu et al. Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free. 2025. arXiv: 2505.06708 [cs.CL].
- [101] Samyam Rajbhandari et al. “Zero: Memory optimizations toward training trillion parameter models”. In: SC20: International Conference for High Performance Computing, Networking, Storage and Analysis. IEEE. 2020, pp. 1–16.
- [102] David Rein et al. “Gpqa: A graduate-level google-proof q&a benchmark”. In: First Conference on Language Modeling. 2024.
- [103] Jonathan Roberts et al. ZeroBench: An Impossible Visual Benchmark for Contemporary Large Multimodal Models. 2025. arXiv: 2502.09696 [cs.CV]. URL: https://arxiv.org/abs/2502.09696.
- [104] Bita Darvish Rouhani et al. “Microscaling Data Formats for Deep Learning”. In: arXiv preprint arXiv:2310.10537 (2023). arXiv: 2310.10537 [cs.LG].
- [105] Alexander Samarin et al. LK Losses: Direct Acceptance Rate Optimization for Speculative Decoding. 2026. arXiv: 2602.23881 [cs.LG]. URL: https://arxiv.org/abs/2602.23881.
- [106] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. “Linear Transformers Are Secretly Fast Weight Programmers”. In: Proceedings of ICML. Ed. by Marina Meila and Tong Zhang. PMLR, 2021, pp. 9355–9366. URL: https://proceedings.mlr.press/v139/schlag21a.html.
- [107] Manasi Sharma et al. “ResearchRubrics: A Benchmark of Prompts and Rubrics For Evaluating Deep Research Agents”. In: The Fourteenth International Conference on Learning Representations. 2026. URL: https://openreview.net/forum?id=ErnvfmSX0P.
- [108] Noam Shazeer. GLU Variants Improve Transformer. 2020. arXiv: 2002.05202 [cs.LG]. URL: https://arxiv.org/abs/2002.05202.
- [109] Daniel Shepard and Robin Salimans. “AutomationBench”. In: (2026). arXiv: 2604.18934 [cs.AI].
- [110] Kean Shi et al. SaaS-Bench: Can Computer-Use Agents Leverage Real-World SaaS to Solve Professional Workflows? 2026. arXiv: 2605.15777 [cs.AI]. URL: https://arxiv.org/abs/2605.15777.
- [111] Benjamin F. Spector et al. “ThunderKittens: Simple, Fast, and Adorable Kernels”. In: The Thirteenth International Conference on Learning Representations. 2025. URL: https://openreview.net/forum?id=0fJfVOSUra.
- [112] Jianlin Su. Travels in MoE: 6. Promoting Load Balance via Optimal Assignment. Blog post (in Chinese). Feb. 2026. URL: https://spaces.ac.cn/archives/11619.
- [113] Hanchi Sun et al. Expert Threshold Routing for Autoregressive Language Modeling with Dynamic Computation Allocation and Load Balancing. 2026. arXiv: 2603.11535 [cs.AI].
- [114] Weigao Sun et al. “LASP-2: Rethinking Sequence Parallelism for Linear Attention and Its Hybrid”. In: (2025). arXiv: 2502.07563 [cs.LG]. URL: https://arxiv.org/abs/2502.07563.
- [115] Weigao Sun et al. “Linear Attention Sequence Parallelism”. In: (2024). arXiv: 2404.02882 [cs.LG]. URL: https://arxiv.org/abs/2404.02882.
- [116] Yiyou Sun et al. Agents’ Last Exam. 2026. arXiv: 2606.05405 [cs.AI]. URL: https://arxiv.org/abs/2606.05405.
- [117] Yuan Sun. Binary-Integer-Programming Based Algorithm for Expert Load Balancing in Mixture-of-Experts Models. 2025. arXiv: 2502.15451 [cs.LG].
- [118] SWE Marathon. 2026. URL: https://www.swe-marathon.org/.
- [119] Kimi Team. Kimi k1.5: Scaling Reinforcement Learning with LLMs. 2025. arXiv: 2501.12599 [cs.AI]. URL: https://arxiv.org/abs/2501.12599.
- [120] The Tool Decathlon: Benchmarking Language Agents for Diverse, Realistic, and Long-Horizon Task Execution. July 24, 2026. URL: https://toolathlon.xyz/introduction.
- [121] Thinking Machines Lab. Inkling: Our Open-Weights Model. https://thinkingmachines.ai/news/introducing-inkling/. Accessed: 2026-07-23. July 2026.
- [122] Minyang Tian et al. SciCode: A Research Coding Benchmark Curated by Scientists. 2024. arXiv: 2407.13168 [cs.AI]. URL: https://arxiv.org/abs/2407.13168.
- [123] Philippe Tillet, Hsiang-Tsung Kung, and David Cox. “Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations”. In: Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages (MAPL). 2019.
- [124] UK AI Security Institute and U.S. Center for AI Standards and Innovation. Preliminary Assessment of Kimi K3’s Cyber Capabilities. https://www.aisi.gov.uk/blog/preliminary-assessment-of-kimi-k3s-cyber-capabilities. July 2026.
- [125] Vals AI. Vals AI. 2026. URL: https://www.vals.ai/.
- [126] Ashish Vaswani et al. “Attention is All you Need”. In: Advances in NeurIPS. Ed. by I. Guyon et al. Curran Associates, Inc., 2017. URL: https://proceedings.neurips.cc/paper_files/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf.
- [127] Nikhita Vedula et al. DeepSearchQA: Bridging the Comprehensiveness Gap for Deep Research Agents. 2025. URL: https://storage.googleapis.com/deepmind-media/DeepSearchQA/DeepSearchQA_benchmark_paper.pdf.
- [128] Bertie Vidgen et al. APEX-Agents. 2026. arXiv: 2601.14242 [cs.CL].
- [129] Ke Wang et al. “Measuring Multimodal Mathematical Reasoning with MATH-Vision Dataset”. In: Advances in NeurIPS. Ed. by A. Globerson et al. Vol. 37. Curran Associates, Inc., 2024, pp. 95095–95169. DOI: 10.52202/079017-3014. URL: https://proceedings.neurips.cc/paper_files/paper/2024/file/ad0edc7d5fa1a783f063646968b7315b-Paper-Datasets_and_Benchmarks_Track.pdf.
- [130] Lei Wang et al. “TileLang: A Composable Tiled Programming Model for AI Systems”. In: arXiv preprint arXiv:2504.17577 (2025). URL: https://arxiv.org/abs/2504.17577.
- [131] Zirui Wang et al. CharXiv: Charting Gaps in Realistic Chart Understanding in Multimodal LLMs. 2024. arXiv: 2406.18521 [cs.CL]. URL: https://arxiv.org/abs/2406.18521.
- [132] Jason Wei et al. BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents. 2025. arXiv: 2504.12516 [cs.CL]. URL: https://arxiv.org/abs/2504.12516.
- [133] Xinming Wei et al. UltraEP: Unleash MoE Training and Inference on Rack-Scale Nodes with Near-Optimal Load Balancing. 2026. arXiv: 2606.04101 [cs.DC]. URL: https://arxiv.org/abs/2606.04101.
- [134] Zijian Wu et al. “MCPMark: A benchmark for stress-testing realistic and comprehensive mcp use”. In: arXiv preprint arXiv:2509.24002 (2025).
- [135] B. Xiao et al. “MiMo-V2-Flash Technical Report”. In: arXiv preprint arXiv:2601.02780 (2026).
- [136] Xiaomi MiMo Team. MiMo-V2.5-Pro. https://huggingface.co/collections/XiaomiMiMo/mimo-v25. 2026.
- [137] Tianbao Xie et al. “Introducing OSWorld-Verified”. In: xlang.ai (July 2025). URL: https://xlang.ai/blog/osworld-verified.
- [138] Zijie Yan et al. Scalable Training of Mixture-of-Experts Models with Megatron Core. 2026. arXiv: 2603.07685 [cs.DC]. URL: https://arxiv.org/abs/2603.07685.
- [139] Songlin Yang, Jan Kautz, and Ali Hatamizadeh. “Gated Delta Networks: Improving Mamba2 with Delta Rule”. In: Proceedings of ICLR. 2025. URL: https://openreview.net/forum?id=r8H7xhYPwz.
- [140] Songlin Yang and Yu Zhang. FLA: A Triton-Based Library for Hardware-Efficient Implementations of Linear Attention Mechanism. Jan. 2024. URL: https://github.com/fla-org/flash-linear-attention.
- [141] Songlin Yang et al. “Gated Linear Attention Transformers with Hardware-Efficient Training”. In: Proceedings of ICML. PMLR, 2024.
- [142] Songlin Yang et al. “Parallelizing Linear Transformers with the Delta Rule over Sequence Length”. In: Proceedings of NeurIPS. 2024.
- [143] Yaoyu Wang. Context Parallelism for DeltaNet. 2025. URL: https://yywangcs.notion.site/DeltaNet-2a9fc9f5d8058013a498f34e0b25bd52.
- [144] Mengqi Yuan et al. OSWorld2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks. 2026. arXiv: 2606.29537 [cs.AI]. URL: https://arxiv.org/abs/2606.29537.
- [145] Xiang Yue et al. MMMU-Pro: A More Robust Multi-discipline Multimodal Understanding Benchmark. 2024. arXiv: 2409.02813 [cs.CL]. URL: https://arxiv.org/abs/2409.02813.
- [146] Aohan Zeng et al. GLM-5: from Vibe Coding to Agentic Engineering. 2026. arXiv: 2602.15763 [cs.LG]. URL: https://arxiv.org/abs/2602.15763.
- [147] Biao Zhang and Rico Sennrich. “Root mean square layer normalization”. In: Advances in NeurIPS 32 (2019).
- [148] Chenggang Zhao et al. DeepEP: an efficient expert-parallel communication library. https://github.com/deepseek-ai/DeepEP. 2025.
- [149] Yilun Zhao et al. “MMVU: Measuring Expert-Level Multi-Discipline Video Understanding”. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). June 2025, pp. 8475–8489.
- [150] Runjie Zhou et al. WorldVQA: Measuring Atomic World Knowledge in Multimodal Large Language Models. 2026. arXiv: 2602.02537 [cs.CV]. URL: https://arxiv.org/abs/2602.02537.
- [151] Jian Zhu et al. “SpreadsheetBench 2: Evaluating Agents on End-to-End Business Spreadsheet Workflows”. In: (2026). arXiv: 2606.29955 [cs.SE].
Footnotes
-
该构造基于 DeltaNet 上下文并行 [143]。KDA 实现见 FLA PR #691。 ↩
-
AgentENV 已开源:https://github.com/kvcache-ai/AgentENV ↩