Pi:极简,且更强
Databricks 与 Shopify 的实测证明:只有 4 个工具、不到 1,000 token 系统提示词的 Pi,是更便宜也更强的编码智能体脚手架。
Pi 的极简主义正是它的优势
AI 让代码变便宜了,于是许多公司开始打造更庞大的工具来追求更好的性能:更长的提示词、更多的编排、更多的层级、更复杂的结构。这也让这些工具的使用成本天然地水涨船高。Pi 走的是完全相反的路。
Pi 是一个刻意选择极简主义的编码脚手架(coding harness)。它开箱只有 4 个工具,系统提示词加上工具定义总共不到 1,000 个 token。背后的理念是:大多数工作靠基本功就能完成,如果你需要更多,那就自己去构建。
越来越多的证据表明,Pi 的设计不只是更干净——它更便宜,而且性能更强。用户们发现,不加任何扩展的原版 Pi 就能跑出业界领先的结果;而在叠加扩展以匹配特定工作流之前,它已经如此。从下面 Databricks 和 Shopify 的两个案例中我们会看到,Pi 为两者都带来了理想的结果。
案例研究
Databricks 的研究:单任务成本
Databricks 最近分享了他们的发现:《在 Databricks 数百万行代码库上给编程智能体做基准测试》。这项研究的目标,是弄清楚哪些编程智能体在真实世界的编码任务上表现最好,以及任务表现如何随价格变化。
为了避免那些已经过度饱和的外部基准测试带来的偏差,他们基于自己工程师团队的日常任务自建了基准。结果符合我们的预期,但可能会让业内不少人大跌眼镜。用他们自己的话说:“……模型被调用时所用的脚手架,对成本和质量都有巨大影响”,以及“在我们的工作负载上,很多情况下恰恰是 Pi 这样的简单脚手架表现最好”。
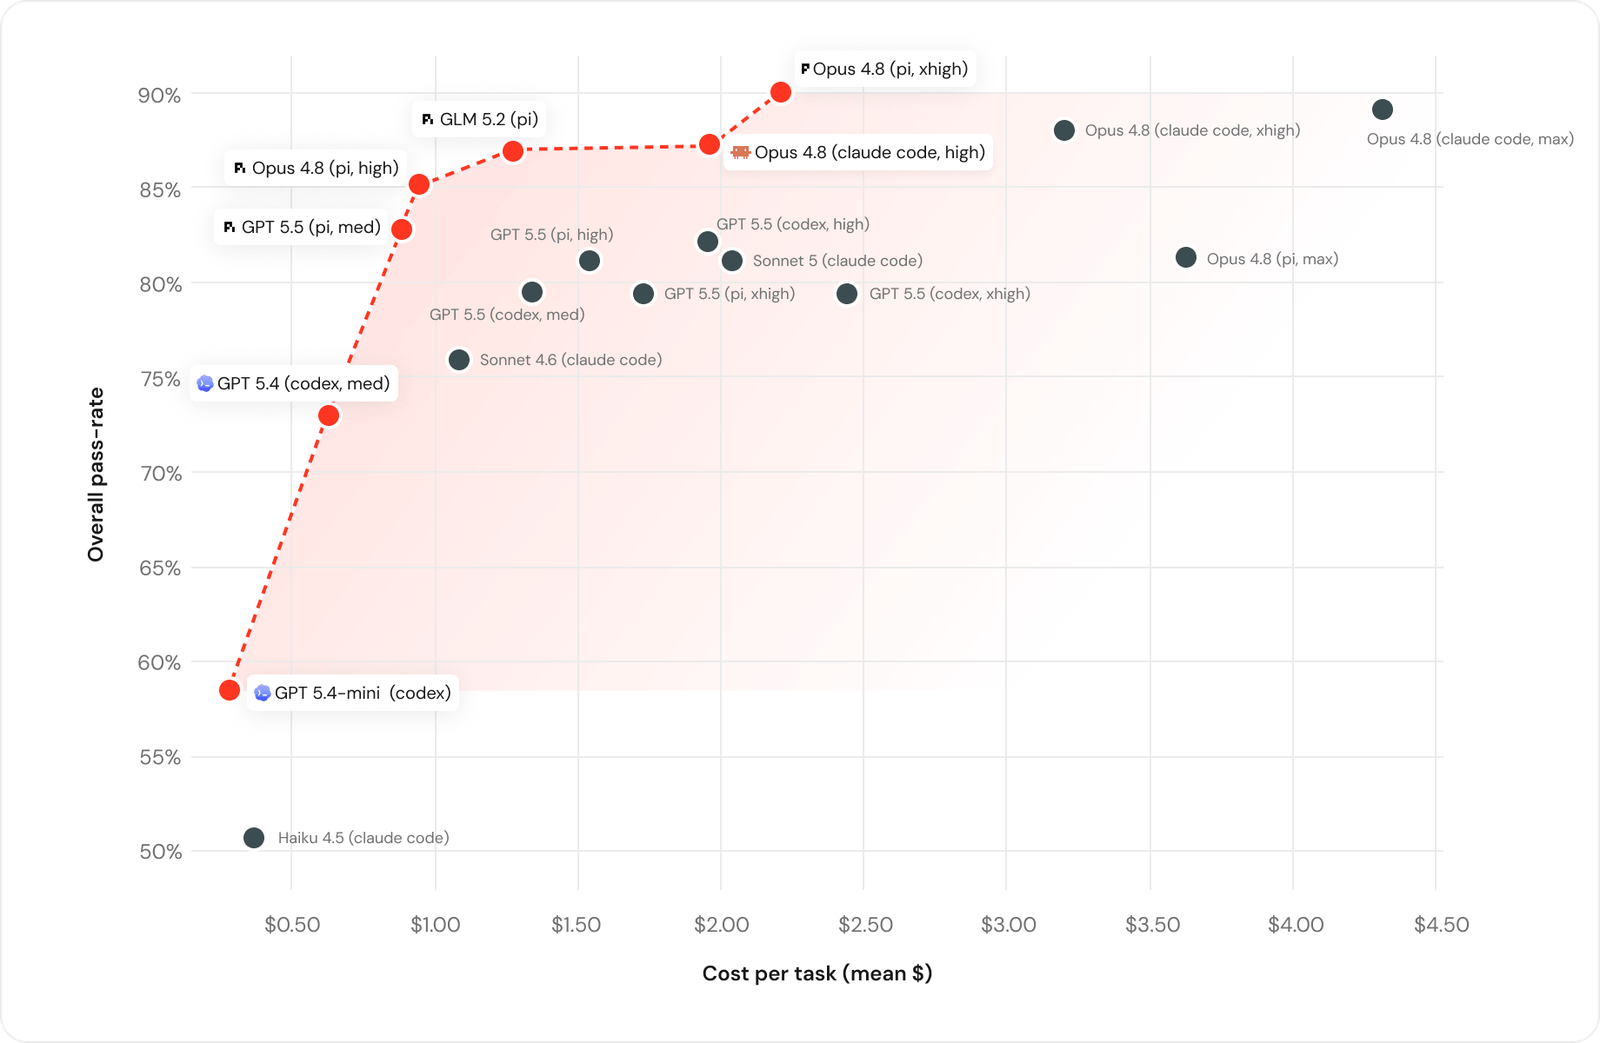
图表由 Databricks 制作。
当 Pi 与 Opus 4.8(xhigh 档位)组合时,整体通过率最高,而成本显著低于 Claude Code 和 Codex。
极简脚手架,可测量的效果
Pi 之所以出色,是因为它不会拿一堆默认设定和指令把模型层层包裹——那些东西只会在指令层级中丢失。相反,Pi 不挡模型的路,让团队得以添加他们工作流真正需要的东西。
Databricks 这项研究的洞见在于,它把模型和脚手架分开了评估。
他们报告说,当以相同的思考强度、通过不同脚手架运行同一个模型时,“单任务成本差异显著(某些情况下超过 2 倍),而质量保持不变”。我们把这称为 Pi 的“上下文纪律”(context discipline)。“Pi 每轮发送的上下文大约少 3 倍。它对上下文的管理更好,保持更紧凑的工作集,用更少的轮次完成任务。”
我们认同一点:必须考量端到端的工程经济学,而不能只看每个 token 的单价。在模型层面也是如此——比如我们观察到,在 Haiku 4.5 上跑复杂工作流,往往比在 Sonnet 4.6 上更贵,尤其是在涉及代码执行时,原因很简单:智能体需要更多轮次才能成功完成任务。
现在我们看到,这一点在脚手架层面同样成立:更强、更贵的模型配上一个高性能脚手架,反而可能比反过来更便宜。
Shopify 构建 Pi Autoresearch:可扩展性战胜臃肿
极简主义是 Pi 核心哲学的一部分。而让它成立的关键在于:极简不等于不灵活。事实上,Pi 是第一个为可扩展性和自我可编辑性而生、并被广泛使用的智能体基础设施。
另一个对 Pi 设计的有力外部验证来自 Shopify。在 Shopify 工程博客的这篇文章中,David Cortés 描述了如何直接把 pi-autoresearch 构建为一个 Pi 扩展——只需要对 Pi 说“Pi,为 Autoresearch 创建一个扩展……”。Pi 会阅读它自己的扩展文档,然后从那里开始构建一个全新的工作流。
Autoresearch 是一个用编程智能体做优化的自治循环。当你提出一个修改需求,它会运行实验来验证什么有效、什么会造成回退。只要目标是可测量的,它就能丢弃这些回退、持续自我改进。
对 Shopify 以及其他公司来说,Autoresearch 扩展很快就成了一个正经的内部生产力工具。Shopify 报告的案例包括:单元测试运行“快了 300 倍”、React 组件挂载“快了 20%”、多个项目的构建时间缩短,甚至连 pnpm 的性能都得到了改善。

图片来自 Shopify 的 pi-autoresearch GitHub 仓库。
这里的重点在于:Pi 开箱并不自带这些工具中的任何一个。它做的是让你自己构建它们变得简单到离谱。Pi 不假设厂商比你更懂你的工作流、然后试图把天底下所有工具都塞给你;相反,它假设你最懂你自己,并把可扩展性作为礼物交到你手上,由你亲手打造自己的工作流。
为什么现在是极简胜出
大约一年前,你还可以论证原生脚手架(native harness)相比其他脚手架有结构性优势——因为模型当初就是围绕它们构建的。然而,这个论证正在变得越来越站不住脚。
如今的前沿模型普遍已经非常擅长理解终端(或类终端)编码环境并在其中行动。Anthropic 最近把 Claude Code 的系统提示词砍掉了 80% 就是一个明显的信号。所以问题的关键正在从“脚手架有多原生”,转向“脚手架如何处理上下文、避免冗余,并用干净的原语(primitives)行动”。模型需要的是一个通往环境的干净接口,和一个不浪费上下文的脚手架。
Pi 提供的正是这个:更少的提示词开销和重复上下文、更低的运行成本、更少的非必要抽象。因为它可扩展,你并没有牺牲能力,而是获得了选择权——只有当复杂性“证明自己值得”时,你才引入它。
我们还看到本地模型正在快速发展,在 Earendil 我们认为它们非常有前途。Pi 的上下文纪律在这里尤其宝贵:本地模型的上下文窗口通常更小,预填充(prefill)可能耗时很长,因此保持一个稳定的提示词前缀至关重要。上下文纪律意味着:未经用户明确要求,我们绝不改变上下文,从而避免动辄以分钟计的重新预填充。结合极简的默认系统提示词和工具集,Pi 成为本地模型的理想脚手架。
Pi 正在证明,这一切它可以兼得:更便宜、更极简,也更强。