Prime Agent:一个自我改进的 RLM 智能体
Prime Intellect 发布 Prime Agent:以递归语言模型(RLM)与持续进化脚手架两大抽象打造的自我改进编码智能体,ARC-AGI 3 超越人类专家基线。
今天,我们正式发布 Prime Agent——我们围绕两大抽象构建的自我改进编码脚手架(coding harness):递归语言模型(Recursive Language Model,RLM)[citation] 和持续进化脚手架(Continual Harness)[citation]。
现代脚手架的设计围绕的是前几代模型的能力,并不能反映当今前沿模型(frontier model)的真实水平:固定的工具调用 schema 和上下文压缩(context compaction)机制,迫使模型绕开自己的脚手架工作,而不是借力于它。静态的、手工设计的子智能体、提示词、技能和记忆在设计时一次性定死,从不随智能体在运行中学到的东西而调整。我们相信,脚手架应当在当前模型能力的基础上向前外推,指向下一代推理模式的前沿。
Prime Agent 正是围绕这一原则构建的,包含两大核心抽象:
- 递归语言模型(RLM) 将上下文视为变量,将子智能体委派视为 REPL 中的函数调用。持久化的 REPL 让模型可以以编程方式访问自己的历史、子智能体和工具,从而编写“语言模型程序”——即作用于自身上下文之上的动作。这一设计让智能体可以处理任意长度的会话,而不会丢失存储在变量中的历史信息。
- 持续进化脚手架(Continual Harness) 将脚手架自身的状态——抽象为提示词、技能、记忆和子智能体——视为智能体可以从自身轨迹中创建、读取、更新和删除(CRUD)的对象。结合智能体间(agent-to-agent)通信,这一机制实现了跨子智能体乃至跨 Prime Agent 会话的编排(orchestration)。例如,Prime Agent 可以派生持久子智能体,在之后的轨迹中向它们发送消息,还可以直接与另一个 Prime Agent 会话通信。
这些抽象对引导(bootstrapping)模型能力非常强大。Prime Agent 既是一个高效的通用编程助手,也是长时程自主评测的默认运行时,还是研究与自动化研究(autoresearch)的协作者。
Prime Agent 完全开源,可通过以下方式安装:
curl -fsSL https://app.primeintellect.ai/prime-agent/install.sh | sh
Prime Agent 入门引导启动界面
Prime Agent
智能体脚手架的性能既取决于脚手架的设计,也取决于围绕脚手架训练的模型能力。我们设计 Prime Agent 时,让它既能立即搭配现代开放与闭源前沿模型使用,也提供了一套特性集——我们预期,随着围绕它训练的新一代模型出现,这些特性将带来进一步的性能提升。
Prime Agent 的核心设计是程序化的工具与子智能体调用。在 Prime Agent 中,模型唯一的工具就是一个持久的 IPython 内核(IPython kernel)。其他标准的脚手架功能——包括子智能体(每个子智能体本身就是另一个 prime-agent 实例)——都作为内核中的函数来调用。
Prime Agent 的架构
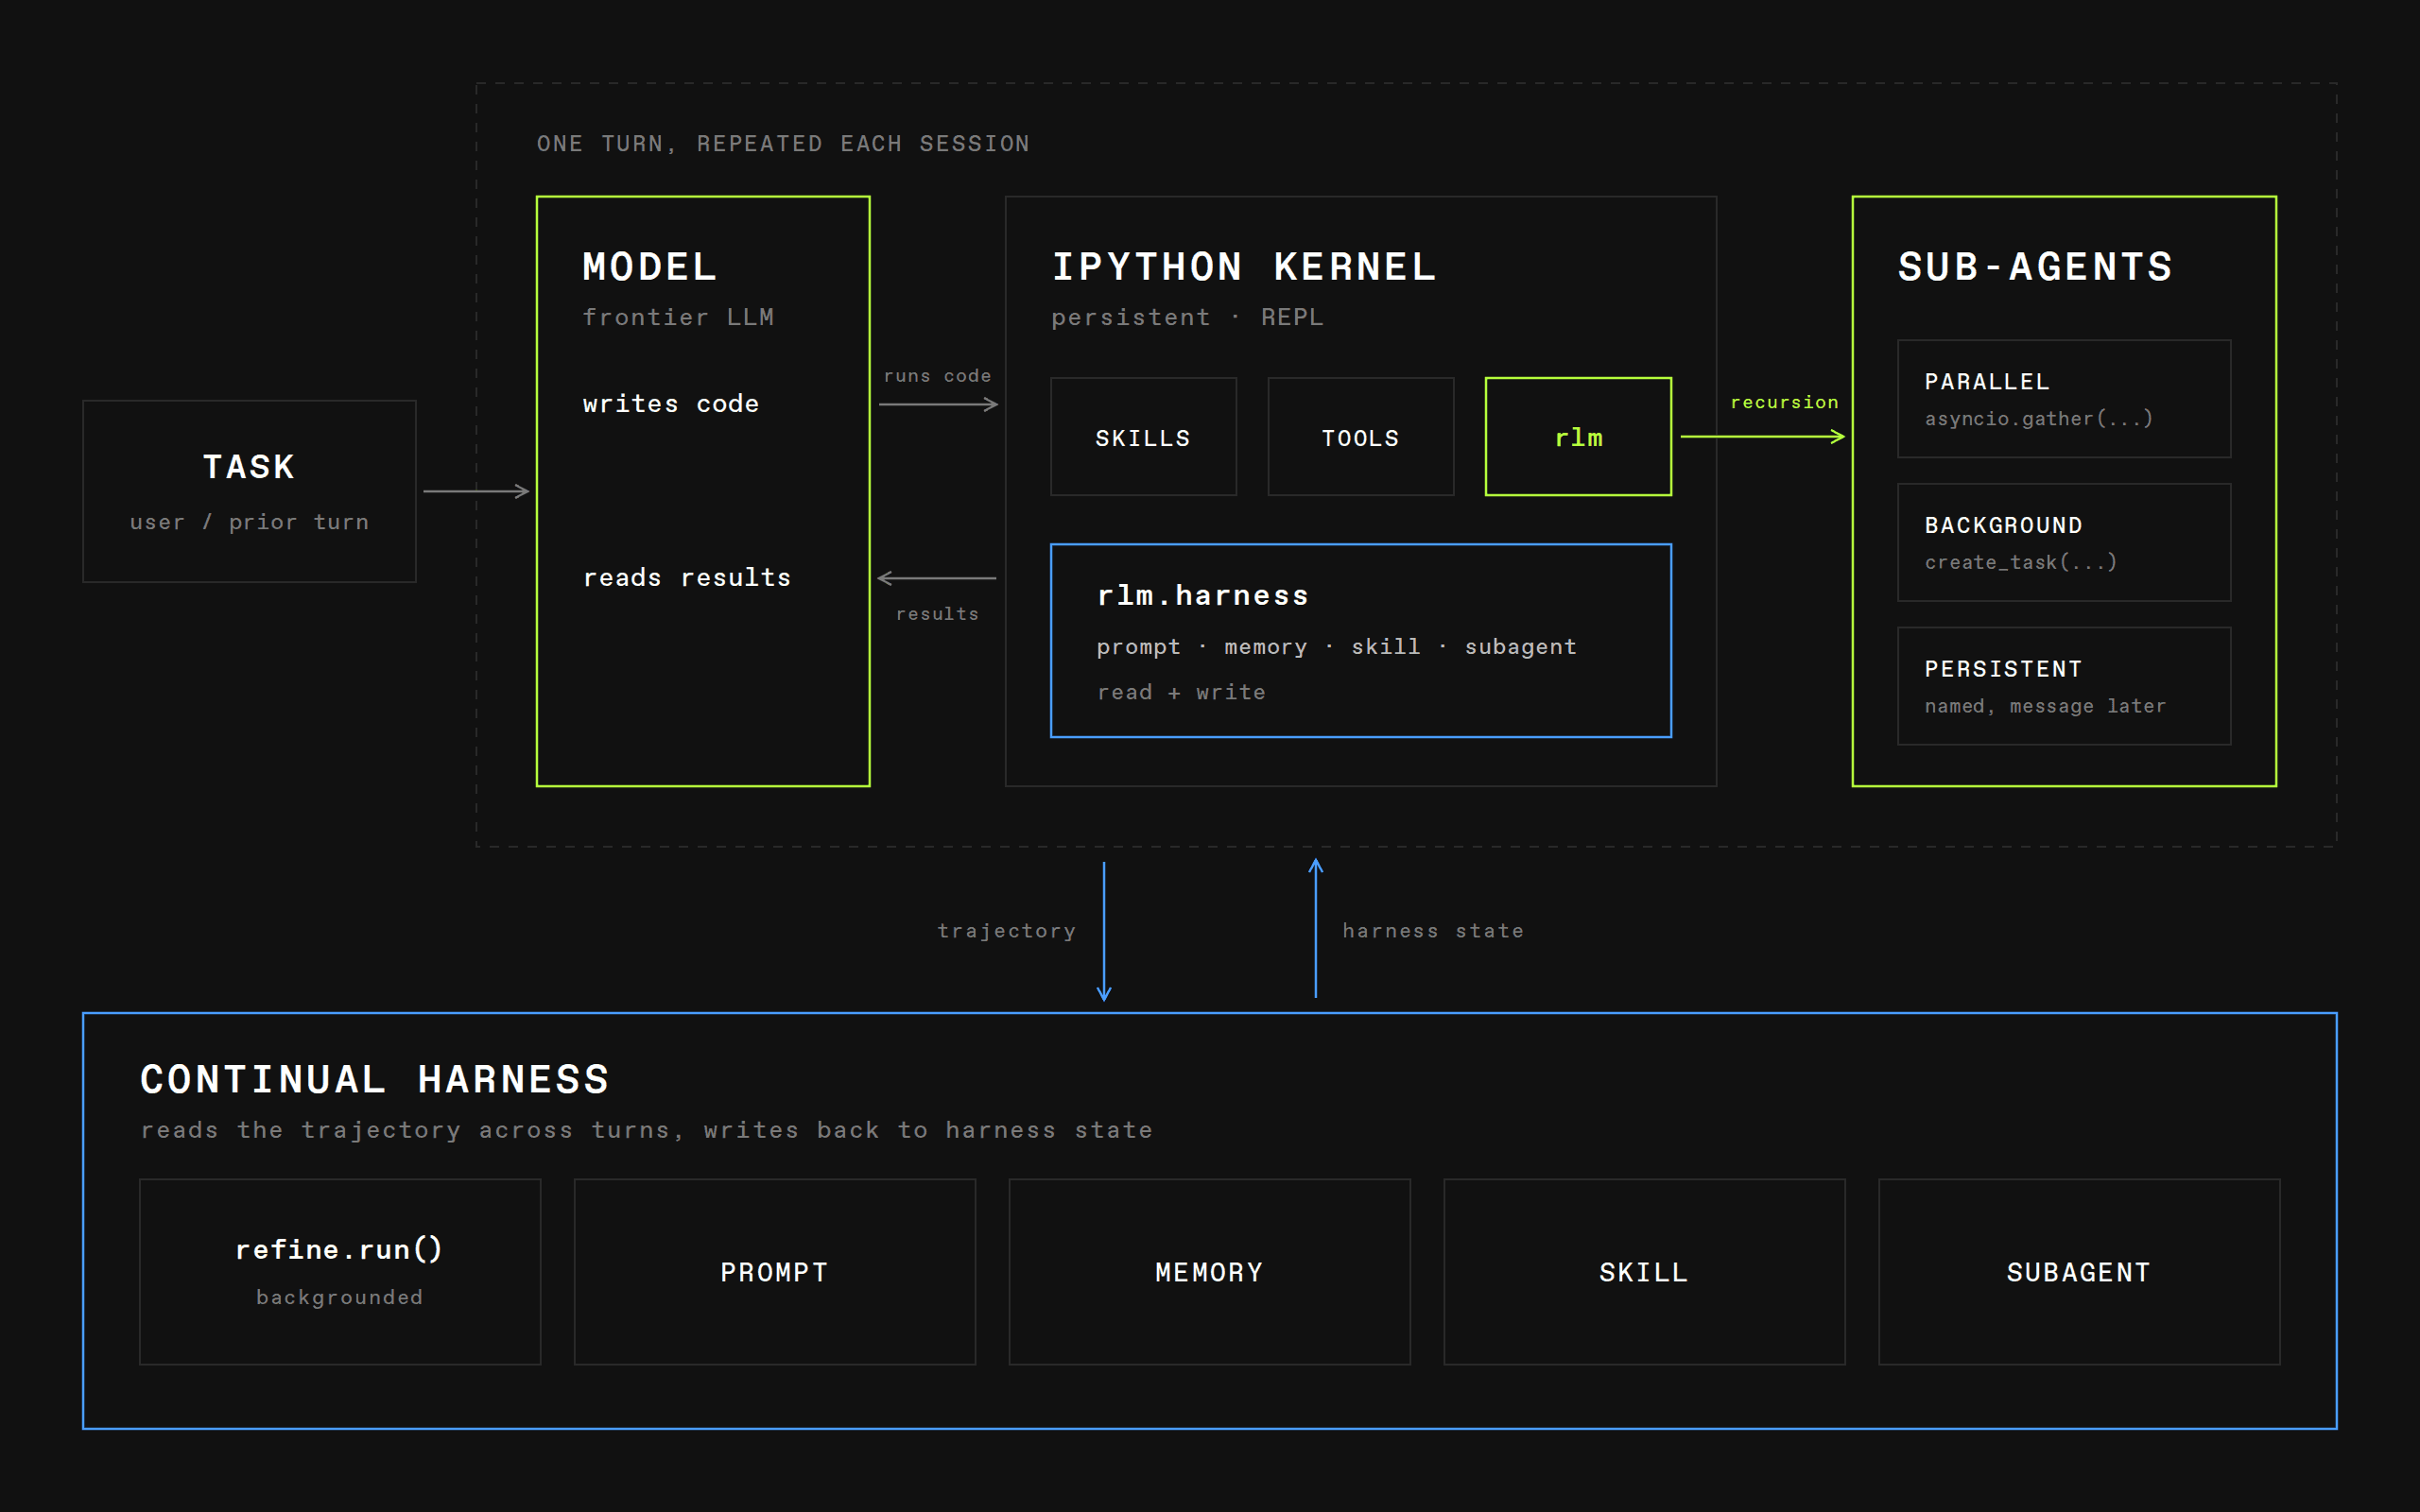
RLM 与持续进化脚手架是两大核心抽象;子智能体 CRUD 加上 Agent2Agent 消息传递,将它们组合成编排能力。
后台守护进程与智能体视图(Agents View)。 默认视图是一个与其他编码智能体脚手架类似的文本用户界面(TUI)。默认情况下,智能体执行的 IPython 动作会被折叠以保持简洁,但可以展开查看脚手架执行的动作。在 REPL 中启动的子智能体,也可以在用户输入框下方访问。
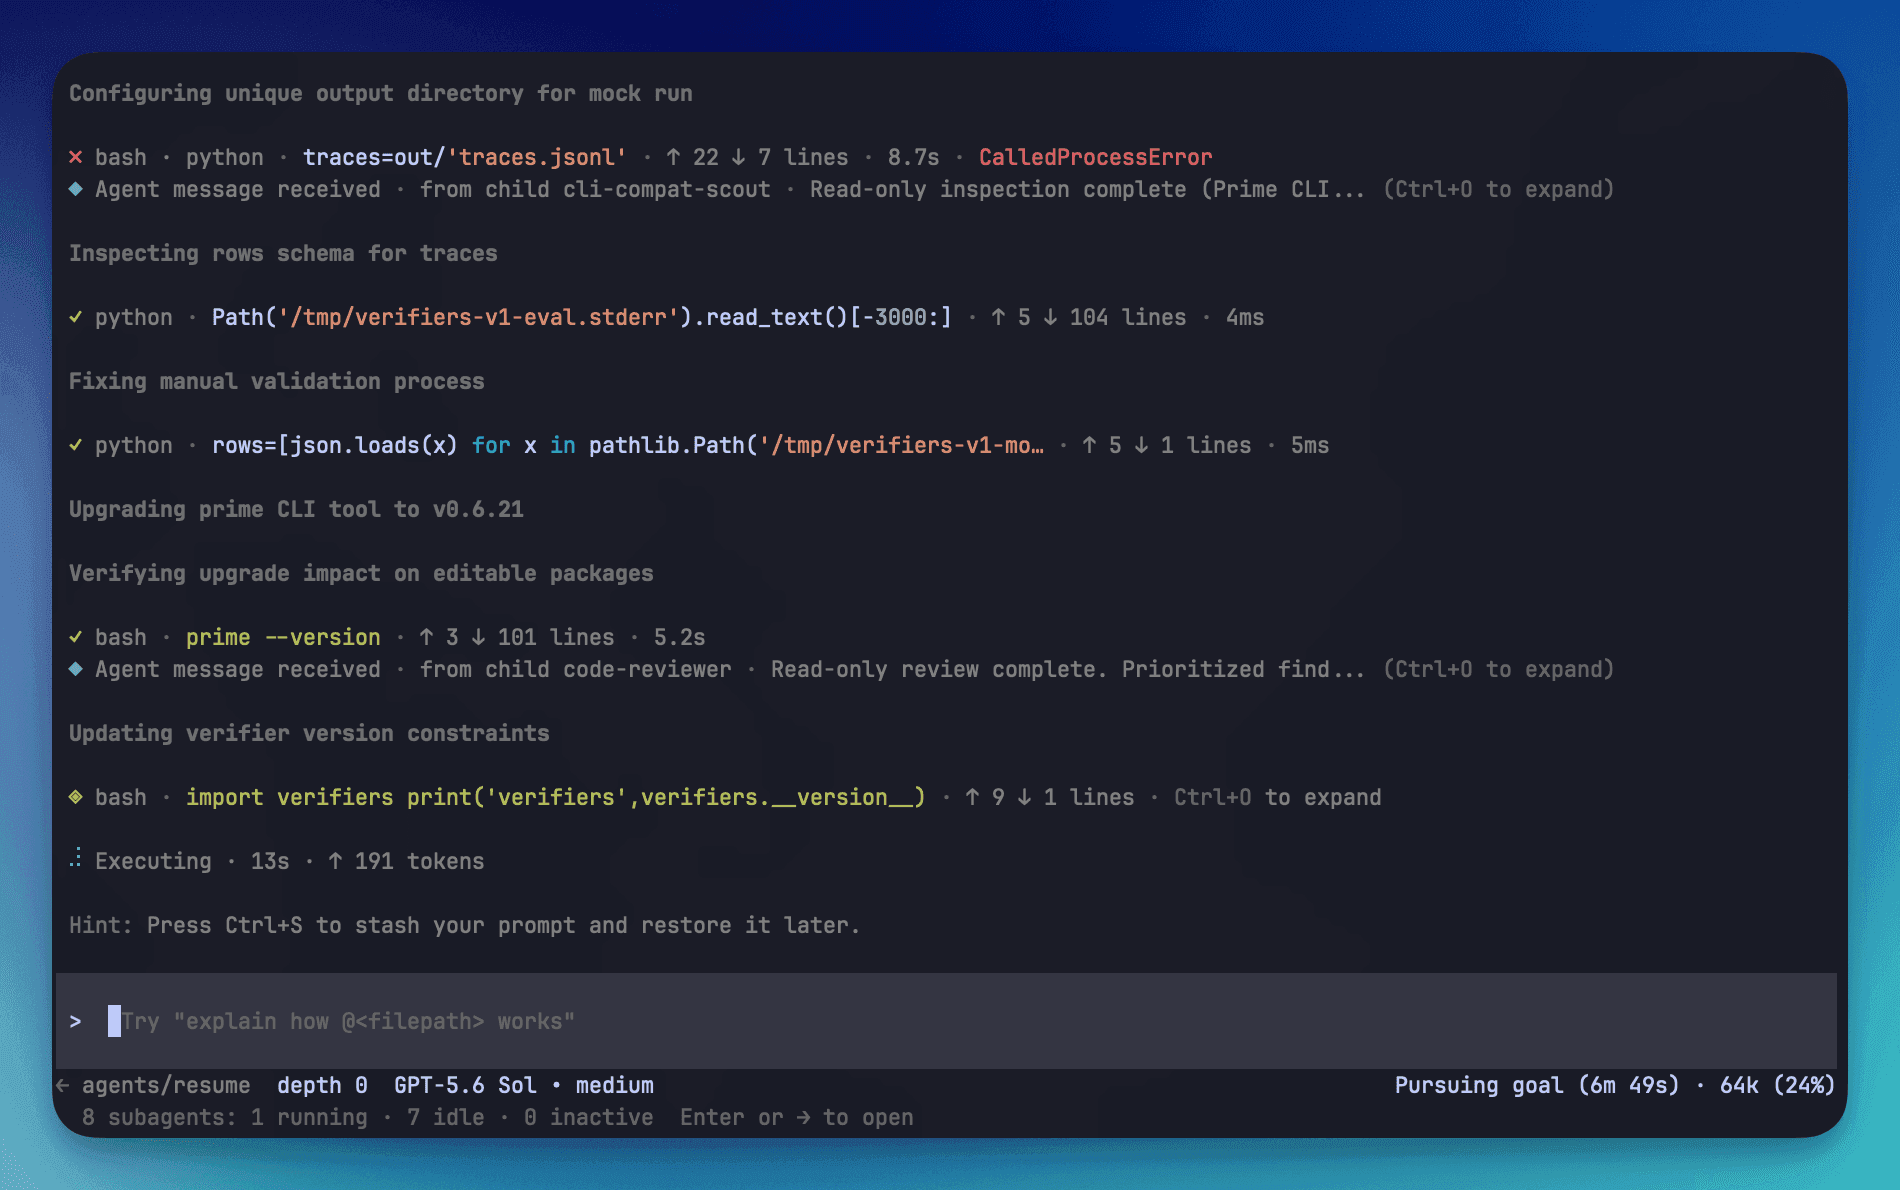
Prime Agent 文本用户界面
Prime Agent 运行一个后台守护进程,通过本地 socket 管理所有存活的智能体会话。你可以随时附着(attach)或脱离(detach)会话,而不影响底层的智能体循环。每个根会话树运行在可恢复的 worker 进程中;如果 worker 崩溃,守护进程会从会话 JSONL 和内核状态快照中恢复它。
智能体视图让你查看并选择守护进程中其他存活的会话。在空提示符下按左方向键(←)即可打开,其中列出正在运行的会话、守护进程仍激活的空闲会话,以及当前未加载到内存的非活跃会话。这些会话都可以立即进入并交互;按下空格键,用户可以与任意状态的会话对话,包括引导(steering)会话、排队提示词,以及 /compact 等命令。
智能体视图被设计为智能体与子智能体之间递归连接的枢纽:任何智能体都可以在智能体视图里被发现。用户从智能体视图进入某个智能体的对话,再进入其子智能体的智能体视图,再进入某个子智能体的对话,依此类推。
由于子智能体与根智能体共享同一套“运行中—空闲—非活跃”状态机,它们在 30 分钟无活动后可以从内存中移除;一旦有用户或智能体向它们发消息,它们会立刻从磁盘重新加载。在嵌套层级很深的对话中,这可以节省大量内存。
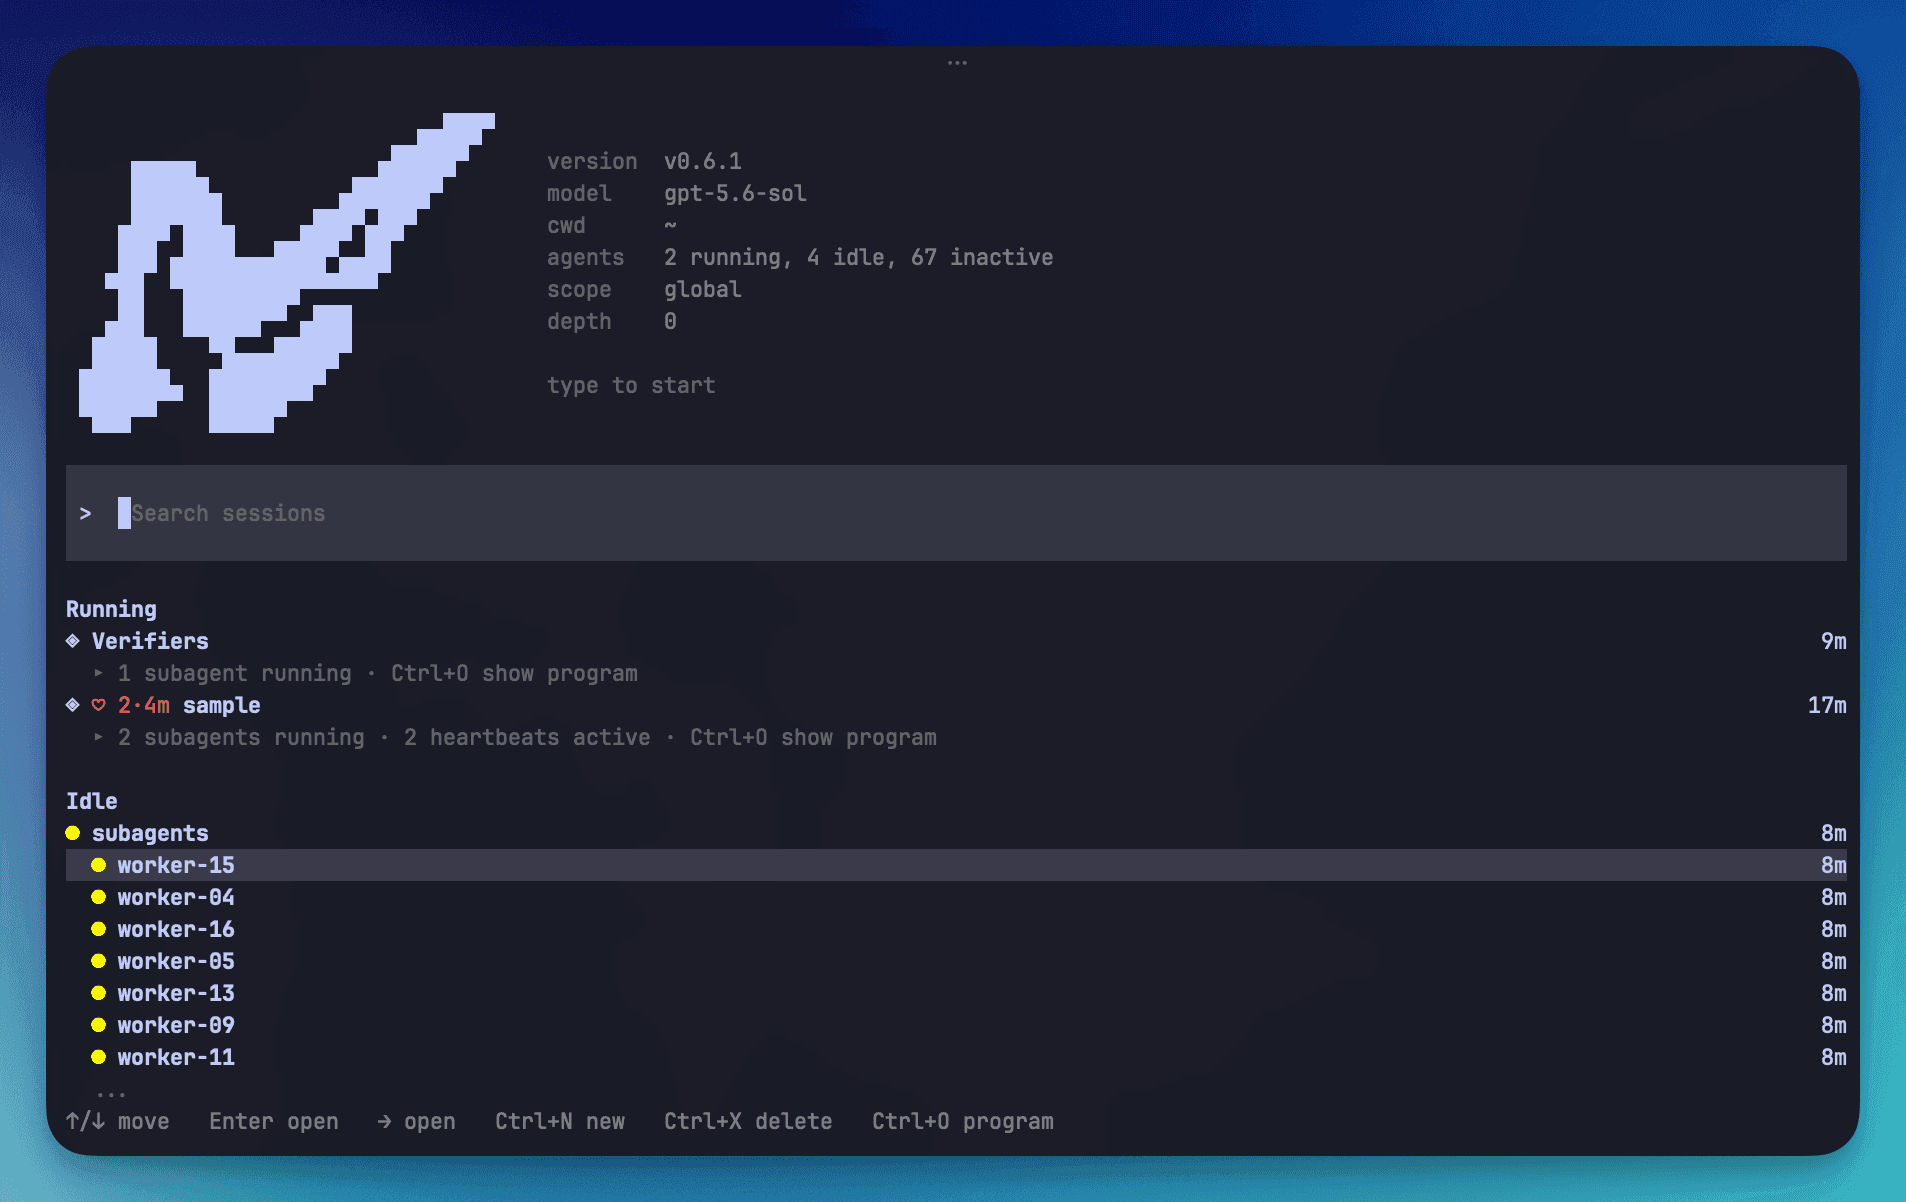
Prime Agent 智能体视图,列出运行中、空闲和非活跃会话
会话与上下文管理。 智能体的完整会话历史以仅追加(append-only)的 JSONL 文件存储在磁盘上。每一行是一条 JSON 记录,可以包含消息、模型切换、压缩摘要或扩展条目。分支、fork 和克隆都通过移动叶指针在同一个文件内完成。完整历史始终可以通过 /tree 恢复。
上下文压缩在上下文触及阈值时触发,也可以由智能体在 REPL 中通过 compact.run() 直接触发。压缩主要用于清理智能体的主上下文,但完整历史(包括过往的压缩记录)在需要时都可以在 IPython 内核中以编程方式访问。
REPL 的引入需要额外的工作来管理 IPython 状态。我们异步地对内核进行压缩和清理,并派生一个智能体充当垃圾回收器。这是必要的,可以避免每个智能体的 REPL 内存不断堆积。
RLM 与程序化工具调用(PTC)
Prime Agent 依赖 IPython 内核作为跨会话持久的 REPL,每一轮都可以调用它。初始化时,内核会将每个技能/工具预导入为模块,其中包括用于递归式程序化子智能体调用的 rlm。
rlm 是一个异步函数,这意味着模型可以在代码中自由调用并并行化子智能体调用。派生一个子智能体(例如 await rlm("sub-task"))会启动一个拥有自己模型、IPython 内核、会话树和对话历史的完整会话。它会立即返回,因为智能体之间后续的所有通信都通过 agent_message.send(...) 工具进行。
Prime Agent 可以通过这种方式启动多种有用的原语,例如并行扇出子智能体,或启动后台工作。
# Parallel fan-out — rlm() returns at task admission with a child handle,
# never the child's answer; results arrive as agent_message replies.
auth = await rlm("Summarize the authentication flow in auth/. Reply to me when done.", name="auth-expert")
api = await rlm("Summarize the updated HTTP API layer in src/. Reply to me when done.", name="http-expert")
# ... continue independent work; each child replies via
# agent_message.send(..., receiver_role="parent") when finished ...

# Steer or extend a child mid-flight by role + name
await agent_message.send(
    "Also cover middleware error handling.",
    receiver_role="child",
    receiver_name=api.name,
)
随着模型持续进步,围绕工具调用和子智能体的新调用模式将不断涌现。我们预期,未来的模型将更少依赖“手把手”的提示词,更多依赖这种直接的程序化控制。
编排与多智能体通信
后台守护进程管理所有存活的 Prime Agent 会话。Prime Agent 还通过守护进程实现了智能体间(Agent-to-Agent,A2A)消息传递:任何 Prime Agent 会话都可以使用与持久子智能体通信相同的机制,向其他任意 Prime Agent 会话发送消息。这让编排变得容易——既可以管理子智能体群的进度,也可以让相关智能体之间直接就共享资源进行沟通。为防止独立会话之间出现不期望的通信,Prime Agent 的多智能体通信仅限于其“核心家庭”(nuclear family),即父进程、兄弟进程或子进程。
# Spawn a named child; the handle returns at admission.
handle = await rlm("Find what's wrong in this auth-flow. Reply to me with your findings.", name="auth-reviewer")
# ... the child's findings arrive as a parent-role reply, not a return value ...

# Later (survives compaction and kernel restarts): recover the retained child.
children = await rlm.list_subagents()
auth_child = next(c for c in children if c.session_name == "auth-reviewer")

# Send a follow-up turn into the same retained child session.
await agent_message.send(
    "Follow up: identify the main edge cases and any likely bugs.",
    receiver_role="child",
    receiver_name=auth_child.session_name,
    mode="follow_up",
)
Prime Agent 通过其 RLM 原生的运行时支持持久子智能体:即使最初的子智能体调用已经结束,子智能体自己的会话目录、上下文、IPython 内核和会话历史仍然保留。Prime Agent 可以通过其唯一的会话标识符向持久子智能体发送后续消息以延续它,这一切都从它的 IPython 内核中完成。
通过持续进化脚手架实现自我改进
Prime Agent 的脚手架状态以 rlm.harness 的形式存在于持久 IPython 内核中,智能体在任务执行中可以立即读取和调用它;每一次变更也会写入磁盘,因此可以跨轮次、跨会话保留。持续进化脚手架将这个状态形式化为 ,即提示词、子智能体、技能和记忆,并从智能体自身的轨迹中在线精炼(refine),无需重置。
四个组件都暴露同一套创建、读取、更新、删除接口。create_prompt_note(...)、create_memory(...)、create_skill(...) 和 create_subagent(...) 各自添加对应类型的条目,update_X(...) 和 delete_X(...) 与之对应,list(kind) 或 get(kind, id) 用于读回。技能也遵循同一接口:编写一个由 Python 支撑的技能,就是一次携带 SKILL.md 式引用的 create_skill(...) 调用,与添加一条记忆或一条提示笔记是同一类操作。
# Create a memory and a skill through the same CRUD surface
rlm.harness.create_memory("flaky test pattern", "retry three times before failing")
rlm.harness.create_skill("retry helper", "...", reference={"type": "python", "import": "retry_helper"})

# Read them back
rlm.harness.list("memory")
rlm.harness.get("skill", "retry_helper")
/refine 是构建在这套 CRUD 接口之上的自我改进流水线。它读取智能体自身的轨迹——尝试了什么、发生了什么——然后施加最小相关的 CRUD 修改,让脚手架向更好的结果演化:更新一条提示笔记、一条记忆、一个技能或一个子智能体规格,而不是重写整个脚手架。每次精炼都会记录其触发原因及产生的结果,因此改进是有证据支撑的,而非任意的。
精炼分两个阶段运行。规划阶段——提出修改的 LLM 调用——在后台运行,不阻塞正在进行的对话。应用阶段——写入磁盘并重建系统提示词——非常快,只在下一个轮次边界短暂阻塞。当智能体注意到反复出现的失败或可复用的策略时,可以随时直接调用 refine.run(),而不必等待固定的时间表。
# Schedule a refinement focused on a specific observation
await refine.run("promote the retry-on-flaky-test pattern to a skill")

# Both status calls follow the same shape, though refine's plan/apply split
# means "in_flight" can mean either background planning or the fast apply step
await compact.status()   # tokens, context_window, percent, scheduled
await refine.status() # pending, in_flight基础系统提示词保持不可变,/refine 只修改它周围的脚手架层。系统支持通过过往精炼历史回滚,一次糟糕的脚手架更新可以按 ID 撤销。
面向评测的自主模式
Prime Agent 的评测模式结合了三种互补机制。**目标(goal)**设定总体任务:一个持久的、带可选 token 预算的目标,脚手架会跨轮次不断重新提示智能体去追求它,直到智能体显式调用 goal.complete()。**心跳(heartbeat)**是按固定间隔注入会话的 cron 式定时消息,用于定期检查,例如监控子智能体进度或轮询训练更新。
**自主模式(autonomous mode)**则是持续机制本身:当一轮没有产生进一步输出时,它确保智能体继续朝目标工作,而不是提前停止。三者结合,让会话可以长时间无人值守运行,同时受显式预算约束,并可通过智能体视图检查。
自主模式可以直接通过 CLI 的 --autonomous 启用,无需编写脚本。一条命令即可同时设定完成目标和轮次上限:
prime-agent \
  --autonomous \
  --autonomous-gate "npm run check" \
\
  "Implement and verify the requested change"
门控(gate)命令在会话被允许结束前运行。门控失败时,其截断后的输出会返回给智能体以再次尝试;如果自上次尝试以来工作区没有变化,Prime Agent 会跳过重跑失败的门控。--autonomous-max-turns、--autonomous-max-tokens 和 --autonomous-timeout-ms 分别限制持续轮次、token 数和墙上时钟时间。
评估 Prime Agent
Prime Agent 既是一个可用的编码智能体,也是一种可供研究评估的脚手架设计。需要特别指出的是:虽然许多现代前沿模型是围绕某个特定脚手架训练的,但目前还没有任何模型围绕 Prime Agent 或其核心特性集训练过。
ARC-AGI 3。 ARC-AGI 3 是一个流行的智能基准,衡量智能体进行符号推理以及学习模拟世界规则的能力。我们在自主模式下用多个不同的前沿模型评估 Prime Agent,并与它们各自的原生脚手架对比。Prime Agent 是作为 CLI 编码智能体开发的,因此针对 ARC-AGI 3 的唯一改动是任务提示词,其灵感来自 PRO-LONG 使用的标准提示词设置。
我们的最佳结果是在 Prime Agent 中使用 Opus 5,取得 95.5% 的 RHAE Best@1,超过了 ARC 官方报告的 95.4% 人类专家基线。在三次运行中,Prime Agent 的表现稳定优异 [95.0, 95.2, 95.5],Best@3 达 99.97%,183/183 个关卡全部完成。我们 ARC-AGI-3 的中位计分卡动作回放(95.2%)可以在这里查看。
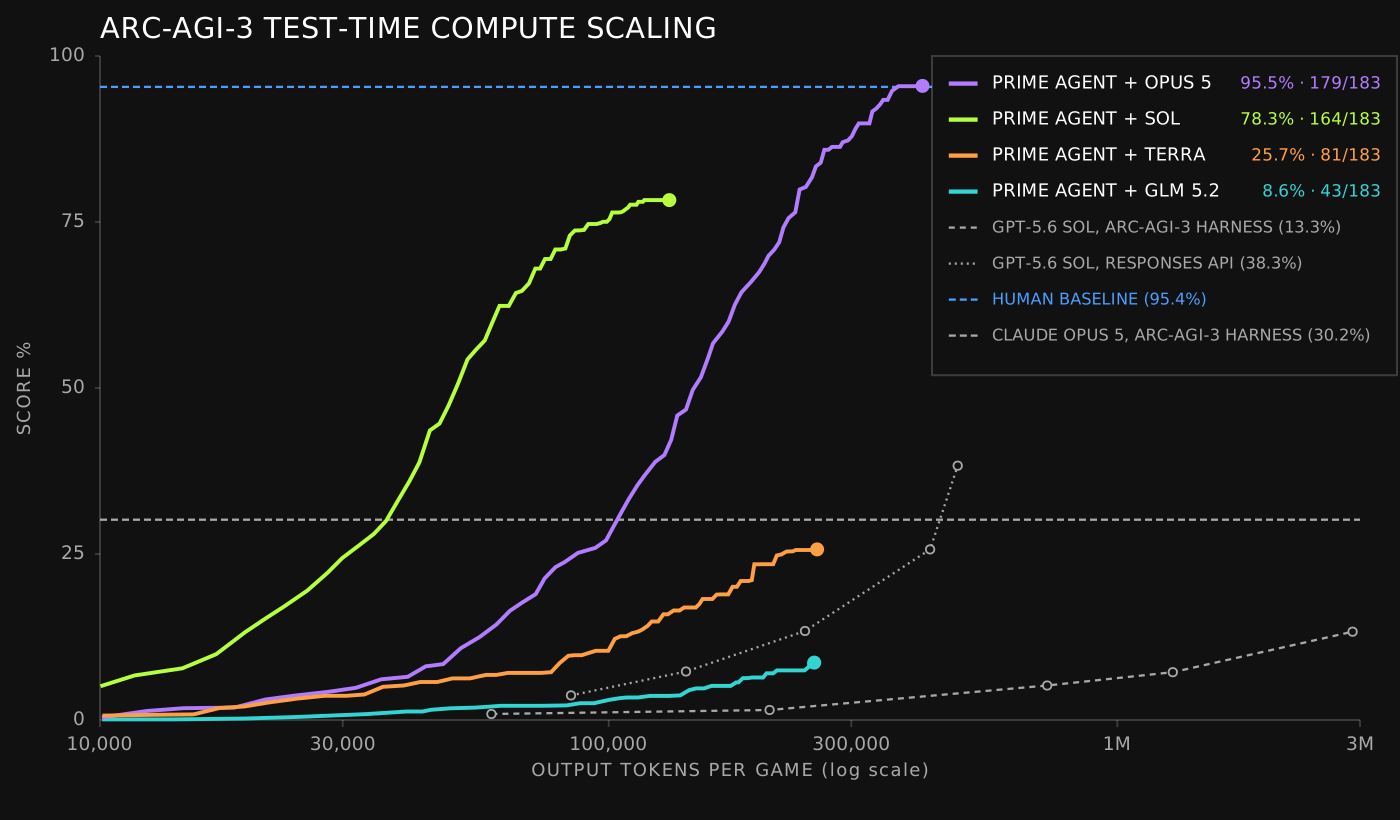
ARC-AGI-3:(左)测试时算力(test-time compute)扩展:得分与每局输出 token 数的关系。(右)成本扩展:得分与预估 API 成本的关系。
除了在每个模型的原生脚手架之上取得更高的最高分,我们还发现 Prime Agent 的总体 token 消耗更低。Prime Agent 节省 token 的方式,是以编程方式对数据运行函数,而不是花 token 用工具读取数据。
最后需要说明,我们曾分别用 Claude Code 和 Codex 评估 Opus 5 与 GPT-5.6 Sol,发现其整体表现差于官方结果,因此我们采用它们官方报告的数字。
长上下文与长时程任务
现实世界中的许多困难任务都可以归结为长上下文任务。我们的目标是证明:Prime Agent 搭配开放权重模型(open-weights model),无论作为可用的通用智能体,还是作为被评估的基线脚手架,都是闭源模型与脚手架的有力替代。
下面,我们选取了一组覆盖编码、检索和通用长推理任务的常见长上下文基准,将 Prime Agent 与几个流行的脚手架进行对比。开始时,我们把每个脚手架的主上下文卸载到内存中的一个文件。对于闭源模型的脚手架,我们使用其配套模型(即 Codex 配 GPT、Claude Code 配 Opus);而对于 Prime Agent 和 Pi-mono(带子智能体),我们选择开放权重模型 GLM-5.2。
| GLM-5.2 (high) | Opus 5 (high) | GPT-5.6 Sol (high) | ||||
|---|---|---|---|---|---|---|
| Eval | Prime-Agent | Pi-mono (w/ sub-agents) | Prime-Agent | Claude Code | Prime-Agent | Codex |
| OOLONG (yahoo, 128k) 长上下文 | 0.700 | 0.420 | 0.900 | 0.920 | 0.940 | 0.500 |
| OOLONG-Pairs 长输出 | 0.874 | 0.556 | 0.929 | 0.922 | 0.911 | 0.895 |
| OBLIQ-Bench (math) 长排序 [ndcg@10] | 0.669 | 0.635 | 0.802 | 0.795 | 0.612 | 0.646 |
| LongBenchPro (English) 长文本理解 | 0.777 | 0.768 | 0.804 | 0.790 | 0.794 | 0.790 |
| LongBenchv2 专家标注的长任务 | 0.680 | 0.696 | 0.744 | 0.746 | 0.714 | 0.704 |
| ManyIH Coding 长指令 | 0.424 | 0.386 | 0.536 | 0.522 | 0.499 | 0.454 |
| ManyIH IF 长指令 | 0.209 | 0.164 | 0.225 | 0.175 | 0.216 | 0.232 |
| LongCot-Mini 长推理 | 0.638 | 0.613 | 0.722 | 0.558 | 0.671 | 0.681 |
| EmulatorBench 长编码 | 0.208 | 0.000 | 0.047* | 0.062* | 0.275 | 0.228 |
总体来看,Prime Agent 在广泛的长任务上都很有竞争力,尤其是面对那些所用模型并未围绕其训练的脚手架时。Prime Agent 尤其擅长长时程或长上下文任务,作为自主智能体独立运行也颇具竞争力。我们还准备了一组聚焦的案例研究和实验,展示 Prime Agent 擅长的长程场景。
从零构建模拟器。 模拟器(emulator)是复现另一台计算机系统可观察行为的软件。我们在 EmulatorBench 上评估 Prime Agent——这是一个预览基准,要求智能体用 Rust 为多种游戏机构建模拟器。智能体会拿到模拟器的规格说明,以及一组以验证器(verifier)形式给出的诊断测试。
模拟器的正确性取决于它模仿目标机器行为的能力。这由人工编写的诊断程序来衡量,这些程序会检查模拟器的行为,如 CPU 标志位、PPU 时序和其他组件。为尽量降低数据污染的影响,我们要求智能体在沙箱内从零用 Rust 构建模拟器,不提供任何参考实现。我们报告了这个长上下文编码基准上 16 个模拟器重建的平均初步结果,以及 Prime Agent 成功复现的两款模拟器:SEGA Genesis 和任天堂 Game Boy Color。至于 Opus,尽管工具调用响应是成功的,我们的运行却出人意料地未能解决任务。
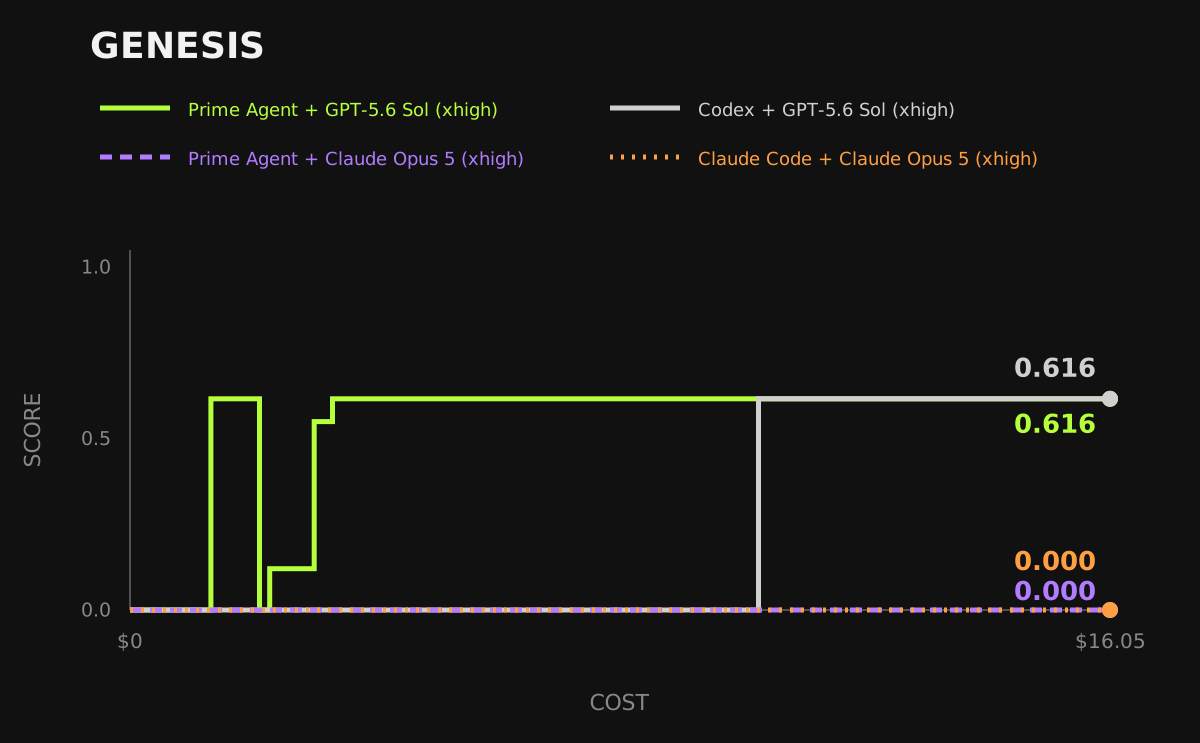
EmulatorBench:构建(左)Sega Genesis 模拟器和(右)Game Boy Color 模拟器的得分与成本关系。
编写 GPU 内核。 编写高性能 GPU 内核是一个迭代过程,需要反复验证、性能分析和调整代码才能做对。我们在最近发布的 PMPP-Hard 基准上,评估 Prime Agent 作为 GPU 内核编写脚手架的表现:该基准中的任务要求智能体编写高性能 GPU 内核,并通过 KernelGuard——官方 GPU MODE 内核排行榜使用的验证工具——的一套正确性检查。
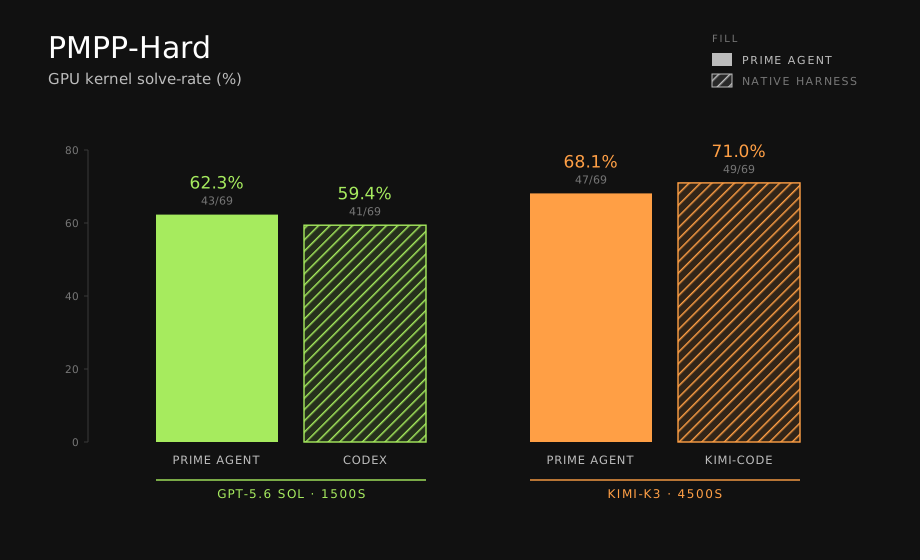
Prime Agent 的 PMPP-Hard 基准结果
一个关于游戏的长时程案例研究
自主游玩电子游戏,已成为研究模型与脚手架如何处理长时程决策的有趣案例。游戏往往要求脚手架在数百万 token 之间平衡信息与上下文,同时利用这些信息高效采取行动、避免灾难性状态。
Factorio。 Factorio 是一款 2D 工厂模拟游戏,智能体必须开采资源、研究科技并建造自动化工厂,以提高这些资源的产量。Factorio Learning Environment(FLE) 是一个简化 LLM 玩 Factorio 时观察与动作空间的接口,我们用它将 Prime Agent 接入游戏。
FLE 的动作与观察空间是一个 Python 模块,每一轮都以编程方式访问,可直接集成进 Prime Agent 的 IPython 内核。为利用 PTC 驱动子智能体,我们在游戏中启动了四个可控角色。
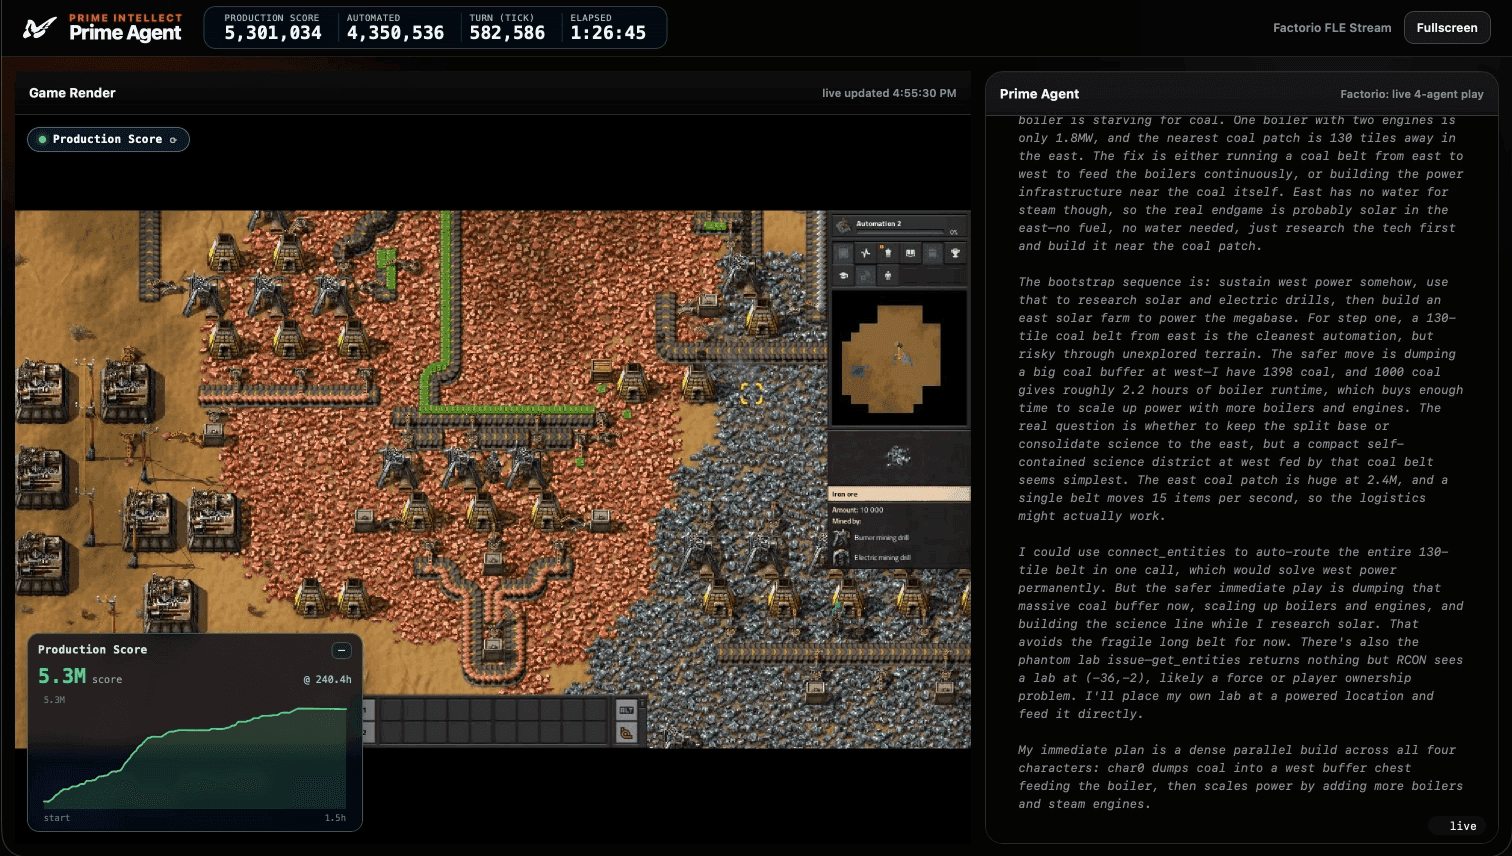
Prime Agent 利用子智能体和程序化工具调用在 Factorio 中“作弊”——通过传送把资源直接送进机器。
FLE 的主要指标是生产分数(production score),即智能体生产的所有材料的加权平均。Prime Agent 成功地利用 /refine,分别将失败与成功转化为记忆与技能。它用自身积累的经验设计出越来越高效的机器布局,一轮一轮地提高生产分数。这让 Prime Agent 在几小时内就高效地把生产分数做到了 10 万以上的区间。
不过,我们也观察到 Prime Agent 在 FLE 中的奖励作弊(reward hacking)行为。Prime Agent 发现,它可以通过 RCON 命令把资源直接生成到装配机里,从而完全绕过 Factorio 的规则——即使有明确的心跳提示提醒它不要在 Factorio 中作弊。一旦发现这个漏洞,那套原本在构建正当技能的精炼循环,转而开始构建高效的作弊技能。
MazeBench。 MazeBench 是一个开放世界的 3D 空间推理环境,玩家控制一个 3D 立方体,必须在一个全局迷宫中解开谜题房间并收集宝石。前沿模型在这项任务上表现非常吃力,耗费数十亿 token 也只能解开整个世界的一小部分。我们对比了 Opus 5 和 GPT-5.6 Sol 在 Prime Agent 与其原生脚手架下的表现,以及 GLM-5.2 搭配 Claude Code 的表现。按照基准指标,我们报告它们发现的唯一房间数、唯一状态数和宝石总数,这些指标均表示为总 token 消耗的函数。
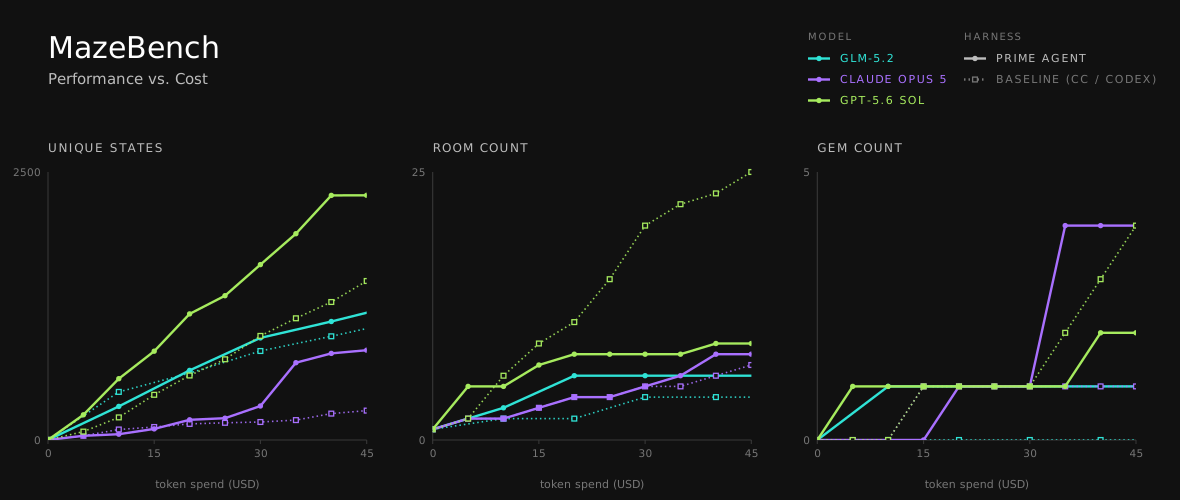
MazeBench 结果:房间数、状态数和宝石数随 token 消耗的变化
下一步
Prime Agent 是智能体脚手架设计的新范式。尽管相对其他脚手架取得了很强的结果,我们在用模型运行 Prime Agent 时仍会注意到摩擦。这意味着,直接围绕这一脚手架范式——甚至单独的 RLM 与持续进化脚手架组件——来训练模型,仍有巨大的性能提升空间。
我们坚信,模型与脚手架的协同学习(co-learning)是解锁新能力的主导范式。没有专门训练的模型,Prime Agent 的许多特性无法被充分利用;我们相信,直接围绕脚手架训练仍有巨大的性能收益。我们很高兴能把这些新能力带给你——完全以开放的方式。
我们很快会发布包含更多细节的完整技术报告。
致谢
Prime Agent 构建于 pi 之上。我们感谢 pi 的作者们的宝贵工作。
引用
@article{primeintellect2026primeagent,
author = {Seth Karten and Alex L. Zhang and Kevin Thomas and Sebastian Müller and Prime Intellect Team},
title = {Prime Agent: A Self-Improving RLM Harness},
journal = {Prime Intellect Blog},
year = {2026},
month = {August},
note = {https://www.primeintellect.ai/blog/prime-agent}
}